
Litterointi kertoo, mitä sanottiin. Haastatteluissa, kokouksissa ja podcasteissa työn toinen puoli on tietää, kuka sen sanoi. Puheteknologiassa tätä kutsutaan puhujien tunnistukseksi (diarisointi). Heinäkuusta 2026 alkaen Whisper Notes tunnistaa puhujat kokonaan laitteella sekä iPhonella että molemmissa Mac-versioissa.
Kerromme alla, miten se toimii ja miten se pärjäsi vertailutestissä pilvipalvelun tuottamaa vertailuaineistoa vastaan. Kerromme myös sen yhden ongelman, jota emme saaneet ratkaistua tekniikalla, ja mitä teimme sen sijaan.
Mitä se tekee
Avaa muistiinpano (äänite, tuotu ääni- tai videotiedosto tai kokouksen nauhoitus) ja napauta puhujapainiketta. Muutaman sekunnin kuluttua jokaisessa kappaleessa on puhujamerkintä ja aikaleima.
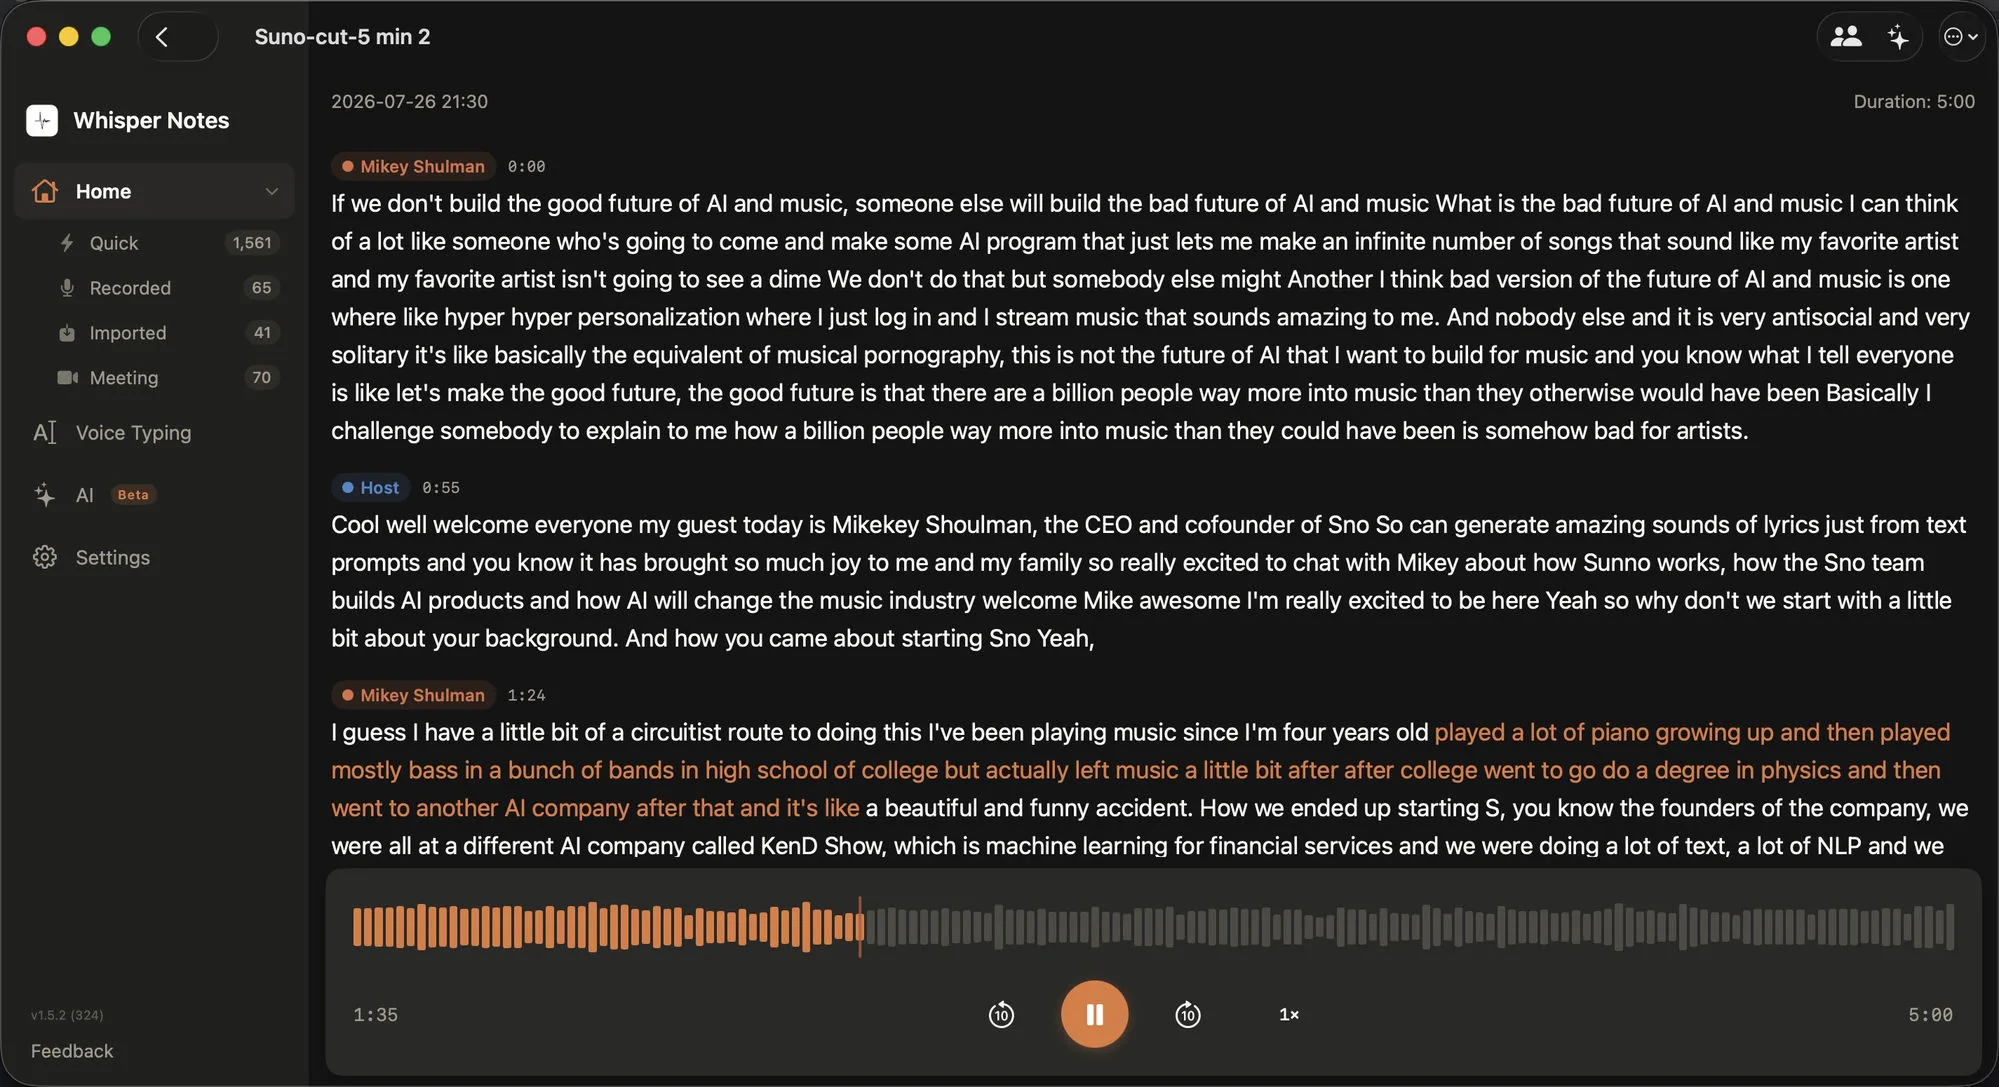
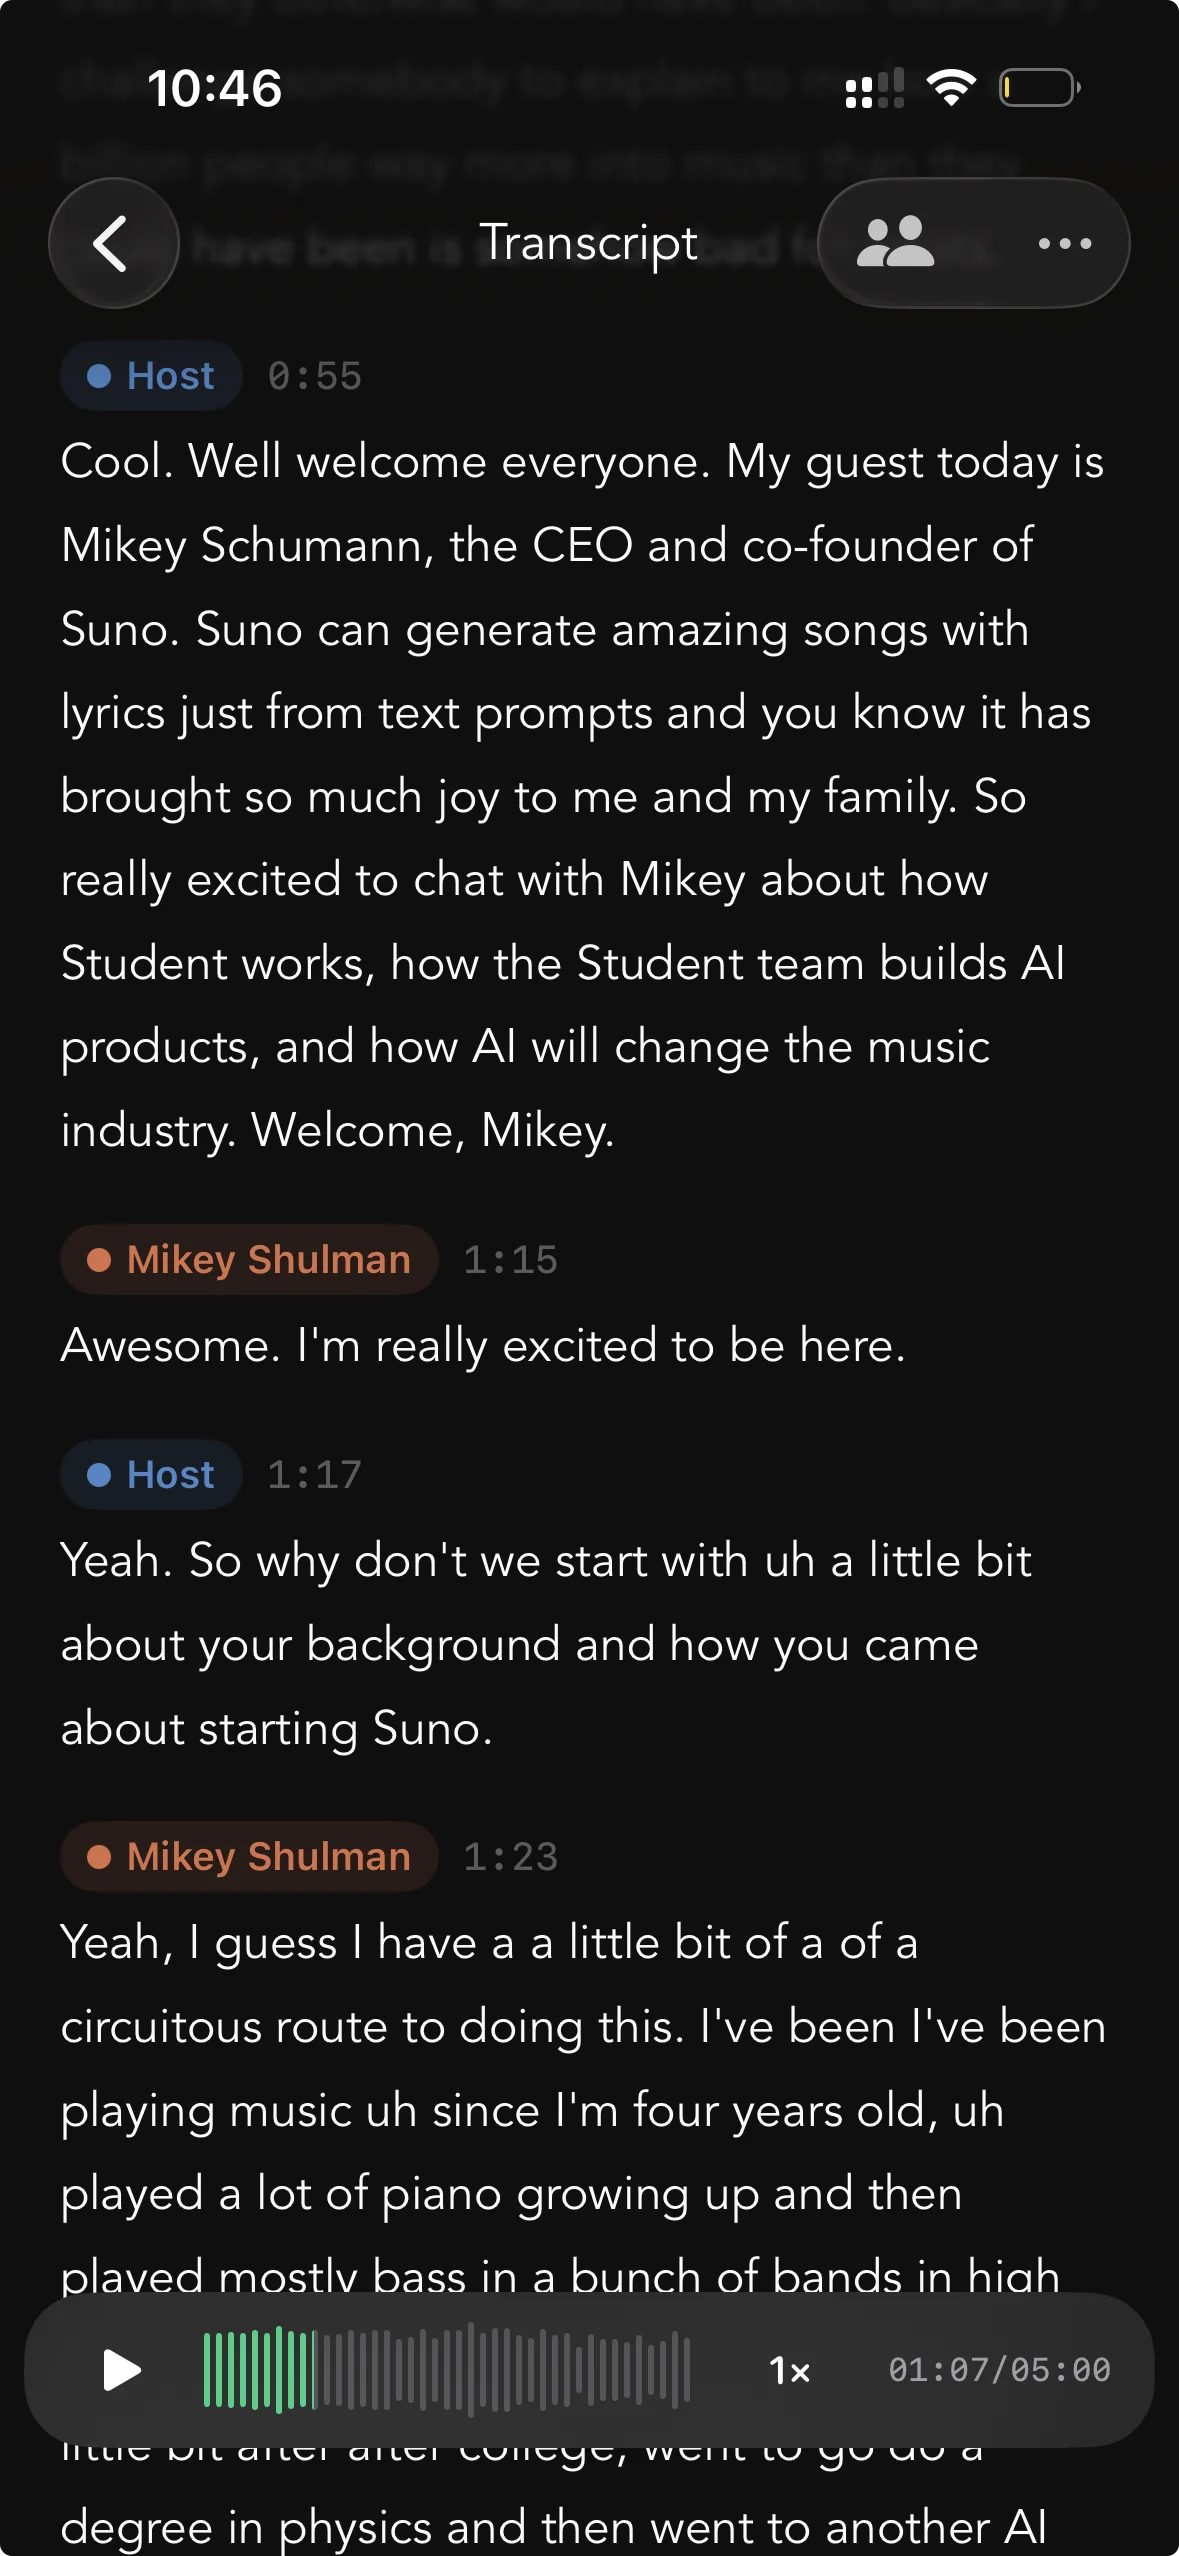
Puhujamerkinnät Macilla ja iPhonella. Lauseen napauttaminen siirtää toiston siihen kohtaan.
Merkinnät ovat aluksi Puhuja 1 ja Puhuja 2. Kun yhden puhujan nimeää uudelleen, nimi päivittyy koko litterointiin. Minkä tahansa lauseen napauttaminen siirtää äänen toiston täsmälleen siihen kohtaan, joten sitaatin voi helposti tarkistaa alkuperäisestä äänestä.
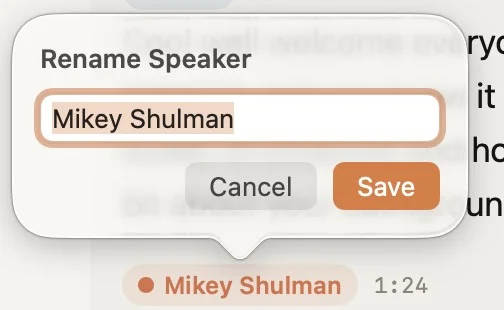
Kun puhujan nimeää uudelleen, muistiinpanon jokainen kappale päivittyy.
Kokousten nauhoituksissa puhujien tunnistus käynnistyy automaattisesti, kun puhelu päättyy (tämän voi kytkeä pois päältä Asetuksista). Merkinnät säilyvät viennissä: Kopioi litterointi puhujineen vie ne leikepöydälle, ja SRT- ja VTT-tiedostoissa ne siirtyvät tekstityksiin.
Puhujien tunnistus perustuu ääniin eikä sanoihin, joten se toimii samalla tavalla kaikilla yli 100 kielellä, jotka sovellus litteroi.
19 MB:n malli Neural Enginellä
Puhujien tunnistus vastaa kysymykseen ”kuka puhui milloin” kolmessa vaiheessa. Ensin ääni pilkotaan jaksoihin, joissa on puhetta. Sitten jokaisesta jaksosta lasketaan äänijälki: tiivis vektori, joka kuvaa itse ääntä eikä sanoja. Lopuksi äänijäljet ryhmitellään, ja samaan ryhmään päätyvät jaksot saavat saman merkinnän.
Whisper Notes käyttää pyannote-projektin community-1-putkea. Se on muunnettu Core ML -muotoon, jotta molemmat vaiheet toimivat Neural Enginellä. Kertaluonteinen lataus on 19 MB, ja 5,7 minuutin keskustelun käsittely kestää M-sarjan Macilla 2–4 sekuntia.
Ääni → puhejaksot → äänijäljet → ryhmät → merkinnät
Jokainen vaihe tapahtuu laitteella.
Puhujien tunnistuksessa tällä on vielä enemmän merkitystä kuin litteroinnissa. Äänijälki on biometrinen tieto: se tunnistaa ihmisen samaan tapaan kuin sormenjälki. Kun putki toimii paikallisesti, sinun, kollegoidesi ja haastateltaviesi äänijäljet lasketaan, ryhmitellään ja hävitetään laitteella. Niitä ei lähetetä minnekään.
Mitä mittasimme
Puhujien tunnistusta varten meillä on kiinteä kahden tiedoston vertailutesti. Vertailuaineisto on tuotettu pilvessä toimivalla puheentunnistus- ja puhujantunnistuspalvelulla (ElevenLabs) ja tarkistettu käsin. Pisteytyksessä jokainen 10 millisekunnin pätkä puhetta osoitetaan jollekin puhujalle, ja tuloksen ja vertailuaineiston välille haetaan paras vastaavuus. Kaksi tiedostoa on pieni testi, joten pidämme lukuja suuntaa antavina, emme lopullisina.
Ensimmäinen tiedosto edustaa tavallista tapausta: viiden minuutin englanninkielinen podcast, jossa on kaksi selvästi eri kuuloista puhujaa. Useimmat haastattelut, podcastit ja kahdenkeskiset palaverit ovat tällaisia.
| Kahden puhujan englanninkielinen podcast (5 min) | Tulos |
|---|---|
| Osuvuus kehystasolla (10 ms:n tarkkuus) | 96,7 % |
| Tarkkuus lausetasolla (se, mitä luet) | 99,1 % |
| Käsittelyaika, M-sarjan Neural Engine | 2–4 s |
Jäljelle jäävä 0,9 % koostuu kolmesta pienestä heitosta puhujanvaihdon kohdalla, yhteensä 3,4 sekuntia. Se on jo vertailuaineiston oman tarkkuuden rajoissa. Tällaisessa aineistossa laitteella saatu tulos vastaa pilvipalvelua, jolla vertailuaineisto tuotettiin.
Vaikea tapaus
Toinen tiedosto on tarkoituksella vaikea: kaksi samankaltaista miesääntä kaikuvassa huoneessa ja juontaja, joka puuttuu puheeseen 19 kertaa, keskimäärin 2,3 sekuntia kerrallaan. Vieras puhuu 272 sekuntia, juontaja 43. Juuri tällainen akustinen asetelma kaataa puhujien tunnistuksen millä tahansa kielellä: toistensa kaltaiset äänet ja lyhyet puheenvuorot.
Automaattinen ryhmittely romahtaa tässä. Kaksi äänijälkeä on niin lähellä toisiaan, että algoritmi yhdistää ne ja antaa lähes koko keskustelulle saman merkinnän. Äänite sattuu olemaan kiinalainen haastatteluohjelma, joten pystyimme testaamaan ilmeisen hypoteesin: toimisiko kieleen erikoistunut malli paremmin? Ajoimme CPU-putken läpi kaksi puhujamallia, jotka on koulutettu nimenomaan kiinankielisellä puheella:
| Malli | Englanninkielinen podcast | Vaikea tapaus* | Aika (5,7 min ääntä) |
|---|---|---|---|
| pyannote community-1 (käytössämme, Neural Engine) | 96,7 % | 81–82 % | 2–4 s |
| CAM++ (koulutettu kiinalla, CPU) | 93,9 % | 81,2 % | 36–103 s |
| ERes2NetV2 (koulutettu kiinalla, CPU) | — | 80,5 % | 220–290 s |
* Osuvuus kehystasolla vaikeassa tiedostossa, kun puhujien määrä on annettu. Ilman sitä jokainen malli romahtaa kohti yhtä puhujaa.
Molemmat romahtavat samalla tavalla, vaikka laskentaa kuluu 10–100 kertaa enemmän. Vaikeus on akustinen, ei kielellinen: raja on siinä, mitä nykyiset ääniupotukset pystyvät erottamaan, kielestä riippumatta.
Tämä sulki pois ilmeisen korjauksen ja ohjasi toisenlaiseen ratkaisuun: annetaan putkelle tieto, jota se ei pysty itse päättelemään, eli huoneessa olevien ihmisten määrä. Kun määrä annetaan (valikosta, enintään 10 puhujaa), vaikea tiedosto nousee romahduksesta 89 %:n tarkkuuteen lausetasolla. Automaattinen tunnistus on edelleen oletus, koska se osuu oikeaan tavallisessa aineistossa.
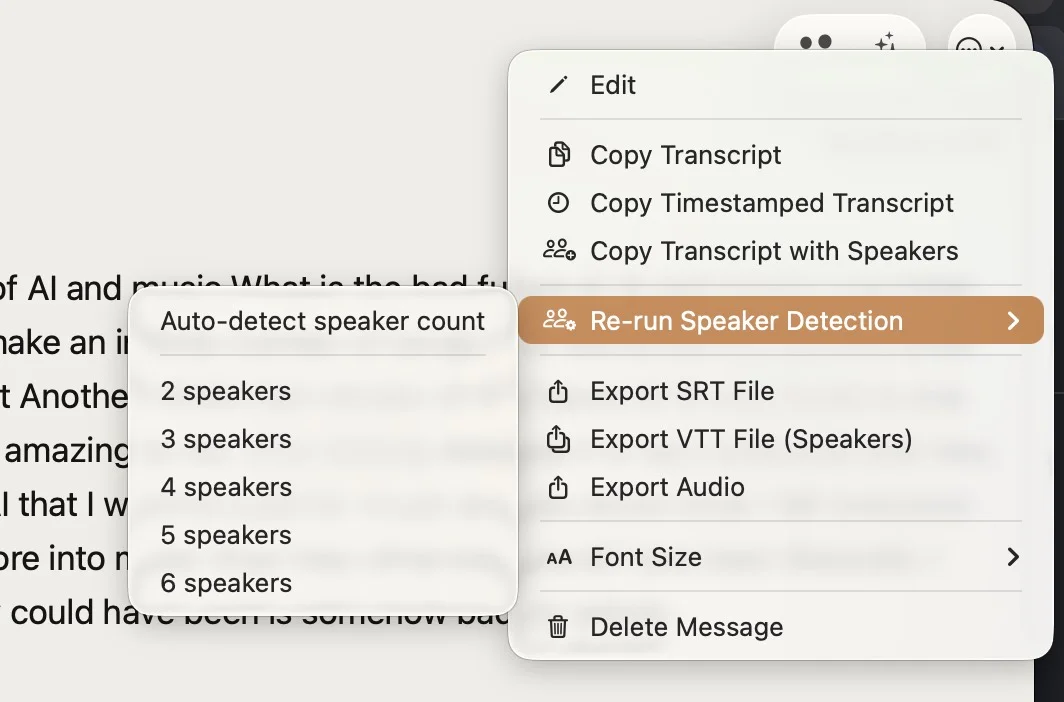
Puhujien tunnistus uudelleen tarkalla puhujamäärällä. Samasta valikosta voi viedä SRT- ja VTT-tiedostot puhujamerkinnöin.
Lyhyiden välihuomautusten tarkentaminen
Kun puhujamäärä oli kiinnitetty, noin puolet jäljelle jääneistä virheistä osui alle kolmen sekunnin välihuomautuksiin. Kahden sekunnin pätkästä upotusmalli saa hyvin vähän signaalia, ja nopeissa vuoronvaihdoissa sen äänijälkeen sekoittuu osa viereisen puhujan äänestä.
Siksi putki käy ryhmittelyn jälkeen uudelleen läpi jokaisen alle 3,5 sekunnin lauseen. Se laskee äänijäljen uudelleen maskilla, joka rajaa täsmälleen kyseisen lauseen kehykset, ja vertaa sitä kunkin puhujan ankkuriin eli puhujan pisimpien puheenvuorojen keskiarvoon. Merkintä vaihdetaan vain, jos ero on selvä. Tähän käytetään samaa mallia, eikä mitään tarvitse ladata lisää.
| Tarkkuus lausetasolla, koko ketju | Ennen tarkennusta | Jälkeen |
|---|---|---|
| Vaikea tapaus (puhujamäärä annettu) | 89,0 % | 94,8 % |
| Englanninkielinen podcast (automaattinen) | 98,5 % | 99,1 % |
Eron kynnysarvo on varovainen: molemmissa tiedostoissa tarkennus vaihtoi 21 merkintää eikä tuonut yhtään uutta virhettä.
Rajoitukset
• Merkinnät ilmestyvät nauhoituksen päätyttyä, eivät puhelun aikana. Jos tarvitset reaaliaikaisen tekstityksen puhujien nimineen kokouksen vielä ollessa käynnissä, pilvipalvelu kuten Otter tai Notta on oikea työkalu.
• Päällekkäinen puhe saa yhden merkinnän lausetta kohden.
• Samankaltaiset äänet ovat yhä vaikeita. Vaikean tiedostomme 94,8 % on paras tulos, johon nyt pääsemme, kun puhujamäärä annetaan. Ongelma ei ole ratkaistu.
Saatavuus
Puhujien tunnistus sisältyy kertaostoon ($7.99 iPhonella, $14 Macilla) puheentunnistusmoottorien lisäksi: Parakeet (Moondreamin Parakeet Ultra, joka on jatkokoulutettu NVIDIAn Parakeet V3:n pohjalta), Whisper (Macilla Large V3 Turbo, iPhonella Small), SenseVoice sekä Apple Speech iOS 26:ssa ja macOS 26:ssa. Macilla on lisäksi Qwen3-ASR 1.7B (Beta). Erillistä hintatasoa tai käyttäjätiliä ei ole.
• iPhone: App Storesta.
• Mac App Store: sisältyy nykyiseen versioon.
• Verkkosivuiltamme ladattava Mac-sovellus: Macin lataussivulta. Sillä voi litteroida 5 000 sanaa viikossa ilmaiseksi.
 Lataa iOS:lle
Miten itse kokouksen nauhoitus toimii, kerrotaan kokousten offline-litterointia käsittelevässä artikkelissamme.