Mistral lanzó Voxtral, su primera familia de modelos con pesos abiertos para transcripción y comprensión de audio. Los benchmarks oficiales muestran un reconocimiento de voz multilingüe sólido y capacidad de responder preguntas sobre audio, aunque los dos tamaños del modelo tienen requisitos de hardware muy diferentes. Aquí te explicamos qué soporta realmente este lanzamiento y por qué Whisper Notes sigue apostando por modelos más chicos, enfocados en transcripción, sobre hardware Apple de consumo.
Dos modelos
En julio de 2025, Mistral liberó dos checkpoints bajo licencia Apache 2.0:
Voxtral Small 24B
- •24 mil millones de parámetros
- •Transcripción, traducción, preguntas sobre audio y resúmenes
- •Ventana de contexto de 32k
- •Alrededor de 55 GB de RAM de GPU en bf16/fp16
Voxtral Mini 3B
- •3 mil millones de parámetros
- •La misma familia de tareas de audio y texto en un checkpoint más compacto
- •Posicionado oficialmente para despliegue local y en el edge
- •Alrededor de 9.5 GB de RAM de GPU en bf16/fp16
Pesos abiertos y licencia
Ambos checkpoints de 2025 tienen pesos abiertos bajo licencia Apache 2.0. Puedes descargarlos y correrlos por tu cuenta:
- ✓ Pesos completos del modelo disponibles
- ✓ Hospédalos tú mismo o adáptalos dentro de lo que permite la licencia Apache 2.0
- ✓ No pagas la API de Mistral si los hospedas tú; el cómputo sigue corriendo por tu cuenta
- ✓ Procesa el audio en tus propios servidores
Fuentes: el anuncio de Voxtral de Mistral, la tarjeta oficial del modelo Voxtral Small y la tarjeta oficial del modelo Voxtral Mini.
Benchmarks
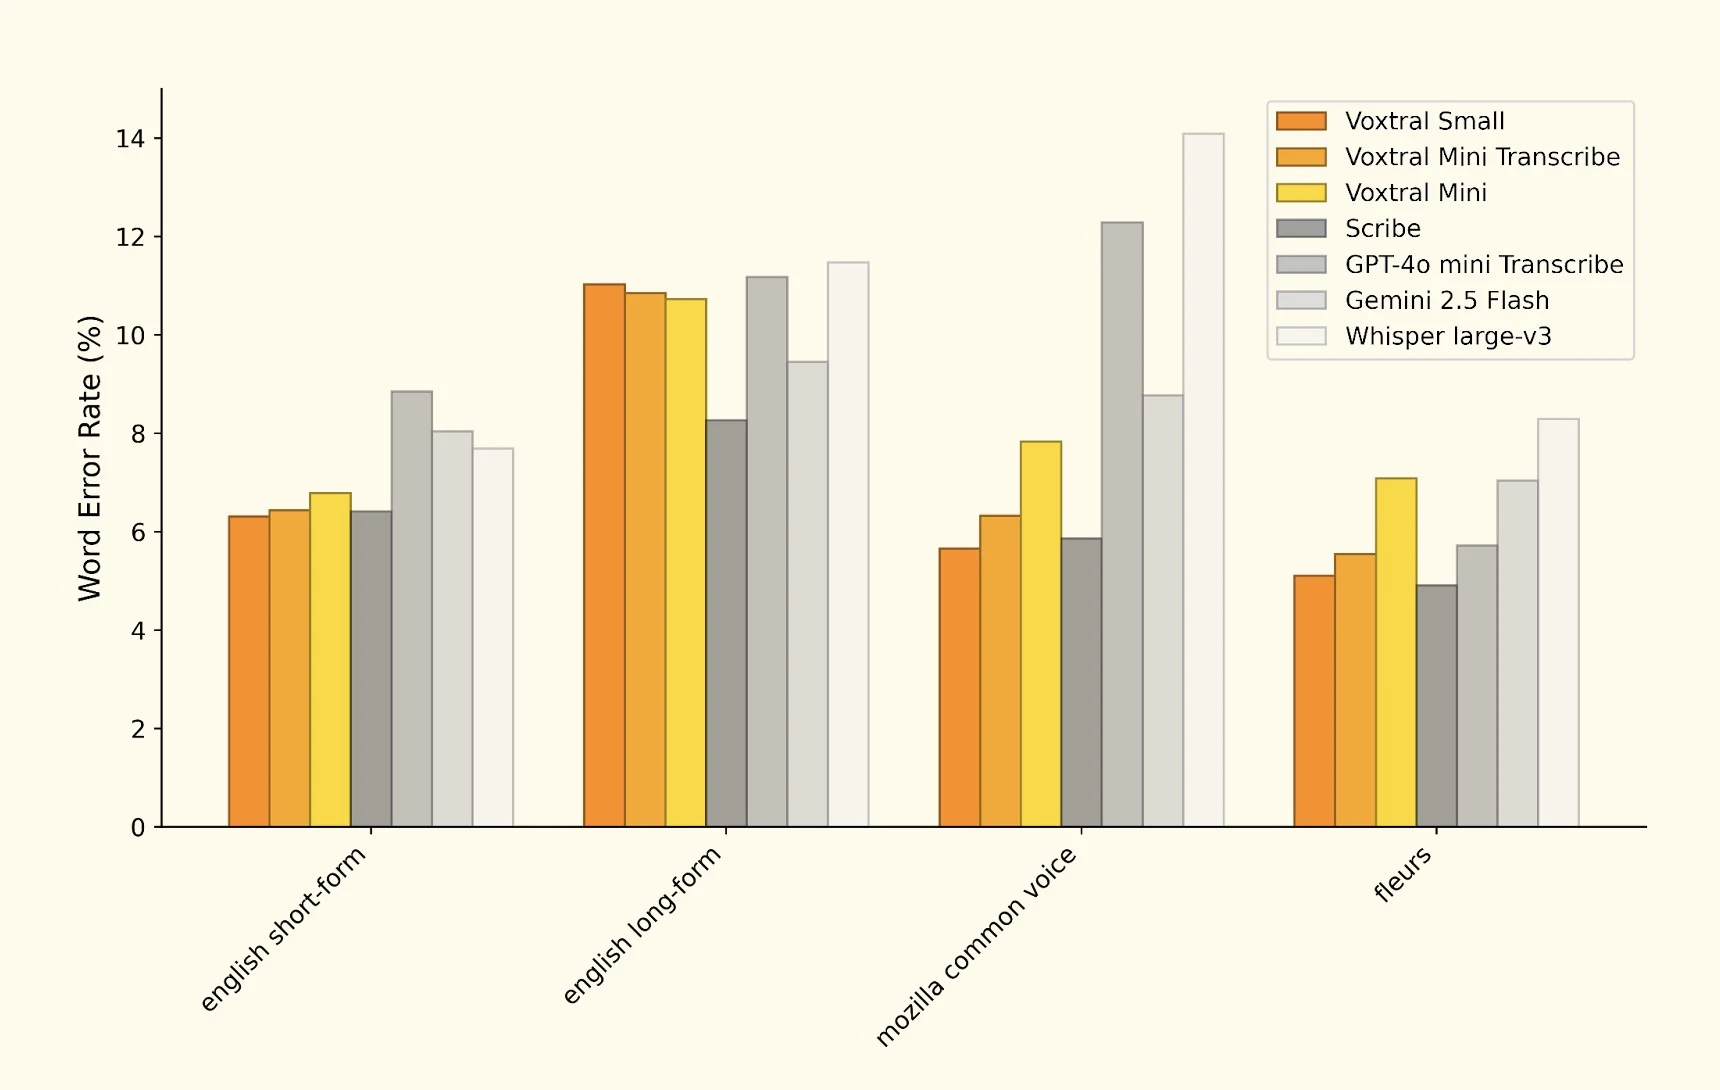
El lanzamiento de Mistral compara la tasa de error de palabra (WER) macro-promedio en conjuntos de inglés de formato corto y largo, Mozilla Common Voice, FLEURS y Multilingual LibriSpeech. En los resultados de FLEURS que reporta Mistral, Voxtral Small le gana a Whisper en cada tarea evaluada. Un WER más bajo es mejor:
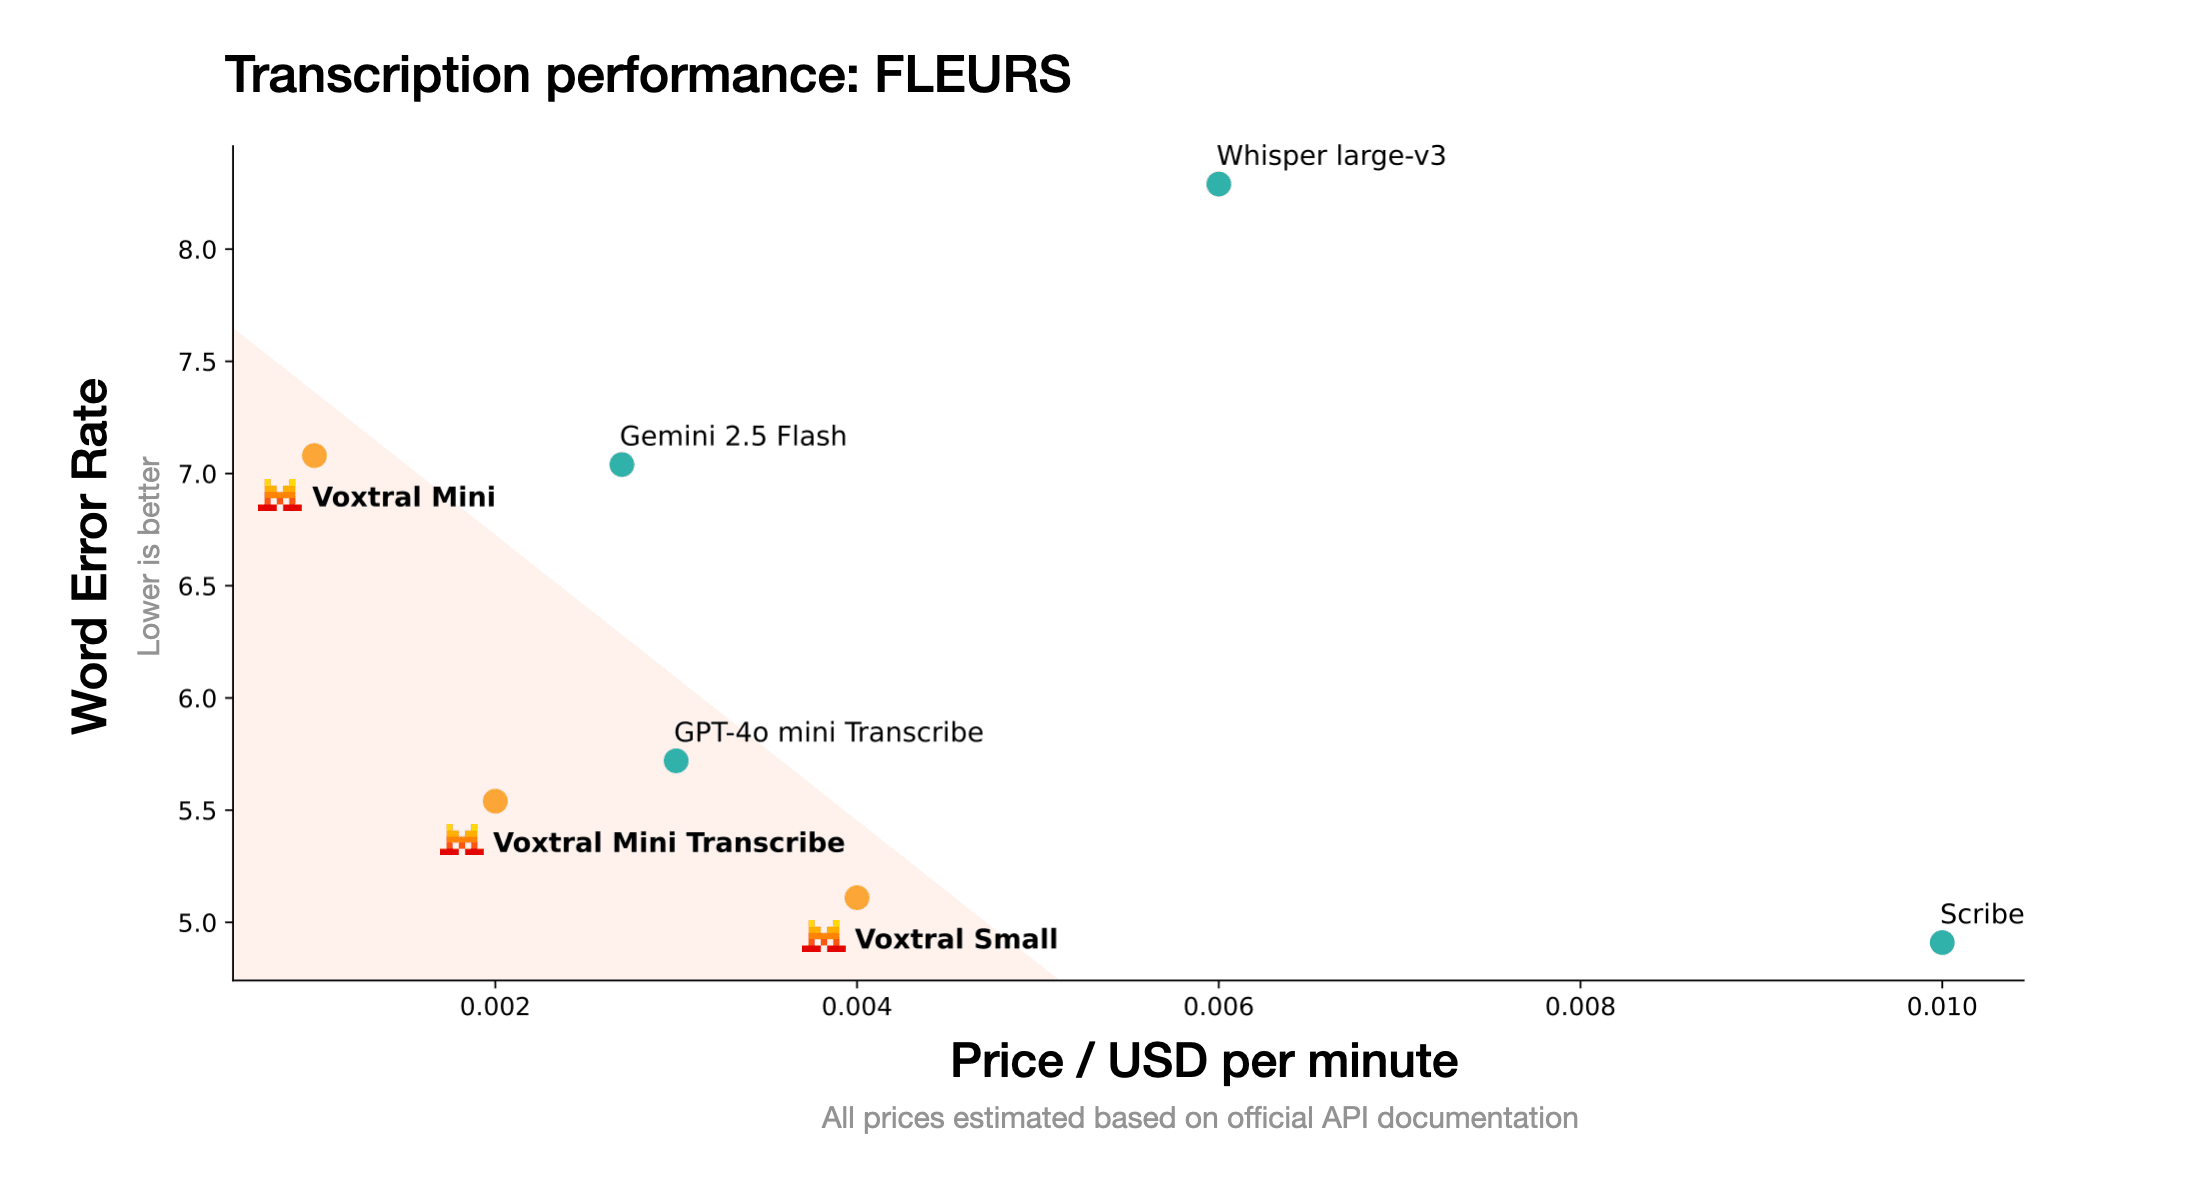
WER en FLEURS de los benchmarks de lanzamiento de Mistral graficado contra el precio estimado de la API; tanto los resultados como los precios pueden cambiar
FLEURS es apenas una rebanada de la calidad de transcripción. Son resultados reportados por el propio proveedor, así que revisa las definiciones publicadas de cada benchmark y prueba con tus propios idiomas, micrófonos y condiciones de grabación antes de decidirte por un modelo.
Voxtral vs Whisper: ¿cuál te conviene?
Los benchmarks solo cuentan una parte de la historia. Así se comparan las dos familias de modelos en los factores que de verdad importan si quieres correr uno por tu cuenta:
| Voxtral Small | Voxtral Mini | Whisper Large v3 | Whisper Large-v3 Turbo | |
|---|---|---|---|---|
| Idiomas | 8 idiomas principales | 8 idiomas principales | 100+ | 100+ |
| Código abierto | Sí | Sí | Sí | Sí |
| Tamaño del modelo | 24B parámetros; ~55 GB de RAM de GPU en bf16/fp16 | 3B parámetros; ~9.5 GB de RAM de GPU en bf16/fp16 | 1.55B parámetros | 809M parámetros (~1.6 GB) |
| Práctico en una Mac de consumo | No en precisión completa en hardware típico | Posible con un runtime compatible; más pesado que Turbo | Sí | Sí |
El veredicto: Voxtral Small reporta buenos resultados de WER y suma comprensión de audio, algo que Whisper ni intenta. Voxtral Mini es el checkpoint que Mistral posiciona para despliegue local y en el edge, pero su tarjeta oficial de modelo sigue listando alrededor de 9.5 GB de RAM de GPU en bf16/fp16. Para una app de transcripción de consumo, Whisper Large-v3 Turbo sigue siendo más fácil de distribuir y cubre muchos más idiomas. Por eso Whisper Notes hoy combina Whisper Turbo con Parakeet V3 y SenseVoice en lugar de Voxtral.
Costo de la API y de hospedarlo tú mismo
Con datos verificados el 10 de julio de 2026, la tarjeta del modelo de Mistral lista la entrada de audio de Voxtral Small en $0.004 por minuto. La entrada de texto y el texto generado se cobran por separado en las solicitudes de comprensión de audio. Si hospedas tú mismo los pesos Apache 2.0, no hay cargo por la API de Mistral, pero el hardware y la operación corren por tu cuenta.
API de Mistral
Pesos hospedados por ti
Cómo funciona
La tarjeta oficial del modelo describe Voxtral como un modelo de lenguaje con un codificador de audio y un modo dedicado de transcripción. Los límites de producto que importan son concretos:
1. Arquitectura multimodal
Voxtral acepta audio y texto en la misma conversación, en lugar de comportarse solo como un decodificador de voz a texto:
- •Modo dedicado para transcripción directa
- •Preguntas sobre audio y resúmenes estructurados
- •Varias entradas de audio y conversaciones de audio de múltiples turnos
Límite de formato largo
La ventana de contexto de 32k soporta hasta 30 minutos de audio para transcripción o 40 minutos para comprensión de audio más amplia.
2. Idiomas y evaluación
Mistral lista ocho idiomas principales con detección automática:
- •Inglés, español, francés, portugués, hindi, alemán, neerlandés e italiano
- •Los benchmarks incluyen FLEURS, Mozilla Common Voice y Multilingual LibriSpeech
- •El lanzamiento también evalúa por separado el audio en inglés de formato corto y largo
3. Requisitos de despliegue
Que los pesos sean abiertos no significa que cada checkpoint quepa en cualquier dispositivo:
- •Voxtral Small requiere alrededor de 55 GB de RAM de GPU en bf16/fp16 según su tarjeta de modelo
- •Voxtral Mini es el checkpoint de 3B pensado para despliegue local y en el edge
- •Mistral recomienda vLLM para servir los checkpoints liberados
4. Funciones clave
Comprensión contextual
Puede responder preguntas y producir resúmenes directamente desde el audio, dentro del límite de contexto de 32k.
Multilingüe
Detecta y transcribe automáticamente ocho idiomas principales: inglés, español, francés, portugués, hindi, alemán, neerlandés e italiano.
Manejo de ruido
La evaluación oficial incluye datasets de voz variados, pero Mistral no publica una garantía absoluta para cualquier grabación con ruido.
Despliegue en el edge
Voxtral Mini es la opción local y de edge. Su tarjeta oficial de modelo lista alrededor de 9.5 GB de RAM de GPU en bf16/fp16.
5. Arquitectura
Tres componentes principales:
- 1. Codificador de audio: Convierte la forma de onda en representaciones de audio aprendidas
- 2. Proyector: Mapea las representaciones de audio al espacio oculto del modelo de lenguaje
- 3. Backbone de modelo de lenguaje: Genera transcripciones, respuestas, resúmenes o llamadas a herramientas
Ese diseño explica por qué Voxtral puede hacer más que transcribir, pero también implica cargar pesos de modelo de lenguaje mucho más grandes que los de un modelo dedicado solo a transcripción como Whisper Turbo.
Por qué Whisper Notes sigue teniendo sentido
Voxtral y Whisper Notes resuelven problemas diferentes. Voxtral combina transcripción con comprensión de audio; Whisper Notes se enfoca en transcripción privada, fácil de correr en hardware Apple de consumo.
Qué te ofrece Whisper Notes
Privacidad
- •Procesamiento 100% offline
- •Cero transmisión de datos
- •Cero dependencias de la nube
Rendimiento
- •Tecnología Whisper, precisión comprobada
- •Optimizado para Apple Silicon
- •Resultados confiables
Costo
- •compra única; precio indicado en el canal de compra; la Mac incluye una prueba de 5,000 palabras
- •Sin cobros por minuto
- •Transcripción ilimitada
Experiencia de usuario
- •Interfaz simple
- •Actualizaciones constantes
- •Mejoras continuas
Requisitos de almacenamiento
Voxtral Small es un modelo de clase servidor en precisión completa: su tarjeta oficial lista alrededor de 55 GB de RAM de GPU. Voxtral Mini está pensado específicamente para uso local y en el edge, pero su tarjeta aún lista alrededor de 9.5 GB de RAM de GPU en bf16/fp16. La descarga de Whisper Turbo dentro de la app es de aproximadamente 1.6 GB, lo cual encaja mucho mejor con el producto actual de Whisper Notes.
Whisper Notes usa Whisper Large-v3 Turbo: balancea rendimiento, velocidad y requisitos de VRAM para el uso diario. Vamos a migrar a mejores modelos cuando estén disponibles con requisitos de recursos razonables.
Voxtral es atractivo cuando lo que importa son las preguntas sobre audio, los resúmenes o el despliegue en tus propios servidores. Whisper Notes está pensado para usuarios individuales que quieren transcripción privada y cero suscripciones recurrentes.
Qué significa esto
Voxtral es un paso importante en pesos abiertos más allá del simple reconocimiento de voz, porque puede razonar sobre el audio además de transcribirlo.
Para transcripción privada offline en Mac y iPhone, los motores especializados más chicos siguen siendo más fáciles de empaquetar y de correr de manera consistente.
¿Estás comparando todas las opciones locales? Cada modelo de voz a texto en el dispositivo — las variantes de Whisper, Parakeet V3, SenseVoice y Voxtral — está comparado lado a lado en nuestra página de comparación de modelos Whisper.
Preguntas frecuentes
¿Qué es Mistral Voxtral?
Voxtral es la familia de modelos con pesos abiertos de Mistral para transcripción de voz y comprensión de audio. El lanzamiento de julio de 2025 incluye Voxtral Small 24B para cargas de trabajo de clase servidor y Voxtral Mini 3B para despliegue local y en el edge. Ambos checkpoints usan la licencia Apache 2.0.
¿Voxtral puede correr localmente en una Mac?
Los pesos descargables se pueden hospedar por tu cuenta, pero los dos tamaños tienen requisitos distintos. Voxtral Small necesita alrededor de 55 GB de RAM de GPU en bf16/fp16, así que es una opción de clase servidor. Voxtral Mini es el checkpoint local y de edge; su tarjeta de modelo lista alrededor de 9.5 GB en bf16/fp16, y la velocidad y el uso de memoria reales en una Mac dependen del runtime y de la cuantización.
¿Whisper Notes usa Voxtral?
No. Whisper Notes corre Parakeet V3 (el modelo predeterminado en Mac), Whisper Large-v3 Turbo y SenseVoice: modelos elegidos porque balancean rendimiento, velocidad y requisitos de VRAM para el uso diario en Apple Silicon. Adoptaremos mejores modelos en cuanto sea práctico correrlos en hardware de consumo.
¿Cuántos idiomas soporta Voxtral?
Las tarjetas oficiales del modelo listan ocho idiomas principales con detección automática: inglés, español, francés, portugués, hindi, alemán, neerlandés e italiano. Mistral también evalúa el árabe en FLEURS, pero no está incluido en la lista de idiomas principales de la tarjeta del modelo.
¿Cuándo se lanzó Mistral Voxtral?
Mistral lanzó Voxtral el 15 de julio de 2025. Los checkpoints iniciales con licencia Apache 2.0 fueron Voxtral Small 24B y Voxtral Mini 3B.
 Descargar para iOS