Od macOS 26 i iOS 26 Apple dostarcza nową generację rozpoznawania mowy na urządzeniu — SpeechAnalyzer i SpeechTranscriber, dalej w skrócie Apple Speech. Jest ona wyraźnie dokładniejsza od starego silnika dyktowania. Chcieliśmy sprawdzić, jak w praktyce wypada na tle pobieranych przez użytkowników, działających na urządzeniu otwartych modeli — Whisper, Parakeet, Qwen3-ASR i SenseVoice: czy wbudowane rozpoznawanie mowy Apple jest już na tyle dobre, że można całkiem zrezygnować z aplikacji do transkrypcji?
O ile jest lepszy od dyktowania, które już miałeś?
Do tej pory za rozpoznawanie mowy na Macu odpowiadał silnik z epoki SFSpeechRecognizer — ten sam, z którego nadal korzysta systemowe dyktowanie (DictationTranscriber). W macOS 26 i iOS 26 pojawił się interfejs API SpeechAnalyzer oraz jego moduł SpeechTranscriber. Na tym samym Macu uruchomiliśmy oba silniki na części testowej FLEURS — około 150 zdań i 30 minut na język.
| Język | Dyktowanie Apple | Apple Speech |
|---|---|---|
| Koreański | 7,11 | 4,31 |
| Włoski | 6,93 | 4,39 |
| Hiszpański (Ameryka Łacińska) | 8,43 | 5,41 |
| Niemiecki | 12,69 | 6,26 |
| Japoński | 9,37 | 6,36 |
| Francuski | 17,10 | 7,61 |
| Chiński | 10,28 | 7,97 |
| Kantoński | 10,18 | 8,69 |
| Angielski | 13,83 | 8,80 |
| Portugalski (Brazylia) | 10,85 | 9,35 |
Wszystkie języki zmierzone poprawnie przez oba silniki Apple, uporządkowane według współczynnika błędów Apple Speech; zielony oznacza lepszą wartość w wierszu. Ten sam przebieg, te same nagrania, ten sam Mac. CER dla japońskiego, koreańskiego, chińskiego i kantońskiego, WER dla pozostałych.
Apple Speech jest dokładniejszy we wszystkich dziesięciu językach zmierzonych poprawnie przez oba silniki. W przypadku francuskiego i niemieckiego liczba błędów spada o ponad połowę, dla języka medianowego o około jedną trzecią, a dla brazylijskiego portugalskiego i kantońskiego o mniej więcej jeden błąd na siedem.
Dyktowanie nadal obsługuje więcej języków. W tym teście Apple Speech zwrócił wyniki dla 21 z 83 konfiguracji językowych, a dyktowanie dla 33. Wśród nich są trzy języki, których nowy silnik tu nie obsłużył: niderlandzki, polski i rosyjski, z wynikami 17,34, 13,50 i 13,13. Nie ma też jednej stałej listy, którą można by przytoczyć. Zasoby językowe należą do macOS, więc aplikacja podczas działania pyta system, co jest dostępne na danym Macu.
Czy zatem możesz pominąć pobierane modele?
Sześć silników, te same nagrania, jeden Mac. Poniżej przedstawiamy dziesięć spośród najczęściej używanych języków, w stałej kolejności niezwiązanej z wynikami.
| Język | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Angielski | 8,80 | 4,49 | 5,49 | 7,04 | 6,89 | 8,46 |
| Niemiecki | 6,26 | 2,85 | 4,05 | 8,67 | 6,26 | — |
| Niderlandzki | — | 7,36 | 5,69 | 16,75 | 8,58 | — |
| Rosyjski | — | 5,65 | 5,13 | 11,37 | 7,12 | — |
| Polski | — | 12,59 | 5,45 | 15,81 | 8,30 | — |
| Japoński | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Koreański | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Francuski | 7,61 | 4,57 | 5,97 | 13,24 | 5,83 | — |
| Chiński | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Hiszpański (Ameryka Łacińska) | 5,41 | 3,38 | 3,62 | 6,22 | 4,86 | — |
Dziesięć spośród najczęściej używanych języków, jeden silnik w każdej kolumnie. Każda komórka pokazuje współczynnik błędów danego silnika — im niżej, tym lepiej; zielony oznacza najniższy wynik w wierszu, biały drugi najniższy. CER dla japońskiego, koreańskiego i chińskiego, WER dla pozostałych; nigdy nie łączymy ich w jedną liczbę. Nasz własny przebieg FLEURS, wykonany przez zespół Whisper Notes, na jednym M5 MacBook Air, mowa czytana.
Nazwy skrócone: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Kreska oznacza, że silnik nie ma modelu dla danego języka.
Qwen3-ASR 1.7B ma najniższy współczynnik błędów w sześciu z dziesięciu języków, a Whisper Large V3 Turbo w pozostałych czterech; Apple Speech nie prowadzi w żadnym. Najbardziej zbliża się do lidera w koreańskim — traci 0,77 punktu — następnie w japońskim, gdzie traci 1,06, i chińskim, gdzie strata wynosi 1,48, a wynik 7,97 dorównuje Whisper Large V3 Turbo. Największą stratę ma w angielskim: 8,80 (Apple Speech) wobec 4,49 (Qwen3-ASR 1.7B). Dla niderlandzkiego, polskiego i rosyjskiego Apple Speech nie zwrócił żadnego wyniku.
W porównaniu z Whisper Small Apple Speech był dokładniejszy w ośmiu z dziesięciu języków zmierzonych poprawnie przez oba silniki. Przegrał w dwóch: angielskim, 8,80 (Apple Speech) wobec 7,04 (Whisper Small), oraz brazylijskim portugalskim, 9,35 wobec 8,61.
Benchmark opublikowany w lipcu porównywał Apple Speech z Whisper Small w języku angielskim i wskazał przewagę Apple. Znaczenie ma zarówno to, który wariant Whisper bierze udział w porównaniu, jak i użyte nagrania. Tamten test korzystał z LibriSpeech — narratorów audiobooków czytających na głos; nasz korzysta z FLEURS — wielu różnych osób czytających zdania z Wikipedii. Nasz test pokazuje różnicę w angielskim, ale nie pozwala określić jej przyczyny.
W porównaniu z Whisper Large V3 Turbo kolejność się odwraca. Apple Speech przegrywa w ośmiu z tych dziesięciu języków, remisuje w chińskim z wynikiem 7,97 i prowadzi tylko w kantońskim: 8,69 (Apple Speech) wobec 36,75 (Whisper Large V3 Turbo) — zobacz wiersz kantoński poniżej. W informacjach o wydaniu Turbo OpenAI wymienia kantoński wśród języków, w których model pogorszył się najbardziej, dlatego 36,75 to znana słabość Whisper, a nie osobliwość naszego testu.
W koreańskim Apple Speech popełnia błąd w mniej więcej jednym znaku na 23. Najdokładniejszy model w tym teście, Qwen3-ASR 1.7B, popełnia błąd w mniej więcej jednym znaku na 28: 4,31 (Apple Speech) wobec 3,54 (Qwen3-ASR 1.7B).
Parakeet V3 wymaga pobrania 465 MB i jest dokładniejszy w każdym europejskim języku obsługiwanym przez oba silniki: w angielskim 6,89 (Parakeet V3) wobec 8,80 (Apple Speech), we francuskim 5,83 wobec 7,61, w hiszpańskim 4,86 wobec 5,41, we włoskim 3,43 wobec 4,39, a w brazylijskim portugalskim 6,49 wobec 9,35. W niemieckim oba uzyskują 6,26. Nie obsługuje japońskiego, koreańskiego, chińskiego ani kantońskiego — w tych językach spośród tej dwójki dostępny jest tylko Apple Speech.
Wśród sześciu wierszy, w których prowadzi Qwen3-ASR 1.7B, są angielski, niemiecki, francuski i hiszpański.
SenseVoice Small jest tu najszybszym silnikiem — działa 162,3× szybciej niż w czasie rzeczywistym. W chińskim i angielskim jego wyniki są na podobnym poziomie co Apple Speech: 7,69 (SenseVoice Small) wobec 7,97 (Apple Speech) oraz 8,46 wobec 8,80. W koreańskim pozostaje daleko w tyle: 7,85 (SenseVoice Small) wobec 4,31 (Apple Speech).
Rozmiar i szybkość
| Silnik | Szybkość | Szczytowe zużycie pamięci | Pobieranie |
|---|---|---|---|
| SenseVoice Small | 162,3× szybciej niż w czasie rzeczywistym | 0,95 GiB | 827 MB |
| Parakeet V3 | 75,6× szybciej niż w czasie rzeczywistym | 0,09 GiB | 465 MB |
| Apple Speech | 30,8× szybciej niż w czasie rzeczywistym | nie podajemy | <5 MB |
| Qwen3-ASR 1.7B | 11,1× szybciej niż w czasie rzeczywistym | 2,43 GiB | około 2,5 GB |
| Whisper Small | 7,9× szybciej niż w czasie rzeczywistym | 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3,0× szybciej niż w czasie rzeczywistym | 1,87 GiB | około 1,6 GB |
Szybkość to mediana każdego silnika dla trzynastu języków poprawnie mierzonych w tym wpisie, z uwzględnieniem tylko tych, które uruchomił — przepustowość przetwarzania pojedynczych pozycji, pomiar diagnostyczny, a nie opóźnienie produktu. Szczytowe zużycie pamięci to maksimum grupy procesów w tym przebiegu. Apple Speech dekoduje wewnątrz usługi macOS, której nie posiada aplikacja wywołująca, więc żadna wartość nie znaczyłaby tam tego samego co dla pozostałych pięciu.
Apple Speech działał 30,8× szybciej niż w czasie rzeczywistym, za Parakeet V3 z wynikiem 75,6× i SenseVoice Small z wynikiem 162,3×. Jego pakiet językowy macOS pobiera raz i współdzielą go wszystkie aplikacje, więc nic nie jest przydzielane we własnym procesie aplikacji. Usługa wykonująca dekodowanie nadal korzysta z pamięci, ale nie potrafimy dokładnie przypisać jej zużycia, dlatego zamiast zera nie podajemy żadnej wartości.
Whisper Large V3 Turbo jest tu najwolniejszym silnikiem — działa 3,0× szybciej niż w czasie rzeczywistym — i ma najniższy współczynnik błędów w czterech z dziesięciu wierszy, zajmując około 1,6 GB na dysku. Qwen3-ASR 1.7B wygrywa w pozostałych sześciu, zajmuje około 2,5 GB na dysku, a jego szczytowe zużycie pamięci wynosi 2,43 GiB. Whisper Small przy rozmiarze 600 MB stanowi właściwe porównanie dla wbudowanego silnika.
W których językach Apple Speech wypada dobrze?
Język po języku:
- Angielski: niezbyt dobry wybór. Apple Speech uzyskał 8,80; Qwen3-ASR 1.7B (4,49) albo Whisper Large V3 Turbo (5,49) jest wyraźnie dokładniejszy.
- Niemiecki: niezbyt dobry wybór. Apple Speech uzyskał 6,26; Qwen3-ASR 1.7B (2,85) albo Whisper Large V3 Turbo (4,05) jest wyraźnie dokładniejszy.
- Niderlandzki, rosyjski i polski: Apple Speech nie ma modelu dla tych trzech języków. Whisper Large V3 Turbo był najdokładniejszy w każdym z nich: 5,69, 5,13 i 5,45.
- Japoński: nadaje się. Apple Speech uzyskał 6,36, za Whisper Large V3 Turbo z wynikiem 5,30.
- Koreański: nadaje się. Apple Speech uzyskał 4,31, za Qwen3-ASR 1.7B z wynikiem 3,54.
- Francuski: niezbyt dobry wybór. Apple Speech uzyskał 7,61; Qwen3-ASR 1.7B (4,57) albo Parakeet V3 (5,83) jest wyraźnie dokładniejszy.
- Chiński: nadaje się. Apple Speech uzyskał 7,97, tyle samo co Whisper Large V3 Turbo; najdokładniejszy był Qwen3-ASR 1.7B z wynikiem 6,49.
- Hiszpański: niezbyt dobry wybór. Apple Speech uzyskał 5,41; Qwen3-ASR 1.7B (3,38) albo Whisper Large V3 Turbo (3,62) jest wyraźnie dokładniejszy.
Pobierane modele nadal wygrywają pod względem dokładności: każdy wiersz głównej tabeli prowadzi Qwen3-ASR 1.7B albo Whisper Large V3 Turbo. Apple Speech jest realną opcją w koreańskim, japońskim i chińskim; w przypadku języków europejskich warto sięgnąć po Parakeet V3.
W Whisper Notes na Maca Parakeet V3 nadal jest domyślny. W aplikacji na Maca pobranej z naszej strony Apple Speech jest dostępny jako opcjonalny model w macOS 26 lub nowszym, a dany język pojawia się w aplikacji tylko wtedy, gdy macOS zgłasza jego obsługę na Twoim Macu.
Apple Speech to używana w tym wpisie skrócona nazwa SpeechTranscriber od Apple, API działającego na urządzeniu, które każda aplikacja na Maca może wywołać w macOS 26 lub nowszym. To silnik systemowy, a nie model do pobrania: Whisper Notes na Maca może z niego korzystać w wersji pobranej z naszej strony, z pakietem językowym dostarczanym przez macOS. Modele, które aplikacja pobiera sama, to nadal Whisper, Parakeet V3, SenseVoice i Qwen3-ASR w tej wersji oraz Whisper, Parakeet V3 i SenseVoice na iPhonie i w wersji z Mac App Store. Tabela według silników to nasza lista języków obsługiwanych przez Whisper, Parakeet V3 i SenseVoice.
Poza tymi dziesięcioma językami
| Język | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Włoski | 4,39 | 2,58 | 2,58 | 7,64 | 3,43 | — |
| Kantoński | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Portugalski (Brazylia) | 9,35 | 5,17 | 5,44 | 8,61 | 6,49 | — |
| Hindi | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Cztery kolejne języki z tego samego testu. Te same kolumny, kolory i skrócone nazwy co powyżej; CER dla kantońskiego, WER dla pozostałych.
Wynik Apple Speech dla hindi nie jest uwzględniony w rankingu tego wiersza z powodu opisanego poniżej. Współczynnik błędów może przekroczyć 100 %, ponieważ wstawienia również zwiększają licznik.
Wynik 4,39 (Apple Speech) plasuje włoski za remisem Qwen3-ASR 1.7B i Whisper Large V3 Turbo, które uzyskały po 2,58. Kantoński to jedyny język, w którym Apple Speech wyprzedził Whisper Large V3 Turbo: 8,69 (Apple Speech) wobec 36,75 (Whisper Large V3 Turbo); pierwszy był Qwen3-ASR 1.7B z wynikiem 6,44. W brazylijskim portugalskim 9,35 (Apple Speech) — to jeden z dwóch wierszy, w których prowadzi Whisper Small z wynikiem 8,61.
Hindi daje wynik innego rodzaju. Apple Speech zapisał wypowiedzi w hindi angielskimi literami, zamiast zapisać je znakami używanymi w hindi, dlatego niemal każde słowo jest liczone jako błędne, a współczynnik przekracza 100 %. Tak samo wyglądały wyniki dla telugu, urdu, pendżabskiego, bengalskiego, nepalskiego, malajalam, marathi, kannady, gudżarati i tamilskiego — wszystkie przekraczały 100 % — dlatego nie ma ich w tabeli.
Jak działa SpeechAnalyzer
SpeechAnalyzer zastępuje interfejs API rozpoznawania mowy, który Apple oferuje od iOS 10, na każdej platformie Apple poza watchOS. Aplikacja tworzy SpeechAnalyzer, dodaje do niego moduły i dostarcza mu dźwięk w postaci sekwencji asynchronicznej, którą sama wypełnia; SpeechTranscriber to moduł zamieniający mowę w tekst. Wyniki wracają jako druga sekwencja, zwykle w innym zadaniu, a każdy bufor i każdy wynik ma znacznik czasu względem osi czasu samego nagrania.
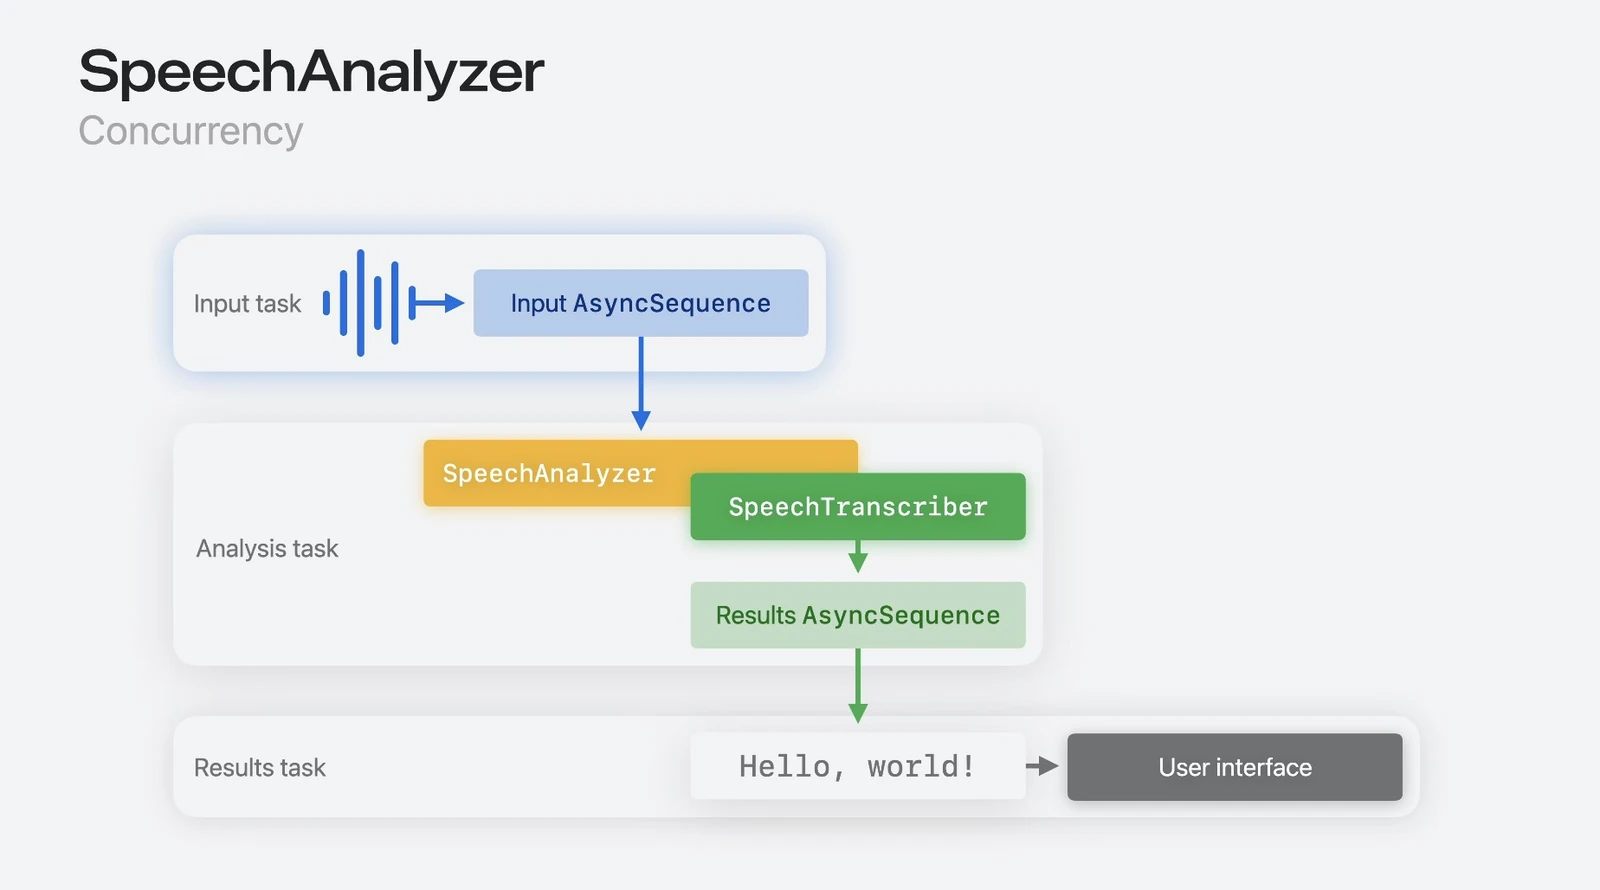
Jedna sesja, trzy zadania: dźwięk trafia jako AsyncSequence, SpeechAnalyzer i SpeechTranscriber go analizują, a wyniki wracają jako druga AsyncSequence odczytywana przez interfejs. Źródło: Apple, sesja WWDC25 nr 277.
Wyniki przychodzą dwukrotnie. Wszystko w zakresie, który Apple nazywa zmiennym, może jeszcze zostać zastąpione lepszym wynikiem; wszystko poza nim jest ostateczne. Dzięki temu aplikacja pokazuje wstępną transkrypcję, gdy jeszcze mówisz, a potem ją poprawia. Apple podaje pięć celów projektowych modelu SpeechTranscriber: długie nagrania, mowę konwersacyjną, odległych mówców, małe opóźnienie i prywatność, czyli działanie na urządzeniu. Na tym modelu opierają się Notatki, Dyktafon, Dziennik i podsumowania rozmów.
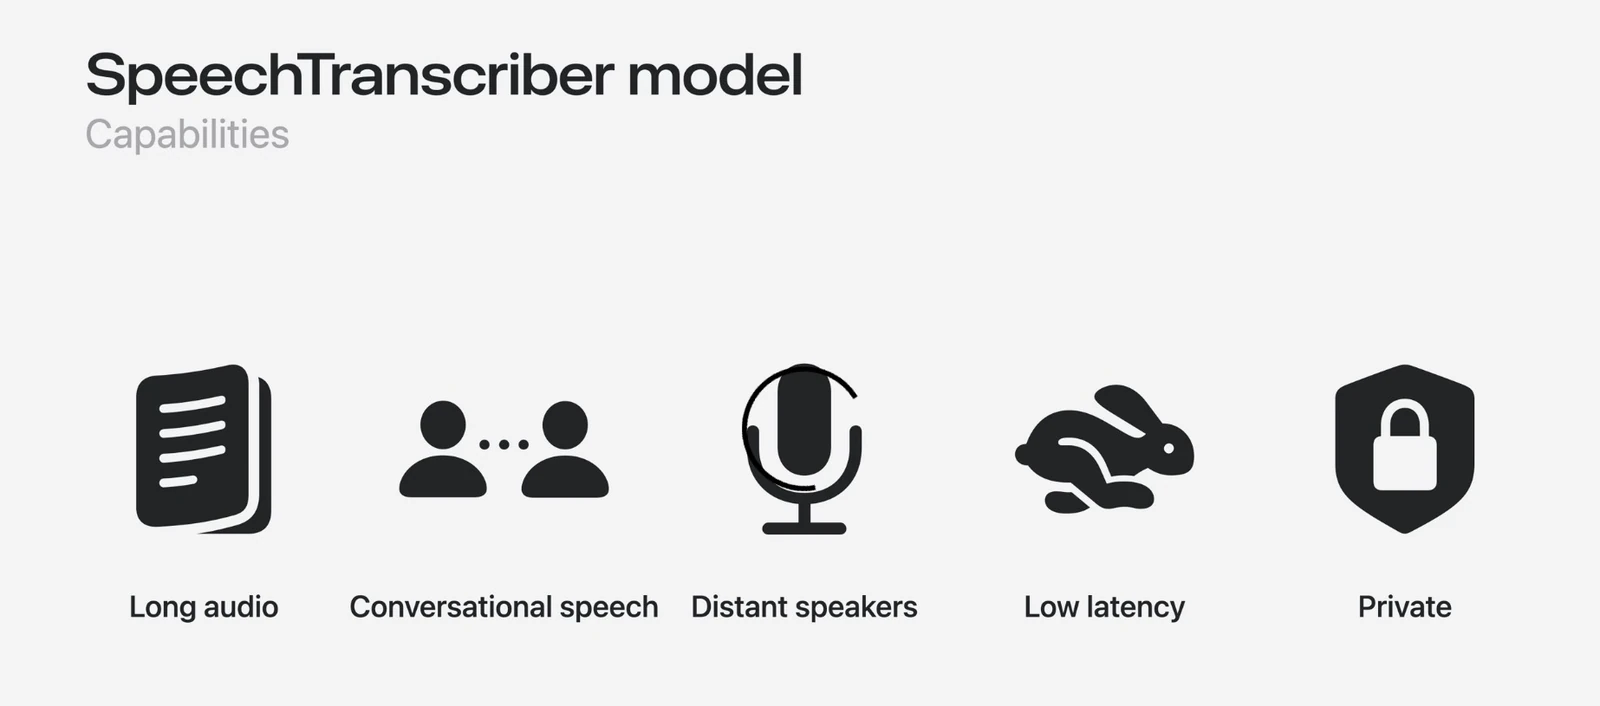
Pięć celów projektowych modelu SpeechTranscriber deklarowanych przez Apple. Źródło: Apple, sesja WWDC25 nr 277.
Modele nie wchodzą w skład żadnej aplikacji. System pobiera je z serwerów Apple za pośrednictwem AssetInventory, przechowuje i aktualizuje oraz udostępnia między aplikacjami. Nie zwiększają rozmiaru pobieranej aplikacji, a dekodowanie odbywa się poza procesem, który je wywołał. Jeśli SpeechTranscriber nie ma modelu dla danego języka lub urządzenia, zadanie przejmuje DictationTranscriber, korzystając z tych samych modeli co dyktowanie systemowe.
Metoda i ograniczenia
Pięć z sześciu silników w tych tabelach to modele pobierane przez Whisper Notes. Każdy silnik transkrybował te same nagrania, w tej samej kolejności i pojedynczo, na jednym M5 MacBook Air (32 GB, macOS 27.0). Nagrania pochodzą z części testowej zbioru Google FLEURS w rewizji 70bb2e84 — około 150 zdań i 30 minut na język. Stały hash identyfikatorów elementów w samym zbiorze ustala ich kolejność; wybieramy najkrótszy ciąg pełnych elementów, którego długość przekracza trzydzieści minut. Wyniki modeli nie miały żadnego wpływu na ten wybór. Każdą komórkę odtworzyliśmy z jej własnego potwierdzenia wyniku i ponownie sprawdziliśmy; wszystkie 285 przeszło kontrolę. Wyniki podajemy jako współczynnik błędów słów tam, gdzie słowa są rozdzielone spacjami, oraz współczynnik błędów znaków dla japońskiego, koreańskiego, chińskiego i kantońskiego — nigdy nie łączymy ich w jedną liczbę.
Kolumny Whisper można porównać z wynikami samego OpenAI. Dla dwunastu języków, dla których OpenAI publikuje wynik FLEURS dla Whisper Large V3 Turbo, nasze wartości różnią się od nich średnio o 0,7 punktu, a dziesięć z dwunastu mieści się w 95-procentowym przedziale naszego testu; dla jedenastu języków spoza wierszy indyjskich nasze wyniki Whisper Small różnią się średnio o 1,0 punktu od tabeli wyników poszczególnych języków w pracy opisującej Whisper. Kolumna Apple Speech pochodzi z tych samych nagrań, tego samego mechanizmu oceny i tego samego sposobu normalizacji.
FLEURS zawiera czystą, czytaną mowę. Te wyniki nie mówią, jak silniki zachowują się w hałaśliwym pomieszczeniu ani podczas dwugodzinnego spotkania; nie mierzyliśmy, jak wyglądałyby wtedy różnice. Wszystkie testy wykonaliśmy na jednym komputerze. Przy około 150 zdaniach na język silniki różniące się o około jeden punkt lub mniej należy traktować jako remis; tabele oznaczają już w ten sposób dokładne remisy, jak we włoskim, gdzie Qwen3-ASR 1.7B i Whisper Large V3 Turbo uzyskały po 2,58.
Najczęściej zadawane pytania
Apple Speech czy Whisper Small: który jest dokładniejszy?
Apple Speech, w ośmiu z dziesięciu języków zmierzonych poprawnie przez oba silniki. Przegrywa w angielskim, 8,80 (Apple Speech) wobec 7,04 (Whisper Small), i w brazylijskim portugalskim, 9,35 wobec 8,61. Największą przewagę ma w chińskim, 7,97 (Apple Speech) wobec 20,50 (Whisper Small); we francuskim 7,61 wobec 13,24; w japońskim 6,36 wobec 11,37; w kantońskim 8,69 wobec 119,01. Whisper Small wymaga pobrania 600 MB i działał 7,9× szybciej niż w czasie rzeczywistym, wobec 30,8× dla Apple Speech.
Apple Speech czy Parakeet V3: który jest dokładniejszy?
Parakeet V3, w każdym europejskim języku obsługiwanym przez oba silniki: w angielskim 6,89 (Parakeet V3) wobec 8,80 (Apple Speech), we francuskim 5,83 wobec 7,61, w hiszpańskim 4,86 wobec 5,41, we włoskim 3,43 wobec 4,39, a w brazylijskim portugalskim 6,49 wobec 9,35; w niemieckim oba uzyskują 6,26. Parakeet V3 nie obsługuje japońskiego, koreańskiego, chińskiego ani kantońskiego — w tych językach spośród tej dwójki dostępny jest tylko Apple Speech. Parakeet V3 wymaga pobrania 465 MB i działał 75,6× szybciej niż w czasie rzeczywistym, a Apple Speech 30,8×.
Apple Speech czy Whisper Large V3 Turbo: który jest dokładniejszy?
Whisper Large V3 Turbo, w ośmiu z dziesięciu języków zmierzonych poprawnie przez oba silniki: angielski 5,49 (Whisper Large V3 Turbo) wobec 8,80 (Apple Speech), niemiecki 4,05 wobec 6,26, japoński 5,30 wobec 6,36, koreański 4,25 wobec 4,31, francuski 5,97 wobec 7,61, hiszpański 3,62 wobec 5,41, włoski 2,58 wobec 4,39, brazylijski portugalski 5,44 wobec 9,35. W chińskim remisują z wynikiem 7,97; Apple Speech prowadzi tylko w kantońskim, 8,69 (Apple Speech) wobec 36,75 (Whisper Large V3 Turbo). Turbo obsługuje też niderlandzki, rosyjski i polski, z wynikami 5,69, 5,13 i 5,45. Zajmuje około 1,6 GB i jest tu najwolniejszym silnikiem — 3,0× szybciej niż w czasie rzeczywistym.
Jakie języki obsługuje Apple Speech?
W naszym teście Apple Speech zwrócił wyniki w 21 z 83 konfiguracji: angielski, niemiecki, francuski, hiszpański, włoski, portugalski (Brazylia), japoński, koreański, chiński, kantoński oraz jedenaście języków Azji Południowej — hindi, telugu, urdu, pendżabski, bengalski, nepalski, malajalam, marathi, kannada, gudżarati i tamilski — w których odpowiedział angielskimi literami, a nie znakami używanymi w tych językach. Brakuje niderlandzkiego, polskiego i rosyjskiego; listę ustala macOS na każdym komputerze. Najbliżej liderów jest w koreańskim, japońskim i chińskim — traci 0,77, 1,06 i 1,48 — a najdalej w angielskim: 8,80 (Apple Speech) wobec 4,49 (Qwen3-ASR 1.7B). We wszystkich dziesięciu językach zmierzonych przez oba jest dokładniejszy od starego dyktowania. Whisper w Whisper Notes obsługuje całą listę języków aplikacji na każdym kanale.
Czym jest SpeechAnalyzer i czy to to samo co dyktowanie Apple?
SpeechAnalyzer to interfejs API, który Apple przedstawiło podczas WWDC 2025 i udostępniło w macOS 26 oraz iOS 26. SpeechTranscriber jest znajdującym się w nim silnikiem transkrypcji, który w tym wpisie nazywamy Apple Speech; dyktowanie to starszy silnik zgodności. Uruchomiliśmy oba, a Apple Speech był dokładniejszy we wszystkich dziesięciu językach, dla których oba zwróciły prawidłowe wyniki. Dyktowanie obsługuje więcej języków — 33 konfiguracje wobec 21 — w tym niderlandzki, polski i rosyjski z wynikami 17,34 %, 13,50 % i 13,13 % WER (dyktowanie), wobec 5,69 %, 5,45 % i 5,13 % (Whisper Large V3 Turbo).
Czy dźwięk opuszcza mojego Maca, gdy używam Apple Speech?
Apple opisuje SpeechTranscriber jako rozpoznawanie mowy działające na urządzeniu: macOS pobiera zasoby językowe raz, a później rozpoznawanie odbywa się lokalnie. Mierzyliśmy dokładność i szybkość, a nie zachowanie sieci, dlatego tę część przedstawiamy zgodnie z opisem Apple. Silniki pobierane przez Whisper Notes — Whisper, Parakeet V3, SenseVoice i Qwen3-ASR — działają na GPU lub Neural Engine Twojego Maca, bez konta ani API key; transkrypcja działa bez połączenia z siecią na każdym kanale. Apple Speech jest dostępny w aplikacji na Maca pobranej z naszej strony, w macOS 26 lub nowszym: to silnik systemowy na Twoim Macu, którego pakiet językowy pobiera macOS.
Dlaczego te liczby nie zgadzają się z dokładnością, jaką uzyskuję na swoich nagraniach?
Ponieważ FLEURS zawiera krótkie, czyste nagrania czytanej mowy, a Twoje nagrania takie nie są. Nasz test to kalibracja na publicznym zbiorze danych: około 150 zdań i 30 minut na język, jeden M5 MacBook Air oraz te same nagrania dla każdego silnika. Pokazuje, czy dany silnik jest rozsądnym wyborem dla Twojego języka, a nie jaki wynik uzyskasz podczas spotkania, na zaszumionym dźwięku lub w dwugodzinnym pliku.
Wypróbuj
Wszystkie pięć pobieranych modeli — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small i Qwen3-ASR 1.7B — znajdziesz w Whisper Notes na Maca pobranym z naszej strony pod ścieżką Ustawienia → Model transkrypcji. W macOS 26 lub nowszym Apple Speech pojawia się na tej samej liście; jeśli masz już aplikację, zaktualizuj ją do najnowszej wersji.
Jeśli nasze liczby nie zgadzają się z Twoim doświadczeniem w danym języku, napisz na mac@whispernotes.app. Pełne informacje o wydaniach: whispernotes.app/changelog.
Źródła: nasz przebieg na zbiorze testowym Google FLEURS w rewizji 70bb2e84, dokumentacja Apple dotycząca SpeechAnalyzer oraz wcześniejszy przebieg Qwen3-ASR w trzydziestu językach.
 Pobierz na macOS