
En transskription fortæller dig, hvad der blev sagt. Til interviews, møder og podcasts er den anden halvdel af opgaven at vide, hvem der sagde det. Taleforskere kalder problemet speaker diarization. Siden juli 2026 klarer Whisper Notes talergenkendelsen helt på enheden, på iPhone og i begge Mac-versioner.
Her forklarer vi, hvordan det virker, viser testresultater mod et facit lavet i skyen og beskriver den ene fejltype, vi ikke kunne løse teknisk, og hvad vi gjorde i stedet.
Hvad den gør
Åbn en note, for eksempel en optagelse, en importeret lyd- eller videofil eller en mødeoptagelse, og tryk på talerknappen. Få sekunder senere har hvert afsnit en taleretiket og et tidsstempel.
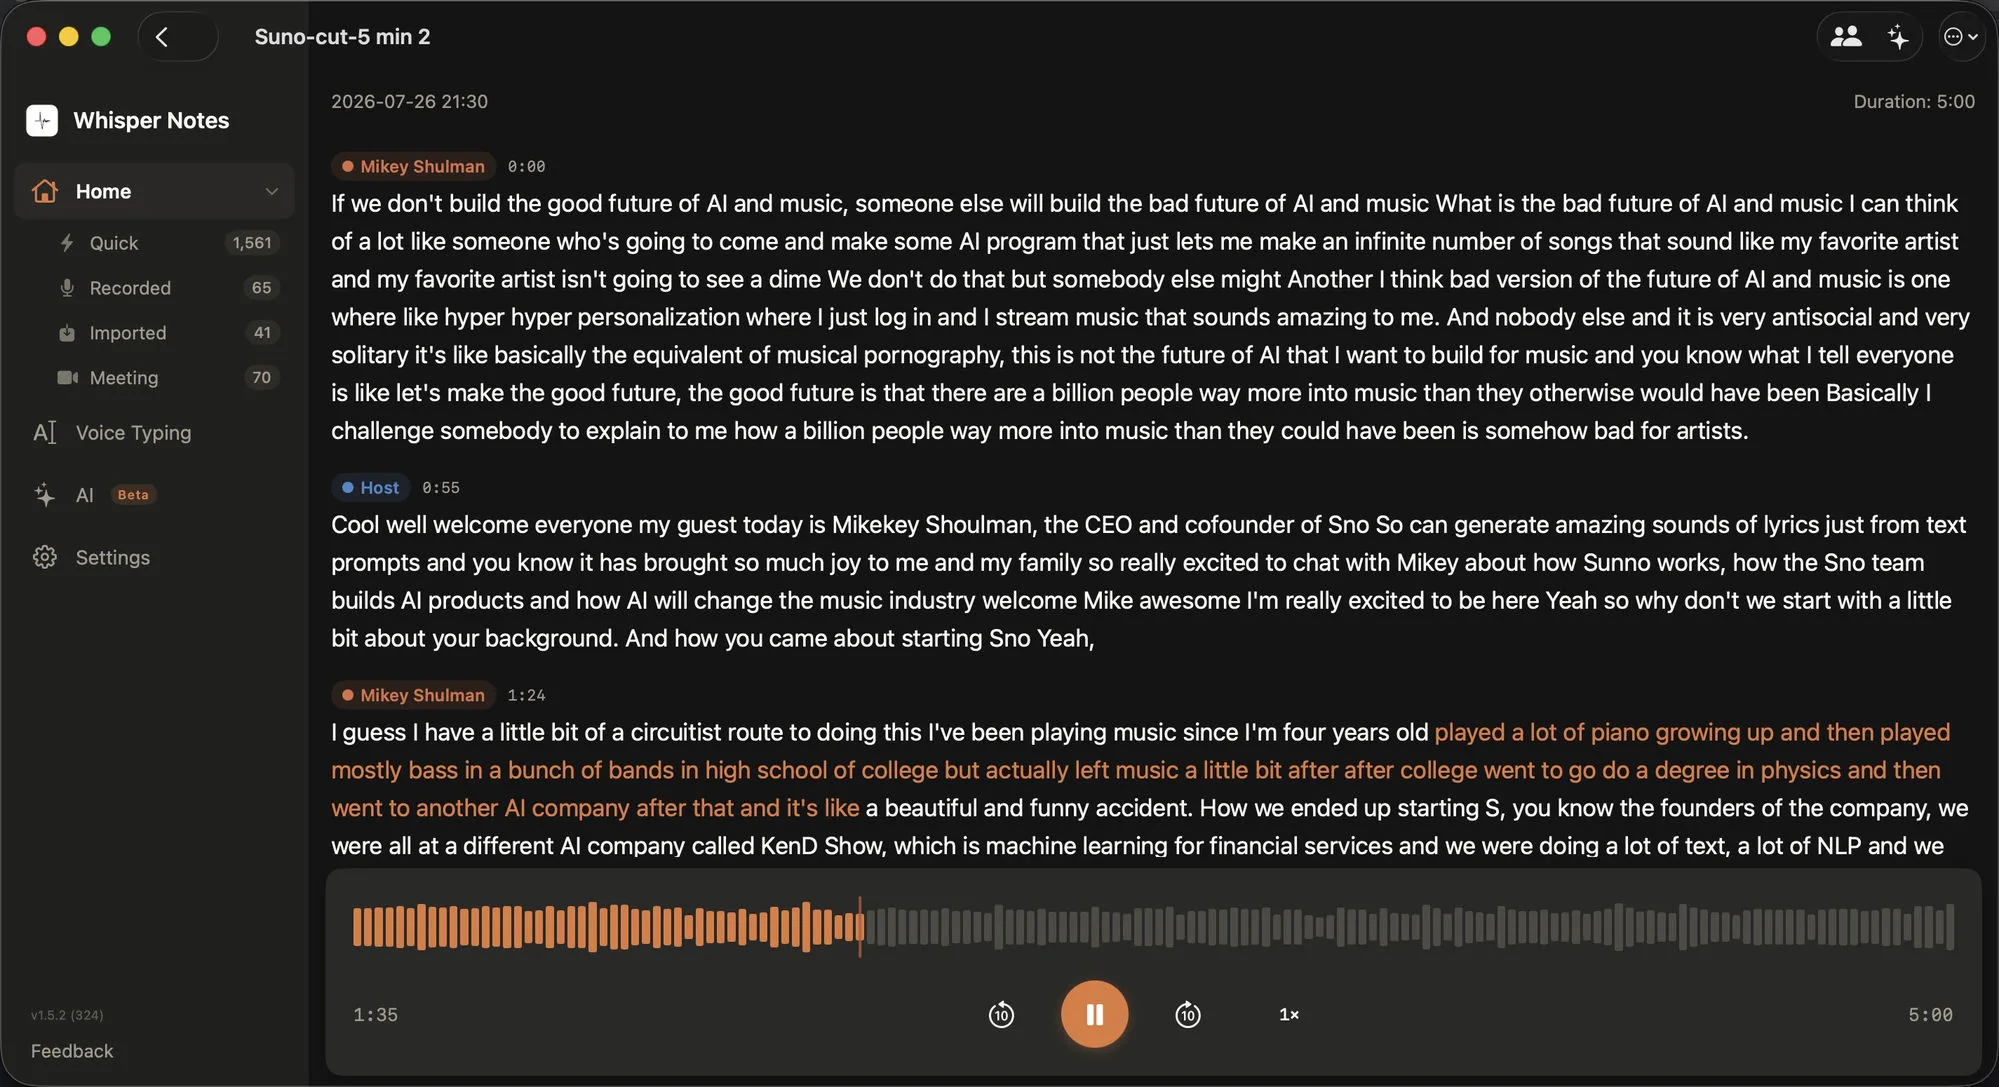
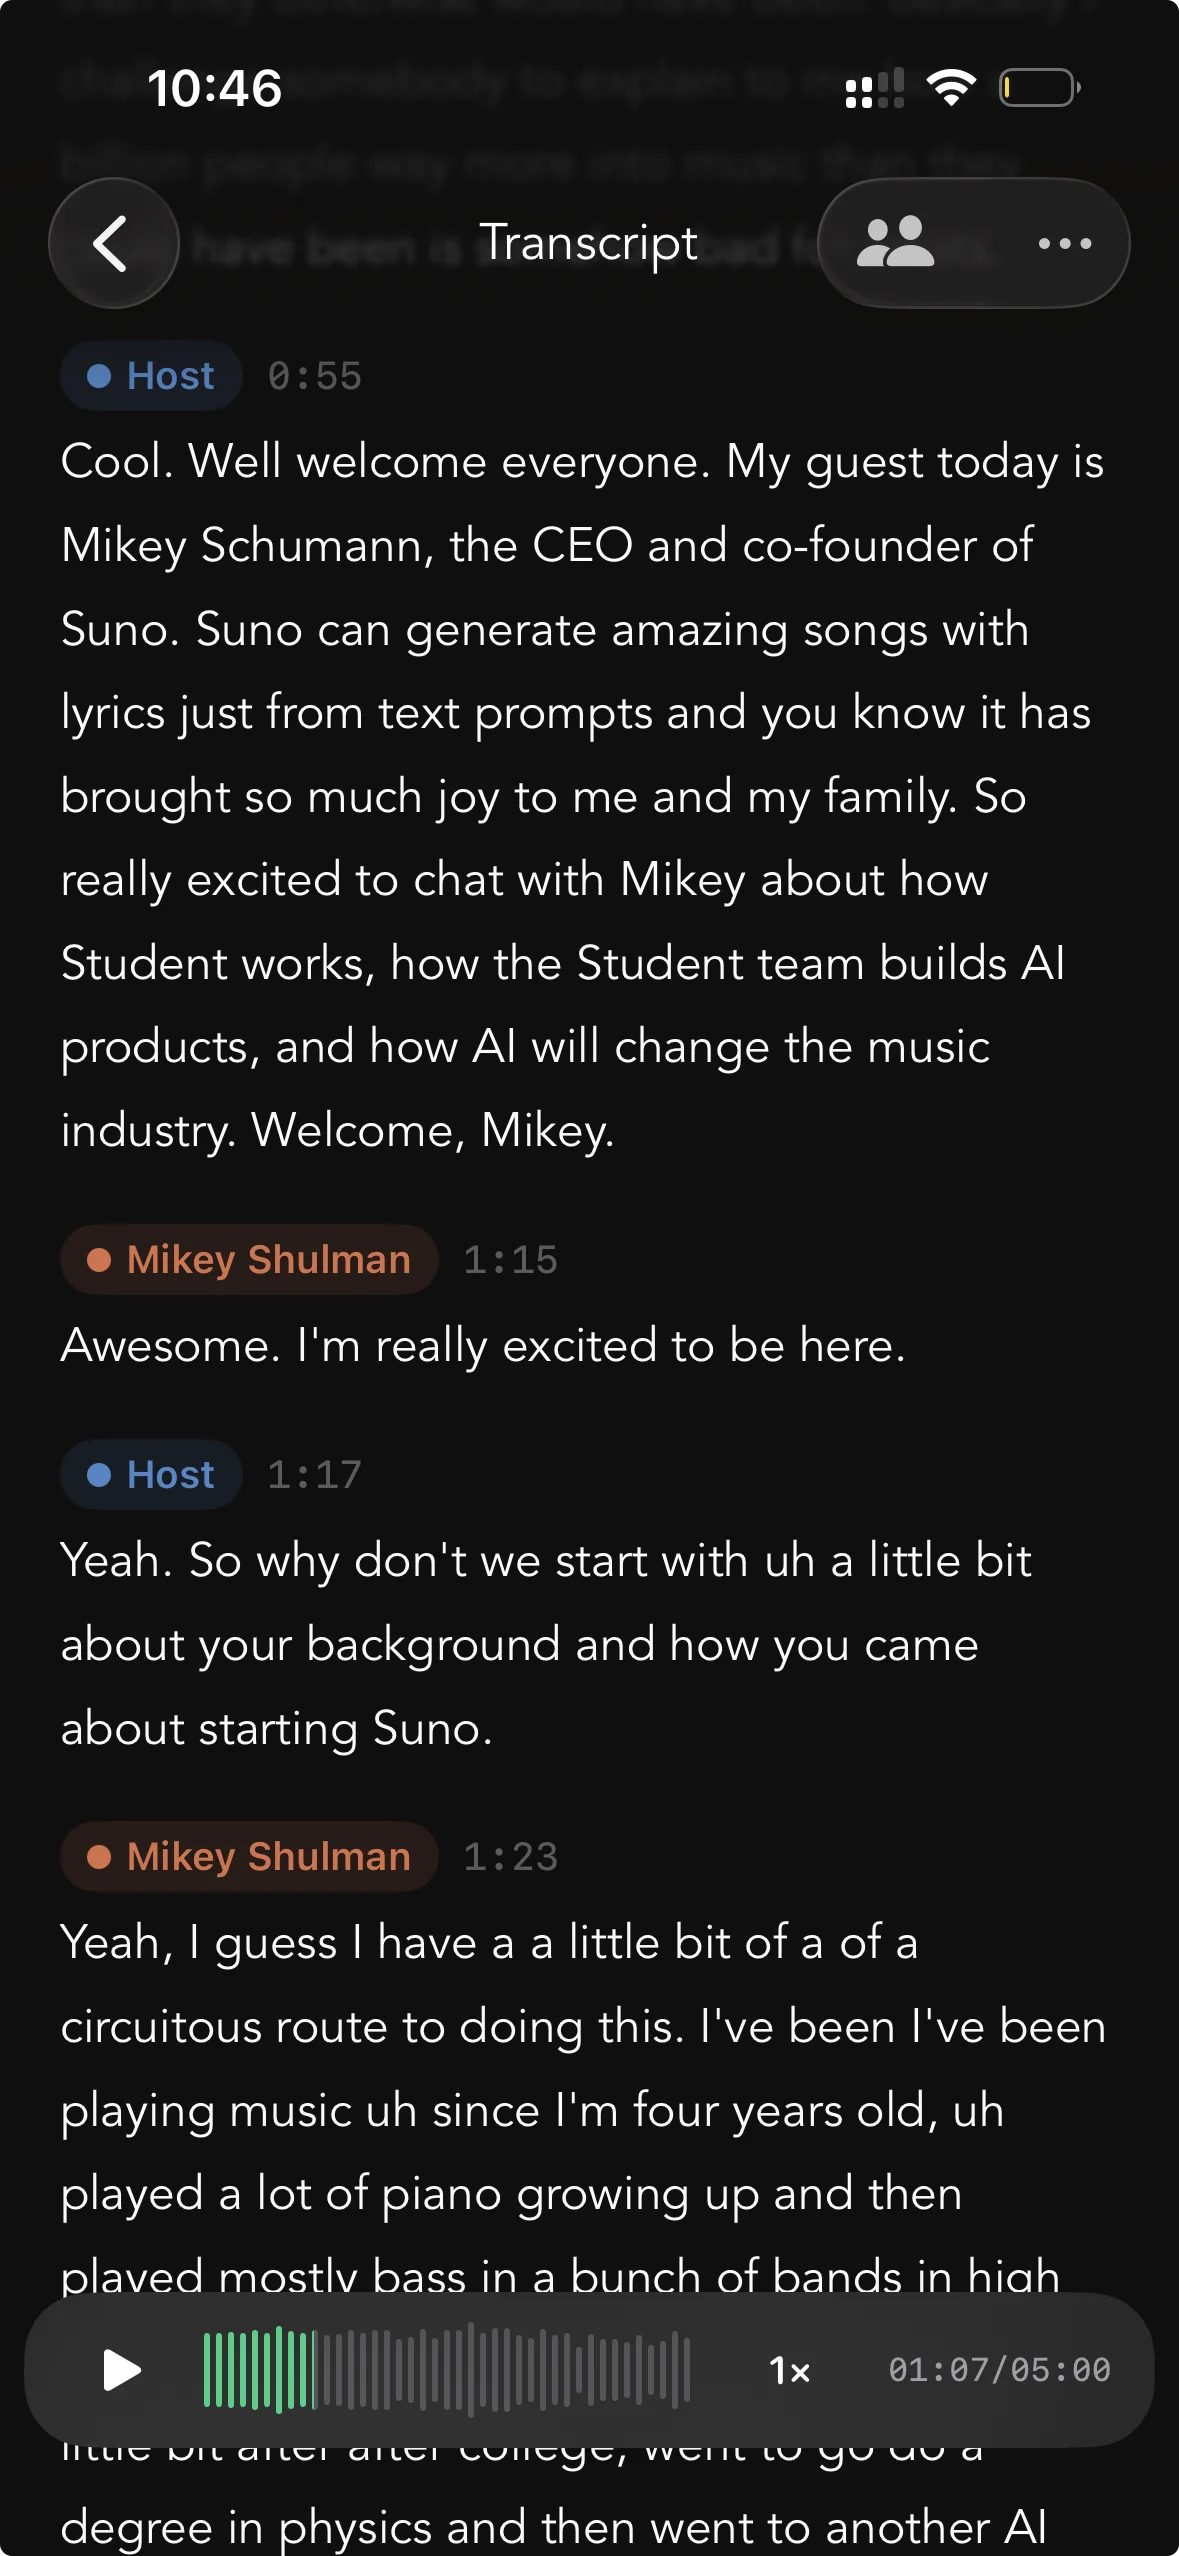
Taleretiketter på Mac og iPhone. Tryk på en sætning for at hoppe til det sted i lyden.
Etiketterne hedder først Taler 1 og Taler 2. Omdøber du en af dem, ændres navnet i hele transskriptionen. Trykker du på en sætning, springer afspilningen til præcis det øjeblik. Så er det let at tjekke et citat mod den oprindelige stemme.
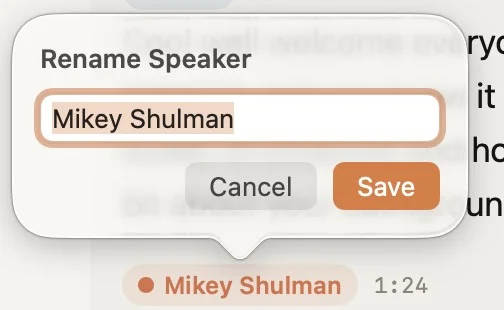
Når du omdøber en taler, opdateres alle afsnit i noten.
Ved mødeoptagelser kører talergenkendelsen automatisk, når mødet slutter (det kan slås fra i Indstillinger). Etiketterne følger med, når du eksporterer: Kopiér transskription med talere tager dem med til udklipsholderen, og SRT- og VTT-filer tager dem med i underteksterne.
Talergenkendelsen arbejder med stemmer, ikke ord. Derfor virker den på samme måde på alle de 100+ sprog, appen transskriberer.
En model på 19 MB på Neural Engine
Talergenkendelse svarer på „hvem talte hvornår“ i tre trin. Først deles lyden op i stykker med tale. Så bliver hvert stykke til et stemmeaftryk: en kompakt vektor, der beskriver selve stemmen, ikke ordene. Til sidst grupperes stemmeaftrykkene, og stykker i samme gruppe får samme etiket.
Whisper Notes bruger pyannotes community-1-pipeline, konverteret til Core ML, så begge trin kører på Neural Engine. Den skal downloades én gang og fylder 19 MB. En samtale på 5,7 minutter tager 2 til 4 sekunder på en Mac med M-chip.
Lyd → stykker med tale → stemmeaftryk → grupper → etiketter
Alle trin kører på enheden.
Det betyder mere for talergenkendelse end for transskription. Et stemmeaftryk er biometrisk: det identificerer en person, ligesom et fingeraftryk gør. Når det hele kører lokalt, bliver stemmeaftryk af dig, dine kolleger og dem, du interviewer, beregnet, grupperet og slettet på enheden. De bliver aldrig sendt nogen steder hen.
Hvad vi målte
Vi bruger en fast test med to filer til talergenkendelse. Facit kommer fra en skytjeneste til transskription og talergenkendelse (ElevenLabs) og er tjekket manuelt. Ved scoringen tildeles hvert 10. millisekund tale til en taler, og vi bruger den bedste kobling mellem resultat og facit. To filer er en lille test, så vi ser tallene som vejledende, ikke endelige.
Den første fil er det almindelige tilfælde: en engelsk podcast på fem minutter med to talere, hvis stemmer lyder tydeligt forskellige. Sådan ser de fleste interviews, podcasts og møder mellem to personer ud.
| Engelsk podcast med to talere (5 min) | Resultat |
|---|---|
| Tildeling pr. frame (opløsning 10 ms) | 96,7 % |
| Nøjagtighed pr. sætning (det, du læser) | 99,1 % |
| Behandlingstid, Neural Engine i M-chip | 2–4 sek. |
De resterende 0,9 % er tre små udsving ved talerskift, i alt 3,4 sekunder. Det svarer til opløsningen i selve facit. På materiale som dette matcher resultatet på enheden den skytjeneste, der lavede vores facit.
Det svære tilfælde
Den anden fil er bevidst svær: to mandestemmer, der ligner hinanden i et rum med rumklang og en vært, der bryder ind 19 gange, i gennemsnit 2,3 sekunder ad gangen. Gæsten taler i 272 sekunder, værten i 43. Netop den akustiske profil får talergenkendelse til at fejle på alle sprog: stemmer, der ligner hinanden, og korte replikker frem og tilbage.
Her bryder den automatiske gruppering sammen. De to stemmeaftryk ligger så tæt, at algoritmen slår dem sammen og giver næsten hele samtalen én etiket. Optagelsen er tilfældigvis fra et kinesisk interviewprogram. Det gav os mulighed for at teste den oplagte hypotese: at en model, der er specialiseret i sproget, ville klare sig bedre. Vi kørte to talermodeller, der er trænet specifikt på kinesisk tale, gennem en pipeline på CPU'en:
| Model | Engelsk podcast | Svært tilfælde* | Tid (5,7 min lyd) |
|---|---|---|---|
| pyannote community-1 (vores, Neural Engine) | 96,7 % | 81–82 % | 2–4 sek. |
| CAM++ (trænet på kinesisk, CPU) | 93,9 % | 81,2 % | 36–103 sek. |
| ERes2NetV2 (trænet på kinesisk, CPU) | — | 80,5 % | 220–290 sek. |
* Tildeling pr. frame på den svære fil, når antallet af talere er angivet. Uden det ender alle modeller med at samle næsten alt under én taler.
Begge fejler på samme måde og bruger 10 til 100 gange så meget regnekraft. Problemet er akustisk, ikke sprogligt. Grænsen går ved, hvad nutidens stemmeembeddings kan skelne, på alle sprog.
Det udelukkede den oplagte løsning og pegede på en anden: at give pipelinen en oplysning, den ikke selv kan udlede, nemlig hvor mange personer der er i rummet. Når antallet er angivet (et menuvalg med op til 10 talere), går den svære fil fra sammenbrud til 89 % nøjagtighed pr. sætning. Automatisk registrering er stadig standard, fordi den rammer rigtigt på almindeligt materiale.
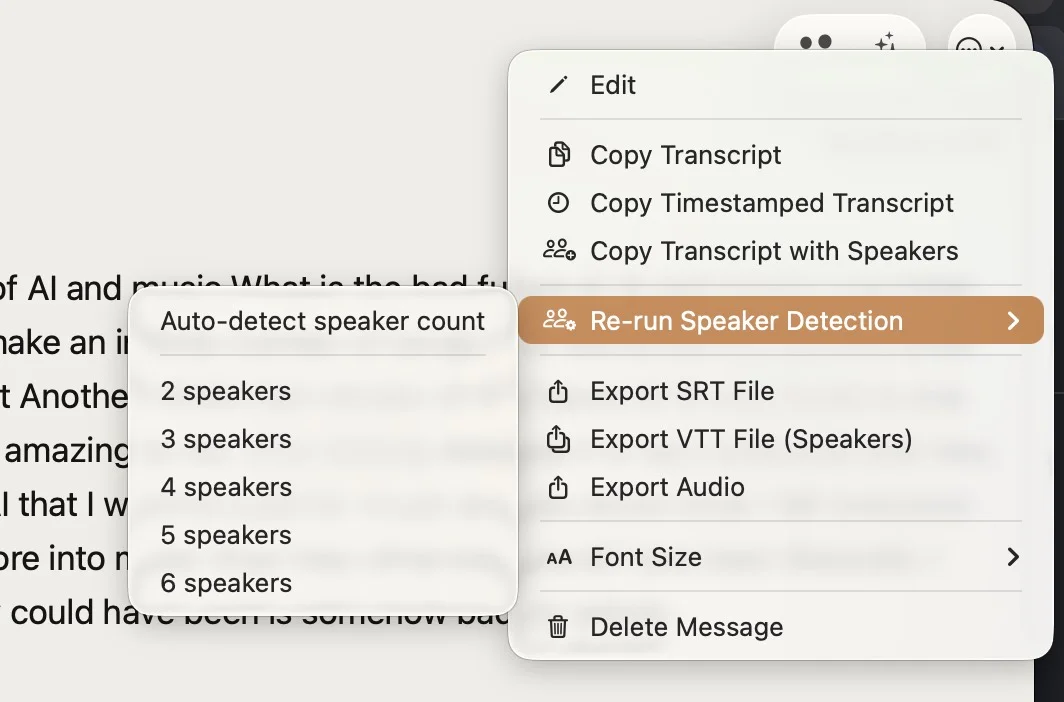
Talerregistrering køres igen med et præcist antal. Fra samme menu eksporterer du SRT og VTT med taleretiketter.
Finjustering af korte indskud
Med et fast antal talere lå omkring halvdelen af de resterende fejl i indskud på under tre sekunder. Et klip på to sekunder giver modellen meget lidt at arbejde med, og i hurtige ordvekslinger kommer stemmeaftrykket til at indeholde lidt af den taler, der taler lige før eller efter.
Derfor gennemgår pipelinen efter grupperingen hver sætning, der er kortere end 3,5 sekunder. Den beregner stemmeaftrykket igen med en maske over præcis den sætnings frames og sammenligner det med hver talers anker, altså gennemsnittet af deres længste replikker. Etiketten ændres kun, når forskellen er tydelig. Det genbruger den model, der allerede er der, så der er ikke noget ekstra at downloade.
| Samlet nøjagtighed pr. sætning | Før finjustering | Efter |
|---|---|---|
| Svært tilfælde (antal talere angivet) | 89,0 % | 94,8 % |
| Engelsk podcast (automatisk) | 98,5 % | 99,1 % |
Tærsklen er sat forsigtigt: på tværs af begge filer ændrede finjusteringen 21 etiketter og lavede ingen nye fejl.
Begrænsninger
• Etiketterne kommer, når optagelsen er slut, ikke under et opkald. Har du brug for liveundertekster med talernavne, mens mødet stadig kører, er en skytjeneste som Otter eller Notta det rigtige værktøj.
• Når folk taler samtidig, får hver sætning kun én etiket.
• Stemmer, der ligner hinanden, er stadig svære. 94,8 % på vores svære fil er det bedste, vi når i dag med et angivet antal talere. Problemet er ikke løst.
Tilgængelighed
Talergenkendelse er med i engangskøbet ($7.99 på iPhone, $14 på Mac) sammen med transskriptionsmotorerne: Parakeet (Parakeet Ultra fra Moondream, videretrænet fra NVIDIA Parakeet V3), Whisper (Large V3 Turbo på Mac, Small på iPhone), SenseVoice og Apple Speech på iOS 26 og macOS 26. På Mac er der også Qwen3-ASR 1.7B (Beta). Der er ingen ekstra betalingsplan og ingen konto.
• iPhone: fra App Store.
• Mac App Store: med i den nuværende version.
• Mac-appen fra vores hjemmeside: fra downloadsiden til Mac, gratis for 5.000 ord om ugen.
 Download til iOS
Hvordan selve mødeoptagelsen fungerer, kan du læse i vores indlæg om offline mødetransskription.