
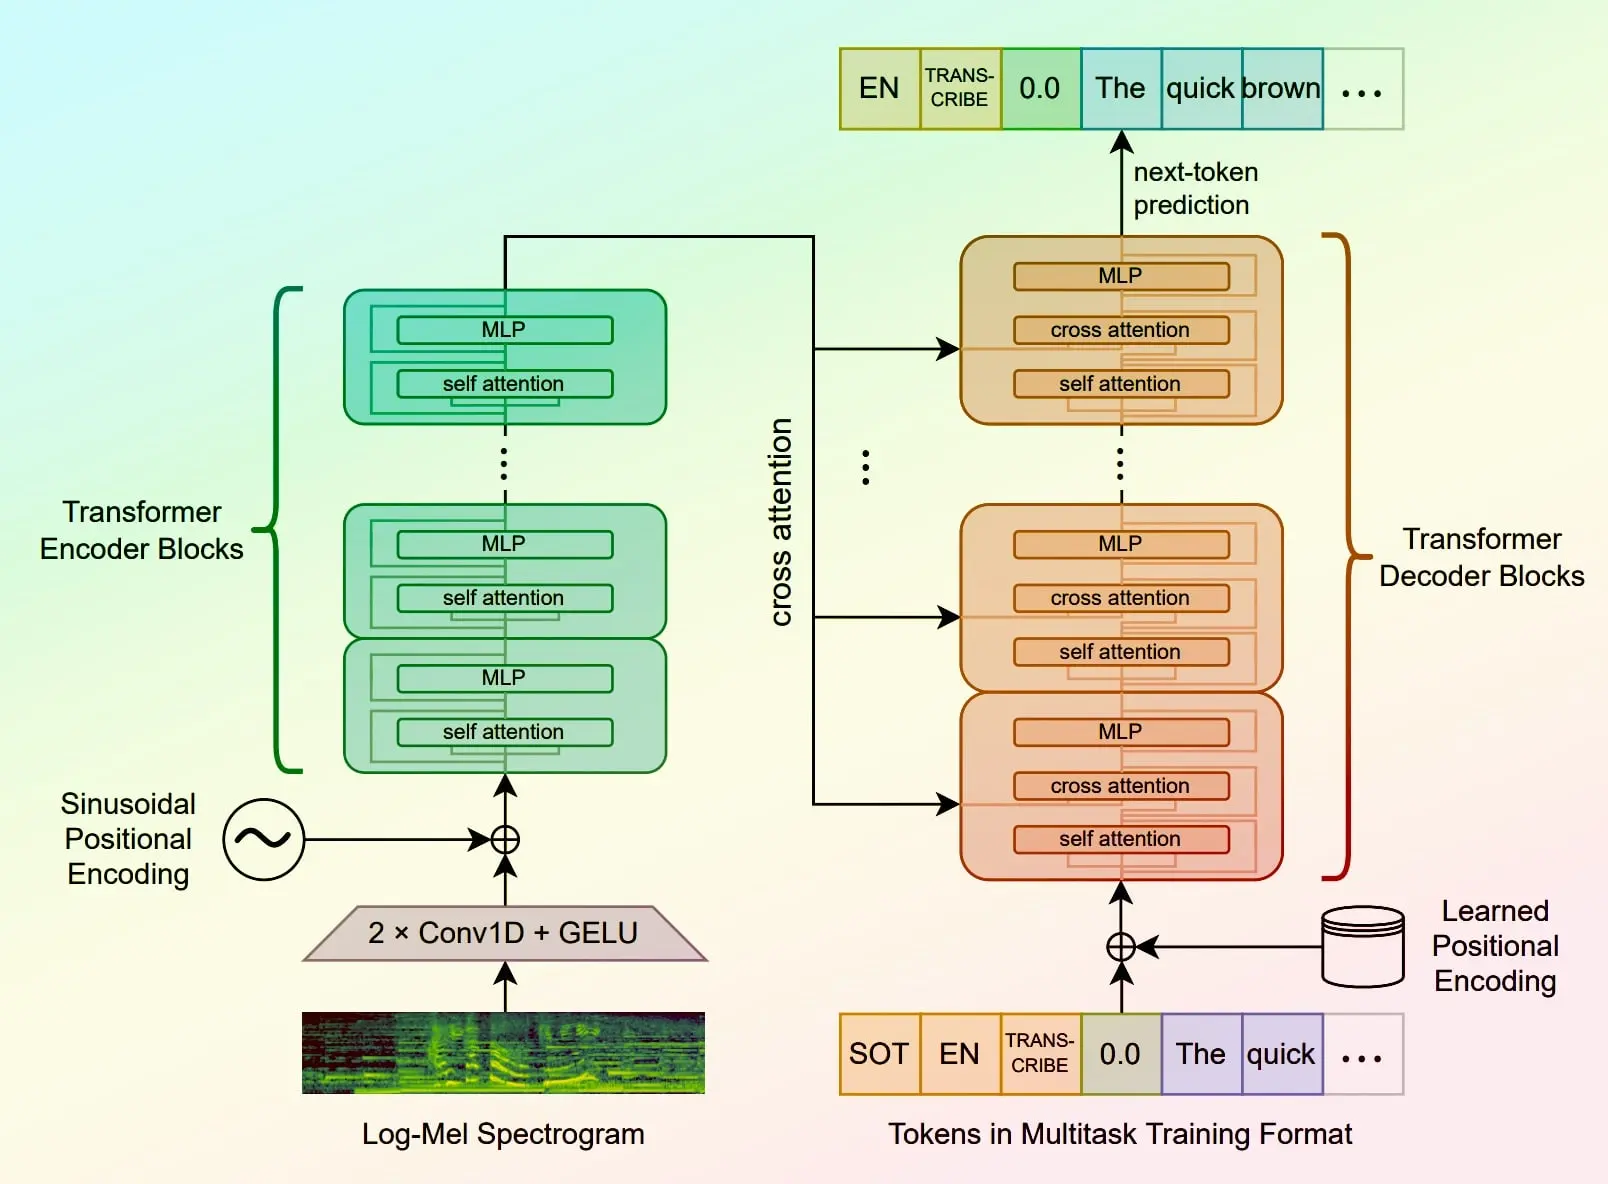
OpenAI'nin Whisper Large-v3 Turbo modeli, dekoderi 32 katmandan 4'e indirerek parametre sayısını 1.55B'den 809M'ye düşürüyor. Apple Silicon testlerimizde aynı sesi, neredeyse aynı doğrulukla yaklaşık 5× daha hızlı yazıya döktü. Whisper Notes bu modeli Mac'te sunuyor, iPhone'da ise bilerek kullanmıyor; orada daha küçük modeller daha uygun.
V3 Turbo ve V3: ne değişti
Turbo yeni bir mimari değil. Dekoderi 32 katmandan 4'e budanmış, ardından doğruluğu geri kazanmak için ince ayar yapılmış, birebir aynı Whisper Large-v3 modeli. Kodlayıcıya (encoder) dokunulmamış.
| Large-v3 Turbo | Large-v3 | |
|---|---|---|
| Parametreler | 809M | 1,550M |
| Dekoder katmanları | 4 | 32 |
| Diller | 100'den fazla | 100'den fazla |
| Çeviri görevi | Desteklenmiyor | Destekleniyor |
| Lisans | MIT | Apache 2.0 |
Yöntem: aynı 10 dakikalık ses dosyası, adı geçen her cihazda aynı Whisper Notes sürümüyle yazıya döküldü. Süreler, transkripsiyonun başlamasından nihai metne kadar geçen duvar saati saniyeleridir; V3 ile Turbo arasında yalnızca model değişti.
Çeviri görevi, Turbo'nun eğitim verisinden bilinçli olarak çıkarıldı. Tam Large-v3 modeli bunu destekler, ancak Whisper Notes yalnızca Turbo'yu sunar — web sitemizden indirilen Mac sürümünde yapay zekâ asistanı, transkripti yerel Gemma modeliyle çevirebilir.
Temel model: Whisper Large-v3 nedir?
Whisper Large-v3, OpenAI'nin Kasım 2023'te yayımladığı amiral gemisi açık kaynaklı konuşma tanıma modelidir. 1.55B parametreye sahiptir, 128 mel-bin'lik spektrogram girişi kullanır, 5 milyon saat ses üzerinde eğitilmiştir (1M zayıf etiketli + 4M sözde etiketli) ve 100'den fazla dili destekler. Hugging Face Open ASR Leaderboard'da ortalama ~7.4% kelime hata oranına sahiptir — bu makale boyunca Turbo'nun kıyaslandığı doğruluk tavanı budur. Tüm modelleri 42 dildeki hata oranlarıyla yan yana görmek için Whisper modelleri karşılaştırmamıza bakın.
Hız kıyaslaması: Apple Silicon'da Whisper Notes
Whisper Notes for Mac'te Turbo, Mac'in kendisinde, ağırlıklı olarak GPU üzerinde çalışır. 10 dakikalık sesin işlenmesi:
| Cihaz | Whisper V3 | V3 Turbo | Hızlanma |
|---|---|---|---|
| iPhone 15 Pro | 425 s | 82 s | 5.2× |
| iPad Pro M2 | 380 s | 71 s | 5.4× |
| MacBook Pro M2 | 316 s | 63 s | 5.0× |
5× hızlanma, Apple Silicon'daki Whisper Notes'a özgüdür. faster-whisper gibi framework'lerle NVIDIA GPU'larında fark ~2.7×'e iner (aşağıdaki topluluk kıyaslamalarına bakın).
Doğruluk: WER karşılaştırması
Hugging Face Open ASR Leaderboard, iki modeli de aynı İngilizce veri kümelerinde test ediyor. Turbo'nun kelime hata oranı, her kıyaslamada V3'ün yarım puan yakınında:
| Veri kümesi | Whisper Large-v3 Turbo WER | Whisper Large-v3 WER |
|---|---|---|
| LibriSpeech Clean | 2.10% | 2.01% |
| LibriSpeech Other | 4.24% | 3.91% |
| GigaSpeech | 10.14% | 10.02% |
| Earnings22 | 11.63% | 11.29% |
| AMI | 16.13% | 15.95% |
| Ortalama WER | 7.83% | 7.44% |
V3 her veri kümesinde biraz daha doğru, ancak fark küçük — ortalama 0.39 yüzde puanı. Gerçek dünyadaki çoğu transkripsiyonda bu farkı duymazsınız.
YouTube-commons uzun form değerlendirmesinde (en büyük açık kaynaklı ASR kıyaslamalarından biri) Turbo 13.40% WER alıyor, V3 ise 13.20% — üstelik Turbo 129.5× gerçek zaman faktöründe çalışırken V3 55.3×'te kalıyor. Yani gerçek dünya sesinde neredeyse aynı doğrulukla 2.3× daha hızlı.
Turbo Korece, Rusça ve diğer dillerde ne kadar doğru?
Yukarıdaki kıyaslamalar İngilizce. OpenAI'nin model kartına göre, Turbo'nun budanmış 4 katmanlı dekoderi İngilizce dışındaki dillerde İngilizceye kıyasla biraz daha fazla doğruluk kaybettiriyor; en büyük gerileme düşük kaynaklı dillerde. Rusça ve çoğu Avrupa dilinde Turbo, tam Large-v3'e yakın kalıyor — ve Whisper Notes kullanıyorsanız, yerleşik Parakeet modeli (Moondream'in NVIDIA Parakeet V3'ten ek eğitimle geliştirdiği Parakeet Ultra) Rusça ile diğer 24 Avrupa dilini kapsıyor; Parakeet V3, Apple Silicon üzerinde yaklaşık 60× gerçek zaman hızında çalıştı.
Çince, Japonca, Korece ve Kantonca içinse SenseVoice çok daha hızlı, gerçek zamanın 115–131 katında çalışıyor. En az hatayı hangi modelin yaptığı dile göre değişiyor: FLEURS koşumuzda Japoncada en az hatayı Turbo yaptı, Qwen3-ASR 1.7B (Beta) ve SenseVoice'un önünde. Çince, Korece ve Kantoncada en az hatayı Mac'te Qwen3-ASR 1.7B (Beta) yaptı; Korecede Turbo ikinci oldu ve yine SenseVoice'un önündeydi. Whisper Notes, SenseVoice'u hem iPhone'da hem Mac'te sunar, Mac'te Turbo'nun yanında; böylece her şeyi tek modele zorlamak yerine dile göre doğru modeli seçebilirsiniz.
Topluluk kıyaslamaları: GPU ve CPU
faster-whisper ve whisper.cpp topluluklarından bağımsız kıyaslamalar, farklı donanımlarda tutarlı sonuçlar gösteriyor. GPU üzerinde faster-whisper ile 13 dakikalık sesin yazıya dökülmesi:
| Model | Hassasiyet | Süre | GPU Belleği | WER |
|---|---|---|---|---|
| Large-v3 Turbo | fp16 | 19.2 s | 2,537 MB | 1.92% |
| Large-v3 | fp16 | 52.0 s | 4,521 MB | 2.88% |
| Large-v3 Turbo | int8 | 19.6 s | 1,545 MB | 1.92% |
| Distil-Large-v3 | fp16 | 26.1 s | 2,409 MB | 2.39% |
Kaynak: NVIDIA GPU'da faster-whisper kıyaslaması, LibriSpeech clean doğrulama bölümü. Turbo int8 yalnızca 1.5 GB VRAM kullanıyor — 2 GB'lık bir GPU'ya sığar.
RTX 3060 Laptop'ta (6 GB VRAM, int8 hassasiyet) toplu (batched) çıkarım avantajı daha da büyütüyor:
| Model | Sıralı | Toplu (10) | Toplu WER |
|---|---|---|---|
| Large-v3 Turbo | 46.1 s | 18.7 s | 7.7% |
| Large-v3 | 230.8 s | 43.0 s | 7.9% |
| Large-v2 | 178.3 s | 43.2 s | 8.8% |
| Medium | 113.3 s | 26.3 s | 8.9% |
Kaynak: NilaierMusic kıyaslaması, Intel i7-12650H + RTX 3060 Laptop 6 GB, Fransızca ses, int8 hassasiyet.
Toplu işlemeyle Turbo, test edilen tüm modeller arasında en iyi WER'e (7.7%) ulaşırken aynı zamanda en hızlısı. Üretim kullanımı için net tatlı nokta.
Turbo, Medium ve tüm Whisper model boyutları
Turbo'dan önce olağan uzlaşma Medium'du: katlanılabilir hızda kabul edilebilir doğruluk. Turbo bu ödünleşimi geçersiz kıldı — 809M parametreyle Medium'dan (769M) neredeyse hiç büyük değil, ama large sınıfı doğruluğu kat kat hızla sunuyor. İşte tüm model ailesi yan yana:
| Model | Parametreler | Disk Boyutu | Göreli Hız | Doğruluk Sınıfı |
|---|---|---|---|---|
| tiny | 39M | ~75 MB | ~10× | En düşük |
| base | 74M | ~142 MB | ~7× | Düşük |
| small | 244M | ~466 MB | ~4× | Orta |
| medium | 769M | ~1.5 GB | ~2× | Yüksek |
| large-v3 | 1,550M | ~2.9 GB | 1× (referans) | En yüksek |
| large-v3-turbo | 809M | ~1.6 GB (model dosyası; Whisper Notes'ta yaklaşık 2 GB indirilir) | Apple Silicon'da ~5× | En yükseğe yakın |
30 Eylül 2024'te yayımlanan Turbo 809M parametredir. Disk alanından veya hızdan tasarruf etmek için Medium'u seçiyorduysanız, Turbo artık yaklaşık aynı boyutta hem doğrulukta hem hızda onu geçiyor.
Bilinen sınırlamalar (ve Whisper Notes bunları nasıl ele alıyor)
Yerleşik çeviri yok
Turbo, çeviri verisi olmadan eğitildi. Yalnızca kaynak dilde yazıya döker — ses→İngilizce çevirisini destekleyen Large-v3'ün aksine.
Whisper Notes — web sitemizden indirilen Mac sürümünde yapay zekâ özelliklerini açtığınızda yerel Gemma modeli transkripti seçtiğiniz dile çevirir; transkripti hangi konuşma tanıma modeli üretmiş olursa olsun.
Gürültülü seste daha fazla halüsinasyon
Topluluk raporları, Turbo'nun çok kısa kliplerde veya gürültülü kayıtlarda V3'e kıyasla daha fazla halüsinasyon ürettiğini gösteriyor. Küçültülmüş dekoder (32'ye karşı 4 katman) düşünüldüğünde beklenen bir durum.
Whisper Notes — Whisper yazıya dökmeden önce Silero VAD konuşmayı bulur ve sessizliği atlar; böylece model yalnızca gerçek konuşmayı işler.
Hangi modeli kullanmalısınız?
| İngilizce / Avrupa dilleri | Parakeet V3 — Apple Silicon'da yaklaşık 60× gerçek zaman, İngilizcede 6.32% WER; Turbo'da 7.83% |
| Çince / Japonca / Korece | SenseVoice — hız için, 115–131× gerçek zaman; en az hata için Mac'te Japoncada Whisper Large V3 Turbo, Çince ve Korecede Qwen3-ASR 1.7B (Beta) |
| Diğer diller | Whisper Large V3 Turbo — 100'den fazla dil, yüksek doğruluk, daha yavaş |
Whisper Large-v3 Turbo SSS
Whisper Large-v3 ile Large-v3 Turbo arasındaki fark nedir?
Large-v3 Turbo, Large-v3'ün kodlayıcısını korur ama dekoderi 32 katmandan 4'e indirir. Bu yüzden transkripsiyonda Large-v3 doğruluğuna yakın kalırken çok daha hızlıdır. Ödünleşim, Turbo'nun Whisper'ın yerleşik çeviri görevini desteklememesidir.
faster-whisper, Large-v3 Turbo'yu destekliyor mu?
Evet. faster-whisper, CTranslate2 dönüşümleri aracılığıyla Large-v3 Turbo'yu destekler ve topluluk kıyaslamaları, VRAM kısıtlıyken Turbo'nun güçlü bir seçim olduğunu gösteriyor. Yukarıdaki kıyaslamada Turbo int8 yaklaşık 1.5 GB VRAM kullandı.
whisper.cpp, Large-v3 Turbo'yu destekliyor mu?
Evet. whisper.cpp, Whisper Large-v3 Turbo'nun dönüştürülmüş GGML/GGUF sürümlerini çalıştırabilir. Kendi yerel transkripsiyon hattınızı kuruyorsanız, Turbo'yu tüketici donanımına sığdırmak çoğu zaman tam Large-v3'ten daha kolaydır.
openai/whisper-large-v3-turbo'yu nereden indirebilirim?
Resmi model ağırlıkları OpenAI tarafından Hugging Face'te sunuluyor. Whisper Notes kullanıcılarının bunları elle indirmesine gerek yok: Mac uygulaması, yerel model kurulumunu uygulama arayüzü üzerinden halleder.
Tüm yerel seçenekleri mi karşılaştırıyorsunuz? Parakeet ve Whisper'dan Qwen3-ASR ve SenseVoice'a kadar Whisper Notes'taki her konuşma modeli, Whisper modelleri karşılaştırma sayfamızda dil dil karşılaştırılıyor. Whisper'ın kendisine mi yenisiniz? Whisper Transkripsiyon Rehberi ile başlayın — modelin ne olduğu, çalıştırmanın tüm yolları ve maliyeti.
