
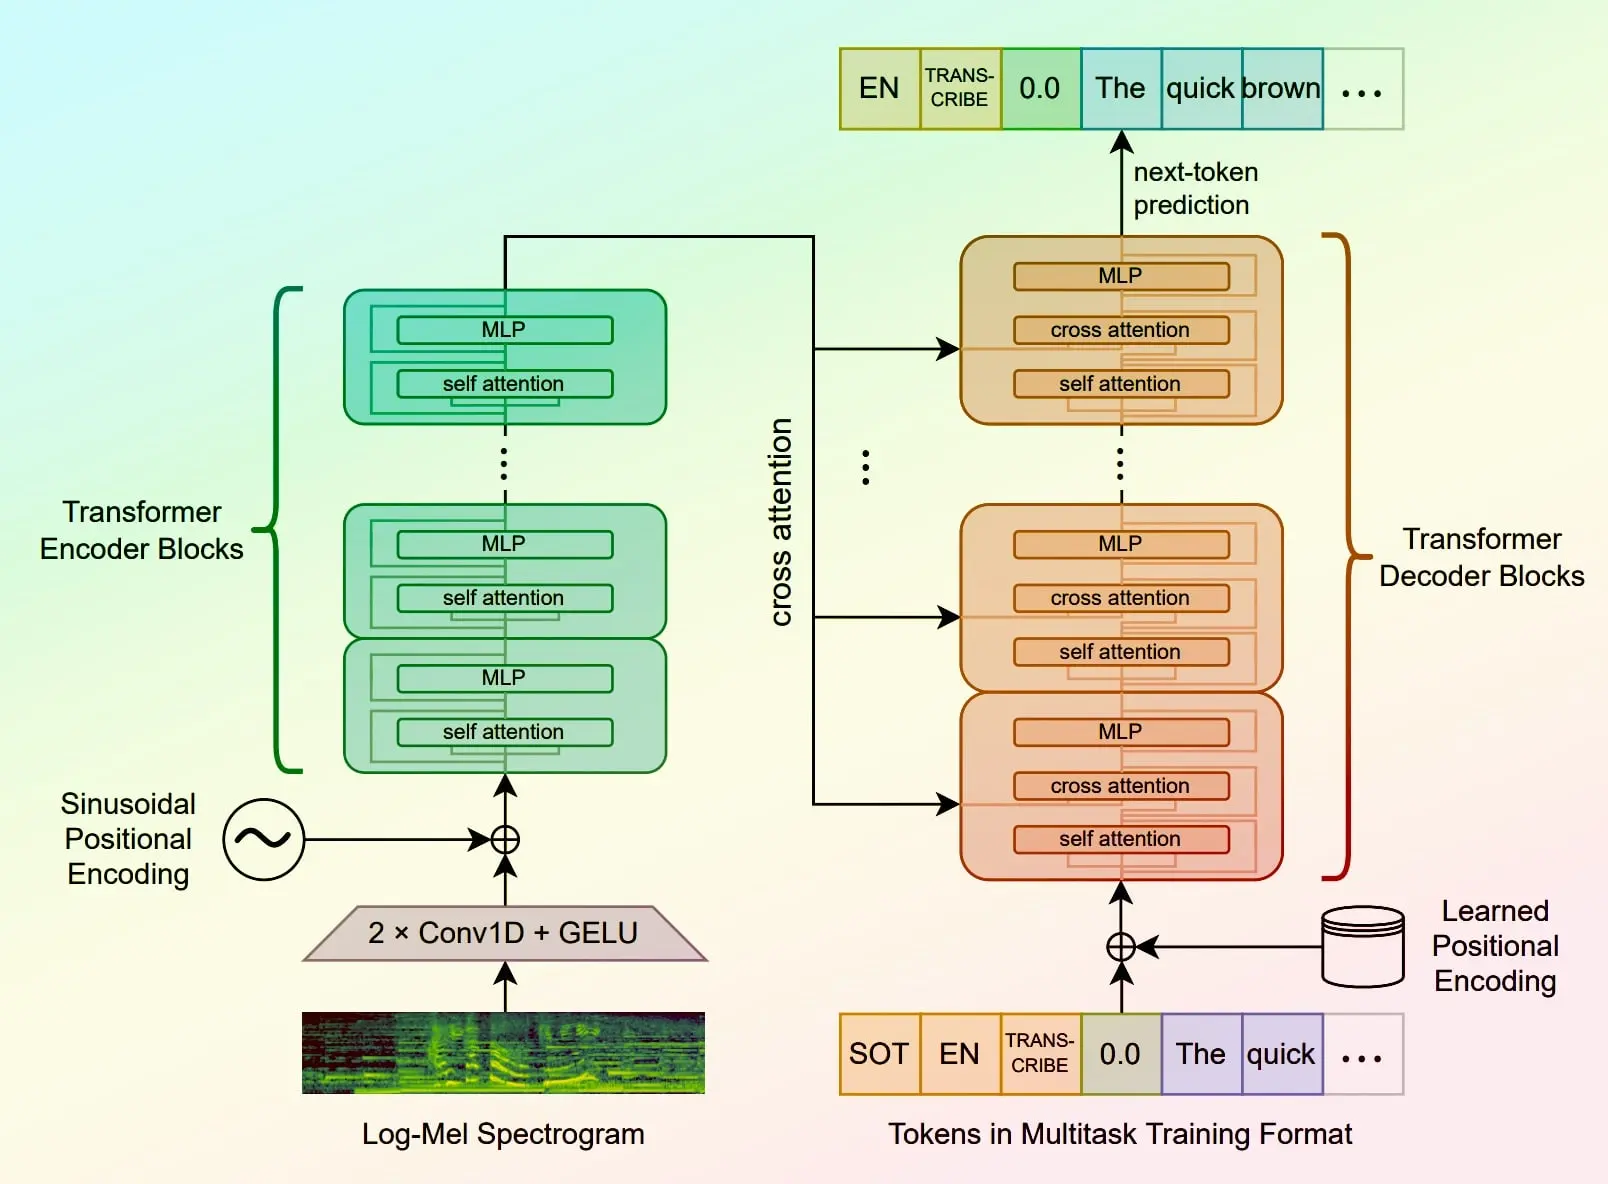
OpenAIs Whisper Large-v3 Turbo skærer dekoderen ned fra 32 lag til 4, så antallet af parametre falder fra 1,55 mia. til 809 mio. I vores test på Apple-chips transskriberede den den samme lyd ca. 5× hurtigere med næsten samme nøjagtighed. Whisper Notes har den med på Mac – både i Mac App Store-versionen og i Mac-appen fra vores hjemmeside – og udelader den bevidst på iPhone til fordel for mindre modeller, der passer bedre til telefonen.
V3 Turbo vs. V3: hvad er ændret?
Turbo er ikke en ny arkitektur. Det er præcis den samme Whisper Large-v3-model, hvor dekoderen er skåret ned fra 32 lag til 4 og derefter finjusteret, så nøjagtigheden kommer tilbage. Encoderen er uændret.
| Large-v3 Turbo | Large-v3 | |
|---|---|---|
| Parametre | 809 mio. | 1.550 mio. |
| Dekoderlag | 4 | 32 |
| Sprog | 100+ | 100+ |
| Oversættelsesopgave | Understøttes ikke | Understøttes |
| Licens | MIT | Apache 2.0 |
Metode: den samme 10 minutter lange lydfil blev transskriberet i den samme version af Whisper Notes på hver af de nævnte enheder. Tiderne er sekunder målt fra transskriberingen startede, til den færdige tekst forelå; kun modellen blev skiftet mellem V3 og Turbo.
Oversættelsesopgaven blev bevidst holdt ude af Turbos træningsdata. Den fulde Large-v3-model understøtter den, men Whisper Notes har Turbo med i stedet for den fulde Large-v3 – i Mac-appen fra vores hjemmeside kan AI-assistenten oversætte en transskription med den lokale Gemma-model.
Grundmodellen: hvad er Whisper Large-v3?
Whisper Large-v3 er OpenAIs førende open source-model til talegenkendelse, udgivet i november 2023. Den har 1,55 mia. parametre, bruger et spektrogram med 128 mel-bånd som input, er trænet på 5 millioner timers lyd (1 mio. timer med svage mærkninger + 4 mio. timer med pseudomærkninger) og understøtter 100+ sprog. På Hugging Face Open ASR Leaderboard har den en gennemsnitlig ordfejlrate (WER) på ~7,4 % – det nøjagtighedsloft, Turbo bliver målt op imod i resten af teksten. Hvordan Whisper Large V3 Turbo klarer sig sprog for sprog mod de andre modeller i Whisper Notes, kan du se i vores sammenligning af Whisper-modeller.
Hastighedstest: Whisper Notes på Apple-chips
I Whisper Notes til Mac kører Turbo via CoreML på Neural Engine. Så lang tid tog 10 minutters lyd:
| Enhed | Whisper V3 | V3 Turbo | Hurtigere med |
|---|---|---|---|
| iPhone 15 Pro | 425 s | 82 s | 5,2× |
| iPad Pro M2 | 380 s | 71 s | 5,4× |
| MacBook Pro M2 | 316 s | 63 s | 5,0× |
De 5× gælder specifikt for Whisper Notes på Apple-chips, hvor den mindre dekoder får gavn af optimeringen til Neural Engine. På GPU med frameworks som faster-whisper er forskellen mindre, ca. 2,7× (se testene fra fællesskabet nedenfor).
En præcisering om rækkerne for iPhone og iPad: det er testkørsler af modellen på den hardware, ikke den modelliste, iPhone-appen faktisk tilbyder. Whisper Notes til iPhone har ikke Large V3 Turbo – et bevidst valg, som forklares i tabellen pr. enhed nedenfor.
Nøjagtighed: sammenligning af WER
Hugging Face Open ASR Leaderboard tester begge modeller på de samme engelske datasæt. Turbos ordfejlrate ligger inden for et halvt procentpoint af V3 i alle testene:
| Datasæt | WER for Whisper Large-v3 Turbo | WER for Whisper Large-v3 |
|---|---|---|
| LibriSpeech Clean | 2,10 % | 2,01 % |
| LibriSpeech Other | 4,24 % | 3,91 % |
| GigaSpeech | 10,14 % | 10,02 % |
| Earnings22 | 11,63 % | 11,29 % |
| AMI | 16,13 % | 15,95 % |
| Gennemsnitlig WER | 7,83 % | 7,44 % |
V3 er en anelse mere præcis på alle datasæt, men forskellen er lille – 0,39 procentpoint i gennemsnit. I det meste almindelige transskriptionsarbejde vil du ikke mærke forskel.
I YouTube-commons-testen med lange optagelser (en af de største open source-test af talegenkendelse) får Turbo 13,40 % WER mod 13,20 % for V3 – og kører samtidig med en realtidsfaktor på 129,5× mod 55,3×. Det er 2,3× hurtigere med næsten samme nøjagtighed på almindelig lyd.
Hvor præcis er Turbo på koreansk, russisk og andre sprog?
Testene ovenfor er på engelsk. Ifølge OpenAIs modelkort koster den beskårne dekoder med 4 lag lidt mere nøjagtighed på andre sprog end på engelsk, og mest på sprog med færre træningsdata. På russisk og de fleste europæiske sprog ligger Turbo tæt på den fulde Large-v3 – og bruger du Whisper Notes, dækker den indbyggede model Parakeet (Moondreams Parakeet Ultra, videretrænet fra NVIDIA Parakeet V3) russisk og 24 andre europæiske sprog; Parakeet V3 kørte med ca. 60× realtid på Apple-chips.
Til kinesisk, japansk, koreansk og kantonesisk er SenseVoice langt hurtigere, med 115–131× realtid, og på Mac laver Qwen3-ASR 1.7B (Beta) færrest fejl. Turbo klarer sig godt på japansk og koreansk: i vores FLEURS-test lavede den færre fejl end SenseVoice på de to sprog. Whisper Notes har SenseVoice på iPhone og i begge Mac-versioner, ved siden af Turbo på Mac, så du kan vælge den rigtige model til hvert sprog i stedet for at køre alt gennem én model.
Hvilken lokal model til tale til tekst skal du bruge?
Large-v3 Turbo er den Whisper-model med den bredeste sprogdækning, du kan køre lokalt. Den er ikke den bedste model til de fleste enkeltopgaver, for på Apple-chips konkurrerer den med to specialister, der slår den inden for deres egne sprog. I Whisper Notes består det praktiske udvalg på Mac af fem modeller, de samme i Mac App Store-versionen og i Mac-appen fra vores hjemmeside – Parakeet, SenseVoice Small, Whisper Small, Whisper Large V3 Turbo og Qwen3-ASR 1.7B (Beta) – og valget afgøres næsten udelukkende af det sprog, du taler, og den hardware, du har, ikke af den rangliste, du læser.
Du transskriberer engelsk og kun engelsk
Brug Parakeet. Parakeet V3, som den er videretrænet fra, er både mere præcis og langt hurtigere: 6,32 % mod 7,83 % gennemsnitlig engelsk WER på Hugging Face Open ASR Leaderboard og 103× realtid på en M4 Pro, hvor Turbo nåede 14,3× på den samme Mac. Der findes ingen situation med kun engelsk, hvor Turbo er det bedre valg.
Du transskriberer europæiske sprog
Stadig Parakeet, hvis dit sprog er et af dens 25: bulgarsk, kroatisk, tjekkisk, dansk, hollandsk, engelsk, estisk, finsk, fransk, tysk, græsk, ungarsk, italiensk, lettisk, litauisk, maltesisk, polsk, portugisisk, rumænsk, russisk, slovakisk, slovensk, spansk, svensk og ukrainsk. På tværs af de 25 sprog i FLEURS ligger den i gennemsnit på 12,0 % WER – stort set det samme som den fulde Whisper Large V3 med 12,6 % – og kører med ca. 60× realtid på Apple-chips. Hvis dit europæiske sprog ikke er blandt dem (norsk, islandsk, serbisk og catalansk er ikke med), er Turbo din model.
Du transskriberer kinesisk, japansk, koreansk eller kantonesisk
Vil du have fart, så brug SenseVoice Small. Den dækker engelsk, forenklet og traditionelt kinesisk, kantonesisk, japansk og koreansk, og på den slags lyd er hastighedsforskellen ikke til at overse: en 27 minutter lang kinesisk podcast var færdig på 13,83 sekunder på en M4 Pro, mens Turbo brugte over to minutter på den samme fil. Vil du have færrest fejl, så brug Qwen3-ASR 1.7B (Beta) på Mac; på japansk og koreansk laver Turbo også færre fejl end SenseVoice. Parakeet dækker slet ikke disse sprog.
Du har brug for den bredest mulige sprogdækning
Brug Whisper Large V3 Turbo. Den dækker 101 sprog – arabisk, hindi, thai, hebraisk, vietnamesisk, indonesisk og de mange mindre sprog, som ingen af specialisterne dækker – med en engelsk nøjagtighed inden for et halvt procentpoint af den fulde Large-v3 og en større, men stadig brugbar forskel på sprog med færre træningsdata. Det er den opgave, Turbo har i dette udvalg: den er reserven, der altid dækker sproget. Den fulde oversigt pr. motor finder du i vores tabel over de sprog, Whisper understøtter.
Du har ældre hardware eller begrænset hukommelse
Brug Whisper Small. Den dækker de samme 101 sprog med en download på 600 MB mod ca. 2 GB for Turbo – forskellen mellem god plads og trængsel på en Mac med 8 GB, der også kører en browser. Prisen er nøjagtighed, og den er ikke lille: på tværs af de 25 europæiske FLEURS-sprog har Whisper Small i gennemsnit 29,8 % WER mod 12,0 % for Parakeet V3. Vælg den, når hukommelsen er den afgørende begrænsning, ikke når nøjagtigheden er.
Du transskriberer lange optagelser – forelæsninger, vidneafhøringer, interview på flere timer
Vælg den hurtigste model, der dækker dit sprog, for transskriptionstiden vokser med lydens længde. En hastighedsforskel, du aldrig ville bemærke på et lydnotat på to minutter, er forskellen mellem en kaffepause og en hel eftermiddag på en optagelse på tre timer – så brug kun Turbo til lange filer, når sproget virkelig kræver det, og regn med minutter frem for sekunder. Længden øger også Whispers anden risiko: jo længere filen er, jo flere stille passager er der, hvor en autoregressiv dekoder kan finde på ord, og derfor kører Whisper Notes stemmeaktivitetsdetektion før transskriptionen.
Side om side – alle tal i tabellen kommer fra vores egne test på Apple-chips eller fra de offentliggjorte test, der er nævnt under den:
| Model | Sprog | WER på engelsk | Hastighed i vores test | Hastighed i forhold til Whisper Large V3 Turbo | Hukommelse | Download |
|---|---|---|---|---|---|---|
| Parakeet V3 | 25 europæiske | 6,32 % | 103× realtid (M4 Pro); ~60× (M5 Air) | 7,2× hurtigere (103× mod 14,3×, M4 Pro) | maks. 0,09 GiB | 465 MB |
| SenseVoice Small | Engelsk, kinesisk (forenklet og traditionelt), kantonesisk, japansk, koreansk | Ikke med i denne test | Kinesisk podcast på 27 min. på 13,83 s (M4 Pro) | 9,0× hurtigere (118× mod 13,1×, M4 Pro) | maks. 0,95 GiB | ~450 MB |
| Whisper Small | 101 | Ikke med i denne test | ~4× den fulde Large-v3 | Ikke målt på den samme lyd | maks. 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 101 | 7,83 % | 14,3× realtid (M4 Pro); ~5× den fulde Large-v3 | Udgangspunkt | 2,4 GB | ~2 GB |
WER på engelsk er gennemsnittet på tværs af de engelske datasæt i Hugging Face Open ASR Leaderboard. SenseVoice Small og Whisper Small var ikke med i den engelske kørsel, så vi lader de felter stå uden tal i stedet for at gætte. På gennemsnittet for de 25 europæiske FLEURS-sprog er tallene 12,0 % for Parakeet V3, 12,6 % for den fulde Whisper Large V3 og 29,8 % for Whisper Small; Turbo blev ikke testet separat på det flersprogede sæt. Hastighederne er realtidsfaktorer fra vores egne kørsler på Apple-chips, bortset fra de to relative multiplikatorer, som er i forhold til den fulde Large-v3. Downloadstørrelserne er målt i Mac-versionen af Whisper Notes. Hukommelse er hver motors maksimale procesforbrug i vores egen FLEURS-kørsel på en MacBook Air med M5 – Parakeet V3, SenseVoice Small og Whisper Small blev målt på den måde. De 2,4 GB for Whisper Large V3 Turbo er det arbejdsforbrug, appen selv angiver, ikke et maksimum, vi har målt. De to hastighedsforhold er beregnet ud fra realtidsfaktorer målt på den samme lyd på en M4 Pro – Parakeet V3 på en engelsk fil på 5 minutter, SenseVoice Small på en kinesisk podcast på 27 minutter; Whisper Small blev ikke timet på nogen af dem. Podcasttesten blev kørt på en tidligere version af appen; den hastighed, modelkortet angiver for SenseVoice Small i dag, 115–131×, er omtrent den samme.
Alle disse modeller kører helt på enheden i Whisper Notes, og du vælger motor i Indstillinger: iPhone-appen har Parakeet, Whisper Small og SenseVoice Small; begge Mac-versioner har desuden Whisper Large V3 Turbo og Qwen3-ASR 1.7B (Beta).
Samme udvalg, tilpasset hver enhed
Hvilke af dem du faktisk kan bruge, afhænger af enheden. De to Mac-versioner, Mac App Store-versionen og Mac-appen fra vores hjemmeside, har de samme modeller; iPhone-appen har færre:
| Model | iPhone-appen | Mac, begge versioner |
|---|---|---|
| Parakeet | Indbygget | Inkluderet (standard) |
| SenseVoice Small | Valgfri download | Valgfri download |
| Whisper Small | Valgfri download | Valgfri download |
| Qwen3-ASR 1.7B (Beta) | Ikke tilbudt | Valgfri download (~2,5 GB; macOS 15 eller nyere) |
| Apple Speech | Systemmotor på iOS 26; iOS downloader sprogpakken | Systemmotor på macOS 26 eller nyere; macOS downloader sprogpakken |
| Whisper Large V3 Turbo | Ikke tilbudt – med vilje | Valgfri download (~2 GB) |
Den sidste række er en produktbeslutning, ikke en forglemmelse. Turbo er en download på ca. 2 GB, der bruger omkring 2,4 GB hukommelse, mens den kører – rimeligt på en Mac med Apple-chip, urimeligt på de fleste iPhones, hvor den samme lagerplads og hukommelse giver dig et udvalg af modeller, der er hurtigere og, på deres egne sprog, mere præcise. Derfor har iPhone-appen Parakeet indbygget og tilbyder Whisper Small og SenseVoice Small som valgfri downloads: Parakeet til de 25 europæiske sprog med 6,32 % WER på engelsk, SenseVoice til CJK og kantonesisk og Whisper Small som reserven med 101 sprog, der passer fint ind i en telefons hukommelse. Modeller i den rette størrelse til hver enhed i stedet for den samme fil på 2 GB på alt, der teknisk kan rumme den.
Hver model ovenfor har også en svaghed, som er værd at kende, før du vælger den – den ærlige version står længere nede under Hvor fejler hver model? Alle modeller side om side, med fejlrater på 42 sprog, finder du i vores sammenligning af Whisper-modeller.
Test fra fællesskabet: GPU og CPU
Uafhængige test fra faster-whisper- og whisper.cpp-fællesskaberne viser ensartede resultater på tværs af hardware. Transskription af 13 minutters lyd med faster-whisper på GPU:
| Model | Præcision | Tid | GPU-hukommelse | WER |
|---|---|---|---|---|
| Large-v3 Turbo | fp16 | 19,2 s | 2.537 MB | 1,92 % |
| Large-v3 | fp16 | 52,0 s | 4.521 MB | 2,88 % |
| Large-v3 Turbo | int8 | 19,6 s | 1.545 MB | 1,92 % |
| Distil-Large-v3 | fp16 | 26,1 s | 2.409 MB | 2,39 % |
Kilde: faster-whisper-test på NVIDIA-GPU, valideringsdelen af LibriSpeech clean. Turbo int8 bruger kun 1,5 GB VRAM – den kan køre på en GPU med 2 GB.
Batchbehandling på en RTX 3060 Laptop (6 GB VRAM, int8-præcision) øger forspringet yderligere:
| Model | Sekventielt | I batch (10) | WER i batch |
|---|---|---|---|
| Large-v3 Turbo | 46,1 s | 18,7 s | 7,7 % |
| Large-v3 | 230,8 s | 43,0 s | 7,9 % |
| Large-v2 | 178,3 s | 43,2 s | 8,8 % |
| Medium | 113,3 s | 26,3 s | 8,9 % |
Kilde: NilaierMusic-test, Intel i7-12650H + RTX 3060 Laptop 6 GB, fransk lyd, int8-præcision.
Med batchbehandling får Turbo den laveste WER af alle testede modeller (7,7 %) og er samtidig den hurtigste. Det gør den til det oplagte valg i produktion.
Turbo vs. Medium vs. alle Whisper-modelstørrelser
Før Turbo var Medium det sædvanlige kompromis: acceptabel nøjagtighed ved en tålelig hastighed. Turbo gør det kompromis overflødigt – med 809 mio. parametre er den kun lidt større end Medium (769 mio.), men giver nøjagtighed på niveau med de store modeller ved flere gange hastigheden. Her er hele modelfamilien side om side:
| Model | Parametre | Diskplads | Relativ hastighed | Nøjagtighedsniveau |
|---|---|---|---|---|
| tiny | 39 mio. | ~75 MB | ~10× | Lavest |
| base | 74 mio. | ~142 MB | ~7× | Lav |
| small | 244 mio. | ~466 MB | ~4× | Middel |
| medium | 769 mio. | ~1,5 GB | ~2× | Høj |
| large-v3 | 1.550 mio. | ~2,9 GB | 1× (udgangspunkt) | Højest |
| large-v3-turbo | 809 mio. | ~1,6 GB (modelfil; ca. 2 GB at downloade i Whisper Notes) | ~5× på Apple-chips | Næsten højest |
Turbo blev udgivet 30. september 2024 og har 809 mio. parametre. Hvis du valgte Medium for at spare diskplads eller tid, slår Turbo den nu på både nøjagtighed og hastighed med omtrent samme størrelse.
Whisper Notes har kun to af rækkerne i tabellen med – Whisper Small og Whisper Large V3 Turbo. Tiny, base og medium er udeladt med vilje: på Apple-chips bliver hver af dem overgået af en anden model i udvalget. Alt, hvad du ville have brugt tiny eller base til, klarer Parakeet hurtigere og langt mere præcist; alt, hvad du ville have brugt medium til, klarer Turbo bedre med en lignende størrelse. Whisper Small er med, fordi den er den mindste model, der dækker alle 101 sprog.
Kendte begrænsninger (og hvordan Whisper Notes håndterer dem)
Ingen indbygget oversættelse
Turbo blev trænet uden oversættelsesdata. Den transskriberer kun på kildesproget – i modsætning til Large-v3, der kan oversætte lyd→engelsk.
Whisper Notes – i Mac-appen fra vores hjemmeside kan du slå AI-funktioner til, så den lokale Gemma-model oversætter en transskription til det sprog, du vælger, uanset hvilken talemodel der har lavet den.
Flere hallucinationer på støjende lyd
Brugere i fællesskabet melder, at Turbo hallucinerer mere end V3 på meget korte klip eller støjende optagelser. Det er ventet med den mindre dekoder (4 lag mod 32).
Whisper Notes – kører Silero VAD, før Whisper transskriberer. Den finder de afsnit, hvor der bliver talt, og springer stilheden over, så modellen kun behandler rigtig tale.
Hvor fejler hver model?
Hver model i udvalget har noget, den er decideret dårlig til, og den ærlige liste er mere nyttig end endnu en testtabel. Whisper – både Small og Large V3 Turbo – hallucinerer i stilhed. Dekoderen er autoregressiv: den forudsiger det næste token, uanset om der er mere at høre, så en stille passage kan komme tilbage som en gentaget sætning, en løsreven linje som „Tekstet af …“ eller en flydende sætning, som ingen har sagt. Med sin dekoder på 4 lag gør Turbo det lidt oftere end den fulde Large-v3 på meget korte eller støjende klip. Stemmeaktivitetsdetektion fjerner det meste ved slet ikke at sende stilheden til modellen, og Parakeet V3 fandt på langt færre ord i vores test med stilhed – men ingen talemodel fortjener et „aldrig“, og du bør stadig læse en transskription igennem, før du stoler på den.
Parakeet har en fast grænse på 25 sprog, og alle 25 er europæiske. Den kan ikke kinesisk, japansk, koreansk, kantonesisk, arabisk, hindi, thai eller hebraisk – og den advarer dig ikke, når lyden glider uden for dens sprog; den skriver bare vrøvl, der lyder sikkert. SenseVoice Small er endnu smallere: engelsk, forenklet og traditionelt kinesisk, kantonesisk, japansk og koreansk og intet andet. Den er den hurtigste model her på det materiale, den er bygget til, og det forkerte værktøj til alt andet. Whisper Small er den billigste at køre og den mindst præcise – 29,8 % gennemsnitlig WER på tværs af de 25 europæiske FLEURS-sprog mod 12,0 % for Parakeet V3, og det ses først på egennavne, fagord og tale med accent.
Og de koster alle sammen lagerplads og hardware. Det er rigtige filer på din disk, ikke et API-kald: Turbo er en download på ca. 2 GB, der bruger omkring 2,4 GB hukommelse under transskriptionen, SenseVoice Small ca. 450 MB, Whisper Small 600 MB, og Parakeet er indbygget i appen. Hele udvalget kører kun på Apple-chips – macOS 14 eller nyere på M1 og nyere, iOS 18 eller nyere på iPhone. Der findes ingen version til Mac med Intel-processor, ingen til Windows og ingen til Android, og intet her transskriberer i realtid: Whisper Notes behandler en optagelse, når du har stoppet den, ikke mens du taler.
Hvilken model skal du bruge?
| Engelsk / europæiske sprog | Parakeet V3 – ~60× realtid på Apple-chips og 6,32 % WER på engelsk mod 7,83 % for Turbo |
| Kinesisk / japansk / koreansk | SenseVoice til fart, 115–131× realtid; Qwen3-ASR 1.7B (Beta) på Mac til færrest fejl |
| Andre sprog | Whisper Large V3 Turbo – 100+ sprog, høj nøjagtighed, langsommere |
| Ældre Mac / lidt hukommelse | Whisper Small – 101 sprog med en download på 600 MB, men med en reel pris i nøjagtighed |
| På iPhone | Parakeet indbygget, med Whisper Small og SenseVoice som valgfri downloads – Turbo findes kun på Mac, med vilje |
Ofte stillede spørgsmål om Whisper Large-v3 Turbo
Hvilken lokal model til tale til tekst skal jeg bruge?
Det afhænger af dit sprog, ikke af ranglisten. Til engelsk og 24 andre europæiske sprog er Parakeet V3 både hurtigere og mere præcis end Whisper Large V3 Turbo (6,32 % mod 7,83 % gennemsnitlig engelsk WER på Hugging Face Open ASR Leaderboard; 103× mod 14,3× realtid på den samme M4 Pro). Til kinesisk, japansk, koreansk eller kantonesisk er SenseVoice Small den hurtige mulighed – en 27 minutter lang kinesisk podcast på 13,83 sekunder – og på Mac laver Qwen3-ASR 1.7B (Beta) færrest fejl. Til alle andre af Whispers 101 sprog, fx arabisk, hindi eller thai, er Whisper Large V3 Turbo det rigtige valg. På en ældre maskine eller med begrænset hukommelse dækker Whisper Small de samme 101 sprog med en download på 600 MB, men med en reel pris i nøjagtighed.
Kan jeg køre Whisper Large V3 Turbo på min iPhone?
Ikke i Whisper Notes, og det er bevidst. Turbo er en download på ca. 2 GB, der bruger omkring 2,4 GB hukommelse under transskriptionen – fornuftigt på en Mac med Apple-chip, spild på en telefon. iPhone-appen har Parakeet indbygget og tilbyder Whisper Small og SenseVoice Small som valgfri downloads, der tilsammen dækker 101 sprog og CJK med en brøkdel af pladsforbruget. Whisper Large V3 Turbo findes i begge Mac-versioner: den fra Mac App Store og den fra vores hjemmeside.
Hvad er forskellen på Whisper Large-v3 og Large-v3 Turbo?
Large-v3 Turbo beholder encoderen fra Large-v3, men skærer dekoderen ned fra 32 lag til 4. Derfor er den meget hurtigere og ligger stadig tæt på nøjagtigheden for Large-v3 ved transskription. Ulempen er, at Turbo ikke understøtter Whispers indbyggede oversættelsesopgave.
Understøtter faster-whisper Large-v3 Turbo?
Ja. faster-whisper understøtter Large-v3 Turbo via CTranslate2-konverteringer, og test fra fællesskabet viser, at Turbo er et godt valg, når der er begrænset VRAM. I testen ovenfor brugte Turbo int8 ca. 1,5 GB VRAM.
Understøtter whisper.cpp Large-v3 Turbo?
Ja. whisper.cpp kan køre konverterede GGML/GGUF-versioner af Whisper Large-v3 Turbo. Hvis du bygger din egen lokale transskriptionsløsning, er Turbo ofte lettere at få plads til på almindelig hardware end den fulde Large-v3.
Hvor kan jeg downloade openai/whisper-large-v3-turbo?
De officielle modelvægte ligger hos OpenAI på Hugging Face. Brugere af Whisper Notes behøver ikke downloade dem manuelt: Mac-appen klarer opsætningen af den lokale model i appens brugerflade.
Vil du sammenligne alle de lokale muligheder? Alle talemodeller i Whisper Notes, fra Parakeet og Whisper til Qwen3-ASR og SenseVoice, sammenlignes sprog for sprog på vores side med sammenligning af Whisper-modeller. Er du ny i Whisper? Start med guiden til Whisper-transskription – hvad modellen er, alle måder at køre den på, og hvad det koster.
 Download til iOS