Seit macOS 26 und iOS 26 bietet Apple eine neue Generation der Spracherkennung auf dem Gerät — SpeechAnalyzer und SpeechTranscriber, im Folgenden kurz Apple Speech. Sie ist deutlich genauer als die alte Diktier-Engine. Wir wollten wissen, wie sie sich im praktischen Einsatz mit den offenen Modellen auf dem Gerät vergleicht, die man herunterlädt — Whisper, Parakeet, Qwen3-ASR und SenseVoice: Ist Apples integrierte Spracherkennung inzwischen gut genug, dass du ganz auf eine Transkriptions-App verzichten könntest?
Wie viel besser ist sie als die Diktierfunktion, die du bereits hattest?
Bislang nutzte die Spracherkennung eines Mac die Engine aus der SFSpeechRecognizer-Ära, die auch die systemweite Diktierfunktion heute noch verwendet (DictationTranscriber). Neu in macOS 26 und iOS 26 sind die SpeechAnalyzer-API und ihr SpeechTranscriber-Modul. Wir haben beide auf demselben Mac mit dem FLEURS-Testsplit ausgeführt, etwa 150 Sätze und 30 Minuten pro Sprache.
| Sprache | Apple Dictation | Apple Speech |
|---|---|---|
| Koreanisch | 7,11 | 4,31 |
| Italienisch | 6,93 | 4,39 |
| Spanisch (Lateinamerika) | 8,43 | 5,41 |
| Deutsch | 12,69 | 6,26 |
| Japanisch | 9,37 | 6,36 |
| Französisch | 17,10 | 7,61 |
| Chinesisch | 10,28 | 7,97 |
| Kantonesisch | 10,18 | 8,69 |
| Englisch | 13,83 | 8,80 |
| Portugiesisch (Brasilien) | 10,85 | 9,35 |
Alle Sprachen, die beide Apple-Engines sauber gemessen haben, geordnet nach der Fehlerrate von Apple Speech; Grün markiert den besseren Wert in der Zeile. Derselbe Durchlauf, dieselben Clips, derselbe Mac. CER für Japanisch, Koreanisch, Chinesisch und Kantonesisch, WER für den Rest.
Apple Speech ist in allen zehn Sprachen genauer, die beide Engines sauber gemessen haben. Bei Französisch und Deutsch fallen mehr als die Hälfte der Fehler weg, bei der Mediansprache etwa ein Drittel und bei brasilianischem Portugiesisch sowie Kantonesisch etwa einer von sieben Fehlern.
Die Diktierfunktion deckt weiterhin mehr Sprachen ab. Apple Speech lieferte in diesem Durchlauf Ergebnisse für 21 der 83 Sprachkonfigurationen, die Diktierfunktion für 33, darunter die drei, die der neuen Engine hier fehlen: Niederländisch, Polnisch und Russisch mit 17,34, 13,50 und 13,13. Auch hier gibt es keine feste Liste zum Zitieren. Die Sprachressourcen gehören zu macOS, daher fragt eine App zur Laufzeit ab, was auf einem bestimmten Computer vorhanden ist.
Kannst du also auf die heruntergeladenen Modelle verzichten?
Sechs Engines, dieselben Clips, ein Mac. Die folgenden zehn Sprachen gehören zu den meistgenutzten; ihre feste Reihenfolge hat nichts mit den Ergebnissen zu tun.
| Sprache | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Englisch | 8,80 | 4,49 | 5,49 | 7,04 | 6,89 | 8,46 |
| Deutsch | 6,26 | 2,85 | 4,05 | 8,67 | 6,26 | — |
| Niederländisch | — | 7,36 | 5,69 | 16,75 | 8,58 | — |
| Russisch | — | 5,65 | 5,13 | 11,37 | 7,12 | — |
| Polnisch | — | 12,59 | 5,45 | 15,81 | 8,30 | — |
| Japanisch | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Koreanisch | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Französisch | 7,61 | 4,57 | 5,97 | 13,24 | 5,83 | — |
| Chinesisch | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Spanisch (Lateinamerika) | 5,41 | 3,38 | 3,62 | 6,22 | 4,86 | — |
Zehn der meistgenutzten Sprachen, eine Engine pro Spalte. Jede Zelle zeigt die Fehlerrate der Engine; niedriger ist besser. Grün markiert den niedrigsten Wert der Zeile, weiß den zweitniedrigsten. CER für Japanisch, Koreanisch und Chinesisch, WER für den Rest, nie zu einer einzigen Zahl zusammengefasst. Unser eigener FLEURS-Durchlauf, vom Team von Whisper Notes, auf einem M5 MacBook Air, vorgelesene Sprache.
Kurznamen: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Ein Gedankenstrich bedeutet, dass die Engine kein Modell für diese Sprache hat.
Qwen3-ASR 1.7B hat in sechs der zehn Sprachen die niedrigste Fehlerrate, Whisper Large V3 Turbo in den anderen vier und Apple Speech in keiner. Am nächsten kommt es bei Koreanisch mit 0,77 Punkten Rückstand auf den Zeilenbesten, danach bei Japanisch mit 1,06 und Chinesisch mit 1,48; dort liegt es bei 7,97 gleichauf mit Whisper Large V3 Turbo. Am weitesten zurück liegt es bei Englisch mit 8,80 (Apple Speech) gegenüber 4,49 (Qwen3-ASR 1.7B); für Niederländisch, Polnisch und Russisch gibt es überhaupt kein Ergebnis von Apple Speech.
Gegenüber Whisper Small war Apple Speech in acht der zehn Sprachen genauer, die beide sauber gemessen haben. Verloren hat es bei Englisch mit 8,80 (Apple Speech) gegenüber 7,04 (Whisper Small) und bei brasilianischem Portugiesisch mit 9,35 gegenüber 8,61.
Ein im Juli veröffentlichter Benchmark verglich Apple Speech bei Englisch mit Whisper Small und sah Apple vorn. Es spielt eine Rolle, welches Whisper verglichen wird, ebenso wie die verwendeten Clips. Dort kam LibriSpeech zum Einsatz, also vorgelesene Passagen von Hörbuchsprechern; bei uns FLEURS, mit vielen verschiedenen Personen, die Wikipedia-Sätze vorlesen. Unser Durchlauf zeigt den Abstand bei Englisch, kann seine Ursache aber nicht erklären.
Gegenüber Whisper Large V3 Turbo kehrt sich die Reihenfolge um. Apple Speech liegt in acht dieser zehn Sprachen zurück, erreicht bei Chinesisch ebenfalls 7,97 und führt nur bei Kantonesisch mit 8,69 (Apple Speech) gegenüber 36,75 (Whisper Large V3 Turbo) — siehe die kantonesische Zeile weiter unten. In OpenAIs Versionshinweisen zu Turbo gehört Kantonesisch zu den Sprachen, bei denen das Modell am stärksten nachlässt; 36,75 ist also eine bekannte Schwäche von Whisper und keine Eigenheit unseres Durchlaufs.
Bei Koreanisch erkennt Apple Speech etwa eines von 23 Zeichen falsch. Das genaueste Modell in diesem Durchlauf, Qwen3-ASR 1.7B, liegt bei etwa einem von 28: 4,31 (Apple Speech) gegenüber 3,54 (Qwen3-ASR 1.7B).
Parakeet V3 hat eine Downloadgröße von 465 MB und ist in jeder europäischen Sprache genauer, die beide abdecken: 6,89 (Parakeet V3) gegenüber 8,80 (Apple Speech) bei Englisch, 5,83 gegenüber 7,61 bei Französisch, 4,86 gegenüber 5,41 bei Spanisch, 3,43 gegenüber 4,39 bei Italienisch und 6,49 gegenüber 9,35 bei brasilianischem Portugiesisch; bei Deutsch liegen beide mit 6,26 gleichauf. Es hat kein Modell für Japanisch, Koreanisch, Chinesisch oder Kantonesisch; dort ist Apple Speech das einzige der beiden, das verfügbar ist.
Zu den sechs Zeilen, die Qwen3-ASR 1.7B anführt, gehören Englisch, Deutsch, Französisch und Spanisch.
SenseVoice Small ist mit 162,3× Echtzeit die schnellste Engine hier und liegt bei Chinesisch und Englisch auf dem Niveau von Apple Speech: 7,69 (SenseVoice Small) gegenüber 7,97 (Apple Speech) sowie 8,46 gegenüber 8,80. Bei Koreanisch liegt es mit 7,85 (SenseVoice Small) gegenüber 4,31 (Apple Speech) weit zurück.
Größe und Geschwindigkeit
| Engine | Geschwindigkeit | Maximaler Speicherbedarf | Download |
|---|---|---|---|
| SenseVoice Small | 162,3× Echtzeit | 0,95 GiB | 827 MB |
| Parakeet V3 | 75,6× Echtzeit | 0,09 GiB | 465 MB |
| Apple Speech | 30,8× Echtzeit | nicht ausgewiesen | <5 MB |
| Qwen3-ASR 1.7B | 11,1× Echtzeit | 2,43 GiB | rund 2,5 GB |
| Whisper Small | 7,9× Echtzeit | 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3,0× Echtzeit | 1,87 GiB | rund 1,6 GB |
Die Geschwindigkeit ist der Median jeder Engine über die dreizehn Sprachen, die dieser Beitrag sauber misst; gezählt werden nur die Sprachen, die sie tatsächlich verarbeitet hat. Es ist der Durchsatz bei isolierter Verarbeitung einzelner Elemente, ein Diagnosewert und keine Produktlatenz. Der maximale Speicherbedarf ist der Höchstwert der Prozessgruppe in diesem Durchlauf. Apple Speech decodiert in einem macOS-Dienst, der nicht der aufrufenden App gehört, deshalb wäre dort keine Zahl mit den anderen fünf vergleichbar.
Apple Speech lief mit 30,8× Echtzeit, hinter Parakeet V3 mit 75,6× und SenseVoice Small mit 162,3×. Sein Sprachpaket wird einmal von macOS heruntergeladen und von allen Apps gemeinsam genutzt, daher wird im eigenen Prozess der App nichts dafür reserviert. Der Dienst, der die Decodierung übernimmt, nutzt dennoch Speicher, den wir nicht exakt zuordnen können; deshalb geben wir dort statt einer Null keine Zahl an.
Whisper Large V3 Turbo ist mit 3,0× Echtzeit die langsamste Engine hier und hat in vier der zehn Zeilen die niedrigste Fehlerrate; auf der Festplatte belegt es rund 1,6 GB. Qwen3-ASR 1.7B führt die anderen sechs an, bei rund 2,5 GB auf der Festplatte und einem Spitzenwert von 2,43 GiB. Whisper Small ist mit 600 MB der faire Vergleich für eine integrierte Engine.
Für welche Sprachen eignet sich Apple Speech?
Sprache für Sprache:
- Englisch: keine gute Wahl. Apple Speech erreichte 8,80; Qwen3-ASR 1.7B (4,49) oder Whisper Large V3 Turbo (5,49) ist deutlich genauer.
- Deutsch: keine gute Wahl. Apple Speech erreichte 6,26; Qwen3-ASR 1.7B (2,85) oder Whisper Large V3 Turbo (4,05) ist deutlich genauer.
- Niederländisch, Russisch und Polnisch: Apple Speech hat für diese drei kein Modell. Whisper Large V3 Turbo war in allen drei am genauesten, mit 5,69, 5,13 und 5,45.
- Japanisch: brauchbar. Apple Speech erreichte 6,36, hinter Whisper Large V3 Turbo mit 5,30.
- Koreanisch: brauchbar. Apple Speech erreichte 4,31, hinter Qwen3-ASR 1.7B mit 3,54.
- Französisch: keine gute Wahl. Apple Speech erreichte 7,61; Qwen3-ASR 1.7B (4,57) oder Parakeet V3 (5,83) ist deutlich genauer.
- Chinesisch: brauchbar. Apple Speech erreichte 7,97 und liegt gleichauf mit Whisper Large V3 Turbo; am genauesten war Qwen3-ASR 1.7B mit 6,49.
- Spanisch: keine gute Wahl. Apple Speech erreichte 5,41; Qwen3-ASR 1.7B (3,38) oder Whisper Large V3 Turbo (3,62) ist deutlich genauer.
Bei der Genauigkeit gewinnen weiterhin die heruntergeladenen Modelle: Jede Zeile der Haupttabelle wird von Qwen3-ASR 1.7B oder Whisper Large V3 Turbo angeführt. Apple Speech ist für Koreanisch, Japanisch und Chinesisch eine echte Option; für europäische Sprachen ist Parakeet V3 die erste Wahl.
In Whisper Notes für Mac gilt: Parakeet V3 ist weiterhin der Standard. In der Mac-App, die du von unserer Website herunterlädst, steht Apple Speech unter macOS 26 oder neuer als optionales Modell bereit, und die App bietet eine Sprache nur an, wenn macOS für deinen Mac Unterstützung dafür meldet.
Apple Speech ist in diesem Beitrag die Kurzbezeichnung für Apples SpeechTranscriber, die lokale API, die jede Mac-App ab macOS 26 aufrufen kann. Es ist eine Engine des Systems und kein Modell zum Herunterladen: Whisper Notes für Mac kann es in der Version von unserer Website nutzen, das Sprachpaket kommt von macOS. Die Modelle, die die App selbst herunterlädt, sind weiterhin Whisper, Parakeet V3, SenseVoice und Qwen3-ASR in dieser Version sowie Whisper, Parakeet V3 und SenseVoice am iPhone und in der Version aus dem Mac App Store. Die Tabelle nach Engine ist unsere Liste der Sprachen, die Whisper, Parakeet V3 und SenseVoice unterstützen.
Über die zehn Sprachen hinaus
| Sprache | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Italienisch | 4,39 | 2,58 | 2,58 | 7,64 | 3,43 | — |
| Kantonesisch | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Portugiesisch (Brasilien) | 9,35 | 5,17 | 5,44 | 8,61 | 6,49 | — |
| Hindi | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Vier weitere Sprachen aus demselben Durchlauf. Dieselben Spalten, Farben und Kurznamen wie oben; CER für Kantonesisch, WER für den Rest.
Das Hindi-Ergebnis von Apple Speech bleibt aus dem Ranking dieser Zeile heraus; der Grund folgt unten. Eine Fehlerrate kann über 100 % liegen, weil auch Einfügungen im Zähler zählen.
Italienisch liegt mit 4,39 (Apple Speech) hinter dem Gleichstand von Qwen3-ASR 1.7B und Whisper Large V3 Turbo bei 2,58. Kantonesisch ist die eine Sprache, in der Apple Speech vor Whisper Large V3 Turbo lag, mit 8,69 (Apple Speech) gegenüber 36,75 (Whisper Large V3 Turbo); Qwen3-ASR 1.7B liegt mit 6,44 vorn. Brasilianisches Portugiesisch liegt bei 9,35 (Apple Speech) und ist eine der beiden Zeilen, in denen Whisper Small mit 8,61 vorn liegt.
Hindi liefert ein andersartiges Ergebnis. Apple Speech schrieb die Hindi-Wörter mit englischen Buchstaben aus, statt sie so zu schreiben, wie Hindi geschrieben wird; dadurch zählt fast jedes Wort als falsch und die Rate steigt über 100 %. Bei Telugu, Urdu, Punjabi, Bengali, Nepali, Malayalam, Marathi, Kannada, Gujarati und Tamil kam das Ergebnis auf dieselbe Weise zurück, jeweils über 100 %; daher stehen sie nicht in der Tabelle.
So funktioniert SpeechAnalyzer
SpeechAnalyzer ersetzt die Spracherkennungs-API, die Apple seit iOS 10 besitzt, auf allen Apple-Plattformen außer watchOS. Eine App erstellt einen SpeechAnalyzer, weist ihm Module zu und führt ihm Audio als asynchrone Sequenz zu, die sie selbst befüllt; SpeechTranscriber ist das Modul, das Sprache in Text umwandelt. Die Ergebnisse kommen als zweite Sequenz zurück, meist in einem anderen Task, und jeder Puffer sowie jedes Ergebnis ist mit einem Zeitcode auf der eigenen Zeitleiste des Audios versehen.
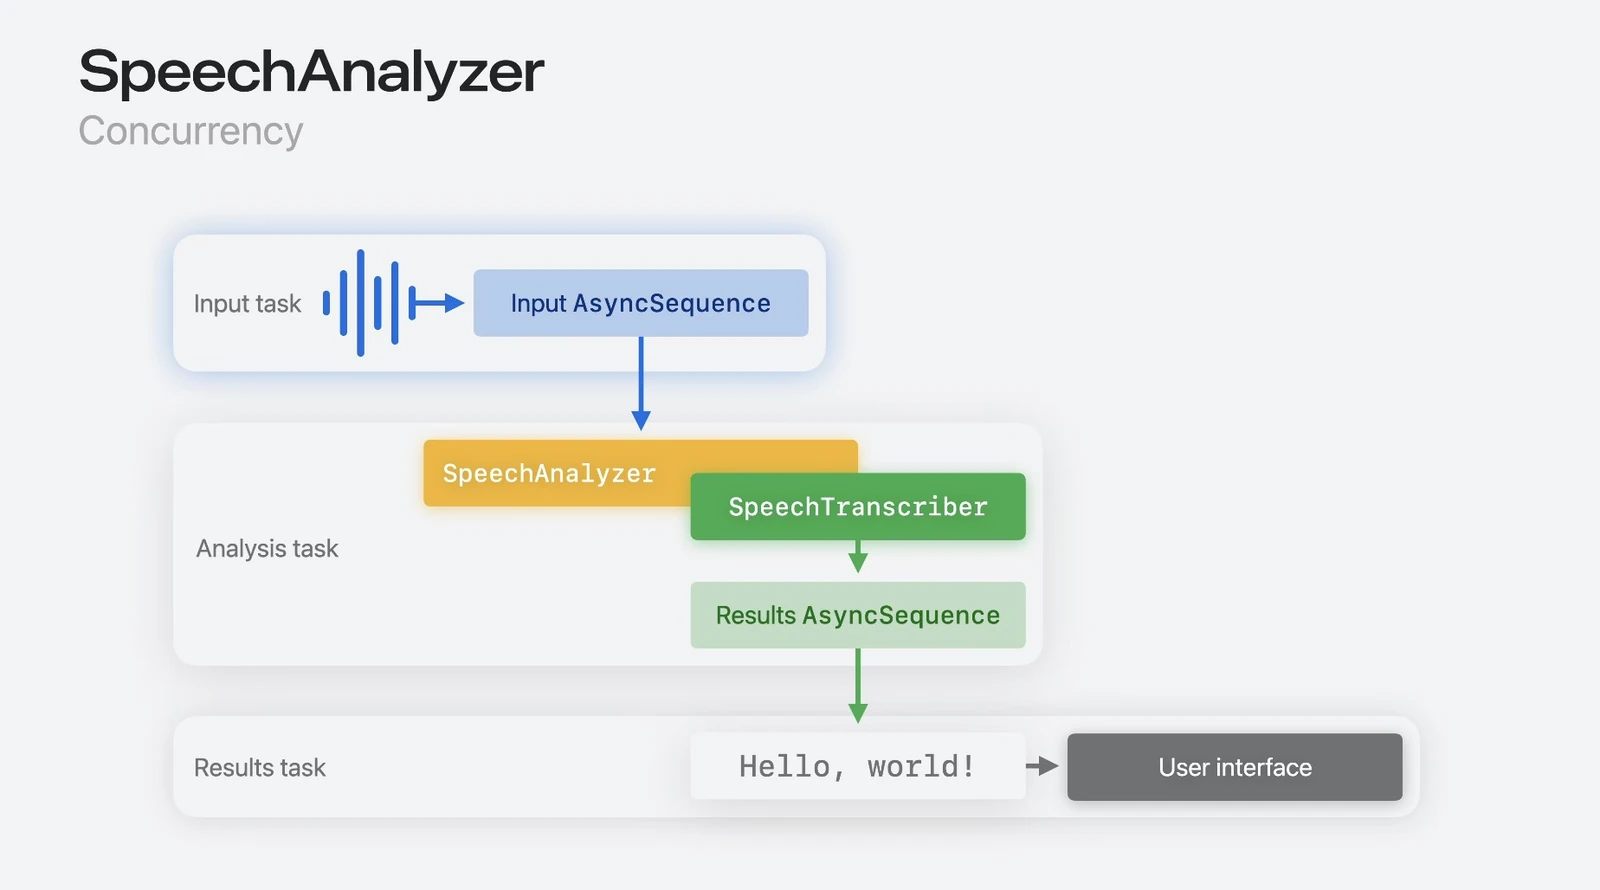
Eine Sitzung, drei Tasks: Audio geht als AsyncSequence hinein, SpeechAnalyzer und SpeechTranscriber analysieren es, und die Ergebnisse kommen als zweite AsyncSequence zurück, die die Benutzeroberfläche ausliest. Quelle: Apple, WWDC25 Session 277.
Ergebnisse treffen zweimal ein. Alles innerhalb des von Apple so genannten flüchtigen Bereichs kann noch durch ein besseres Ergebnis ersetzt werden; alles außerhalb ist endgültig. So kann eine App schon während des Sprechens ein vorläufiges Transkript anzeigen und es anschließend korrigieren. Apple nennt fünf Entwicklungsziele für das SpeechTranscriber-Modell: lange Audioaufnahmen, gesprochene Unterhaltungen, weit entfernte Sprecher, geringe Latenz und Datenschutz, also die Ausführung auf dem Gerät. Notizen, Sprachmemos, Journal und Anrufzusammenfassungen bauen darauf auf.
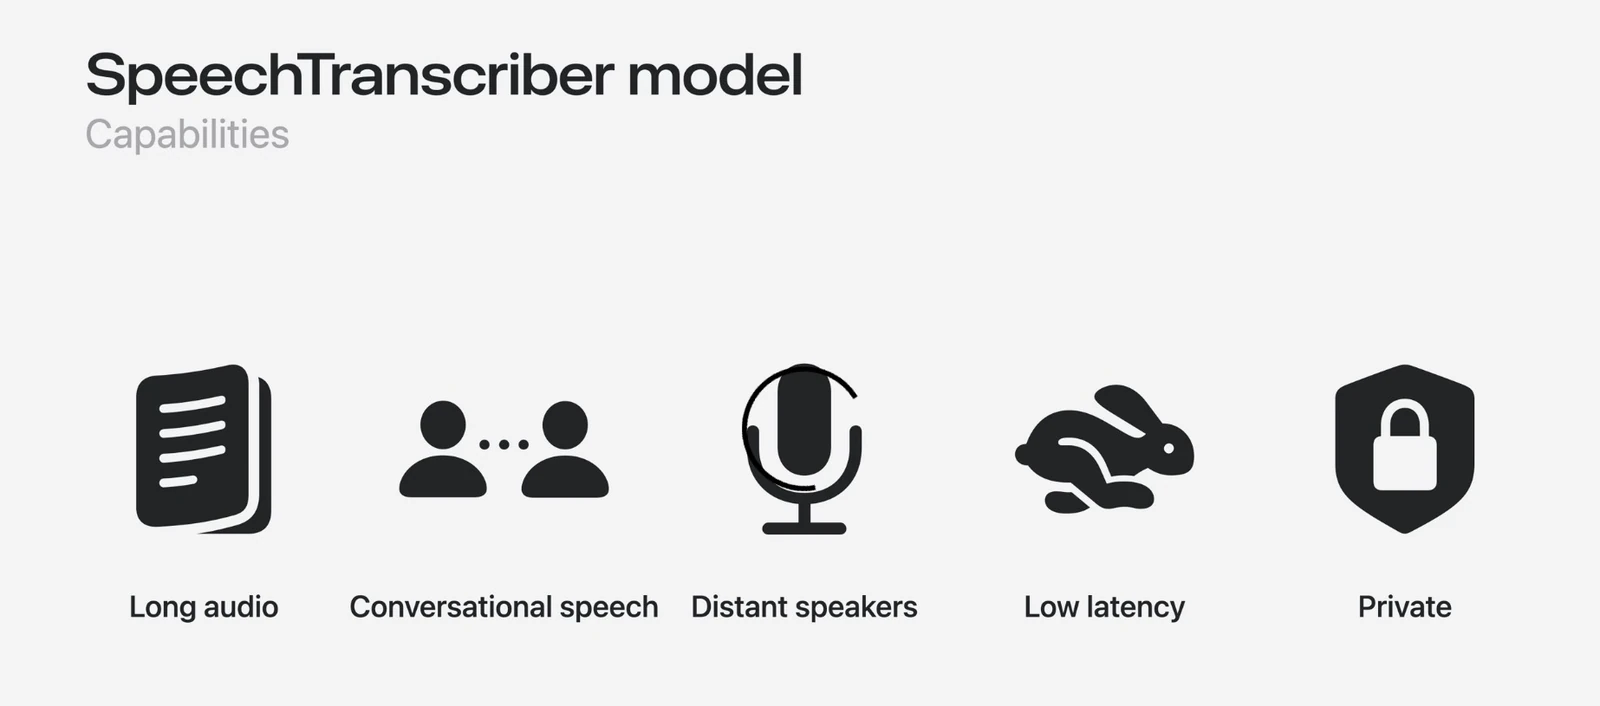
Die fünf von Apple genannten Entwicklungsziele für das SpeechTranscriber-Modell. Quelle: Apple, WWDC25 Session 277.
Die Modelle sind nicht Bestandteil einer App. Sie werden über AssetInventory von Apples Servern heruntergeladen, vom System gespeichert und aktualisiert sowie von Apps gemeinsam genutzt. Sie vergrößern den Download der App nicht, und die Decodierung findet außerhalb des aufrufenden Prozesses statt. Wo SpeechTranscriber für eine Sprache oder ein Gerät kein Modell hat, übernimmt DictationTranscriber mit denselben Modellen wie die Systemdiktierfunktion.
Methode und Einschränkungen
Fünf der sechs Engines in diesen Tabellen sind Modelle, die Whisper Notes herunterlädt. Jede Engine transkribierte dieselben Clips in derselben Reihenfolge, einzeln, auf einem M5 MacBook Air (32 GB, macOS 27.0). Das Audiomaterial stammt aus dem Testsplit von Google FLEURS in Revision 70bb2e84 mit etwa 150 Sätzen und 30 Minuten pro Sprache. Ein fester Hash der eigenen Element-IDs des Datensatzes legt die Reihenfolge fest; wir verwenden die kürzeste Folge vollständiger Elemente, die dreißig Minuten überschreitet. Keine Modellausgabe hatte Einfluss auf diese Auswahl. Jede Zelle wurde aus ihrem eigenen Beleg neu aufgebaut und erneut geprüft; alle 285 bestanden. Die Werte sind WER, wo Wörter durch Leerzeichen getrennt werden, und CER für Japanisch, Koreanisch, Chinesisch und Kantonesisch; beide werden nie zu einer Zahl zusammengeführt.
Die Whisper-Spalten lassen sich mit OpenAIs eigenen Zahlen prüfen. Für die zwölf Sprachen, für die OpenAI ein FLEURS-Ergebnis für Whisper Large V3 Turbo veröffentlicht, liegen unsere Werte im Durchschnitt 0,7 Punkte von den dortigen entfernt; zehn der zwölf liegen innerhalb des 95-%-Intervalls unseres Durchlaufs. Bei den elf Sprachen außerhalb der südasiatischen Zeilen liegen unsere Werte für Whisper Small im Durchschnitt 1,0 Punkt von der Tabelle nach Sprache in der Whisper-Publikation entfernt. Die Spalte von Apple Speech entstand aus denselben Clips, demselben Scorer und demselben Normalisierer.
FLEURS besteht aus sauber vorgelesener Sprache. Nichts hier sagt aus, wie sich diese Engines in einem lauten Raum oder über eine zweistündige Besprechung hinweg verhalten; wie weit sie dort auseinanderliegen, haben wir nicht gemessen. Alles lief auf einem einzigen Computer. Bei etwa 150 Sätzen pro Sprache gilt: Liegen zwei Engines weniger als etwa einen Punkt auseinander, ist das ein Gleichstand. Exakte Gleichstände markieren die Tabellen bereits so, etwa bei Italienisch, wo Qwen3-ASR 1.7B und Whisper Large V3 Turbo beide 2,58 erreichten.
Häufig gestellte Fragen
Apple Speech oder Whisper Small: Was ist genauer?
Apple Speech, in acht der zehn Sprachen, die beide sauber gemessen haben. Verloren hat es bei Englisch mit 8,80 (Apple Speech) gegenüber 7,04 (Whisper Small) und bei brasilianischem Portugiesisch mit 9,35 gegenüber 8,61. Am deutlichsten führt es bei Chinesisch mit 7,97 (Apple Speech) gegenüber 20,50 (Whisper Small), bei Französisch mit 7,61 gegenüber 13,24, bei Japanisch mit 6,36 gegenüber 11,37 und bei Kantonesisch mit 8,69 gegenüber 119,01. Whisper Small hat eine Downloadgröße von 600 MB und lief mit 7,9× Echtzeit, Apple Speech mit 30,8×.
Apple Speech oder Parakeet V3: Was ist genauer?
Parakeet V3, in jeder europäischen Sprache, die beide abdecken: 6,89 (Parakeet V3) gegenüber 8,80 (Apple Speech) bei Englisch, 5,83 gegenüber 7,61 bei Französisch, 4,86 gegenüber 5,41 bei Spanisch, 3,43 gegenüber 4,39 bei Italienisch und 6,49 gegenüber 9,35 bei brasilianischem Portugiesisch; bei Deutsch liegen beide mit 6,26 gleichauf. Parakeet V3 hat kein Modell für Japanisch, Koreanisch, Chinesisch oder Kantonesisch; dort ist Apple Speech das einzige der beiden, das verfügbar ist. Parakeet V3 hat eine Downloadgröße von 465 MB und lief mit 75,6× Echtzeit, Apple Speech mit 30,8×.
Apple Speech oder Whisper Large V3 Turbo: Was ist genauer?
Whisper Large V3 Turbo, in acht der zehn Sprachen, die beide sauber gemessen haben: Englisch 5,49 (Whisper Large V3 Turbo) gegenüber 8,80 (Apple Speech), Deutsch 4,05 gegenüber 6,26, Japanisch 5,30 gegenüber 6,36, Koreanisch 4,25 gegenüber 4,31, Französisch 5,97 gegenüber 7,61, Spanisch 3,62 gegenüber 5,41, Italienisch 2,58 gegenüber 4,39, brasilianisches Portugiesisch 5,44 gegenüber 9,35. Bei Chinesisch liegen beide mit 7,97 gleichauf; Apple Speech führt nur bei Kantonesisch mit 8,69 (Apple Speech) gegenüber 36,75 (Whisper Large V3 Turbo). Turbo deckt außerdem Niederländisch, Russisch und Polnisch ab, mit 5,69, 5,13 und 5,45. Es belegt rund 1,6 GB und ist mit 3,0× Echtzeit die langsamste Engine hier.
Welche Sprachen unterstützt Apple Speech?
In unserem Durchlauf lieferte Apple Speech Ergebnisse für 21 von 83 Konfigurationen: Englisch, Deutsch, Französisch, Spanisch, Italienisch, Portugiesisch (Brasilien), Japanisch, Koreanisch, Chinesisch, Kantonesisch sowie elf südasiatische Sprachen — Hindi, Telugu, Urdu, Punjabi, Bengali, Nepali, Malayalam, Marathi, Kannada, Gujarati und Tamil —, bei denen es in englischen Buchstaben antwortete, statt in der jeweils eigenen Schrift. Kein Niederländisch, Polnisch oder Russisch; macOS entscheidet die Liste pro Computer. Am nächsten an den Zeilenbesten liegt es bei Koreanisch, Japanisch und Chinesisch mit 0,77, 1,06 und 1,48 Punkten Rückstand, am weitesten zurück bei Englisch mit 8,80 (Apple Speech) gegenüber 4,49 (Qwen3-ASR 1.7B); und in allen zehn Sprachen, die beide gemessen haben, liegt es vor der alten Diktierfunktion. Whisper in Whisper Notes deckt über jeden Kanal die gesamte Sprachliste der App ab.
Was ist SpeechAnalyzer, und ist es dasselbe wie Apple Dictation?
SpeechAnalyzer ist die API, die Apple auf der WWDC 2025 vorgestellt und mit macOS 26 sowie iOS 26 veröffentlicht hat. SpeechTranscriber ist die darin enthaltene Transkriptions-Engine, in diesem Beitrag Apple Speech; die Diktierfunktion ist die ältere Kompatibilitäts-Engine. Wir haben beide ausgeführt, und Apple Speech war in allen zehn Sprachen genauer, die beide sauber gemessen haben. Die Diktierfunktion erreicht mehr Sprachen, 33 Konfigurationen gegenüber 21, darunter Niederländisch, Polnisch und Russisch mit 17,34 %, 13,50 % und 13,13 % WER (Diktierfunktion) gegenüber 5,69 %, 5,45 % und 5,13 % (Whisper Large V3 Turbo).
Verlässt das Audio meinen Mac, wenn ich Apple Speech verwende?
Apple dokumentiert SpeechTranscriber als Spracherkennung auf dem Gerät: macOS lädt die Sprachressourcen einmal herunter, und die Erkennung läuft lokal. Wir haben Genauigkeit und Geschwindigkeit gemessen, nicht das Netzwerkverhalten, und beschreiben diesen Teil daher so wie Apple. Die Engines, die Whisper Notes selbst herunterlädt — Whisper, Parakeet V3, SenseVoice und Qwen3-ASR — laufen ohne Konto und ohne API key auf der GPU oder Neural Engine deines eigenen Mac; die Transkription funktioniert auf jedem Kanal auch bei ausgeschaltetem Netzwerk. Apple Speech steht in der Mac-App von unserer Website unter macOS 26 oder neuer zur Verfügung: eine Engine des Systems auf deinem Mac, das Sprachpaket lädt macOS herunter.
Warum stimmen diese Zahlen nicht mit der Genauigkeit meiner Aufnahmen überein?
Weil FLEURS aus kurzen, sauberen, vorgelesenen Sprachaufnahmen besteht und deine Aufnahmen anders sind. Unser Durchlauf ist eine Kalibrierung auf einem öffentlichen Datensatz: etwa 150 Sätze und 30 Minuten pro Sprache, ein M5 MacBook Air, dieselben Clips für jede Engine. Er zeigt, ob eine Engine für deine Sprache infrage kommt, nicht, was du in einer Besprechung, bei verrauschtem Audio oder mit einer zweistündigen Datei erhältst.
Probier es aus
Die fünf herunterladbaren Modelle hier — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small und Qwen3-ASR 1.7B — sind alle in der Mac-App von Whisper Notes von unserer Website enthalten, unter Einstellungen, dann Transkriptionsmodell. Unter macOS 26 oder neuer steht Apple Speech in derselben Liste; wenn du die App schon hast, aktualisiere sie auf die neueste Version.
Wenn unsere Zahlen nicht zu deiner Erfahrung mit einer Sprache passen, schreib an mac@whispernotes.app. Vollständige Versionshinweise: whispernotes.app/changelog.
Quellen: unser Durchlauf auf dem Google FLEURS Testsplit in Revision 70bb2e84, Apples SpeechAnalyzer-Dokumentation, sowie der Qwen3-ASR-Durchlauf über dreißig Sprachen davor.
 Für macOS herunterladen