
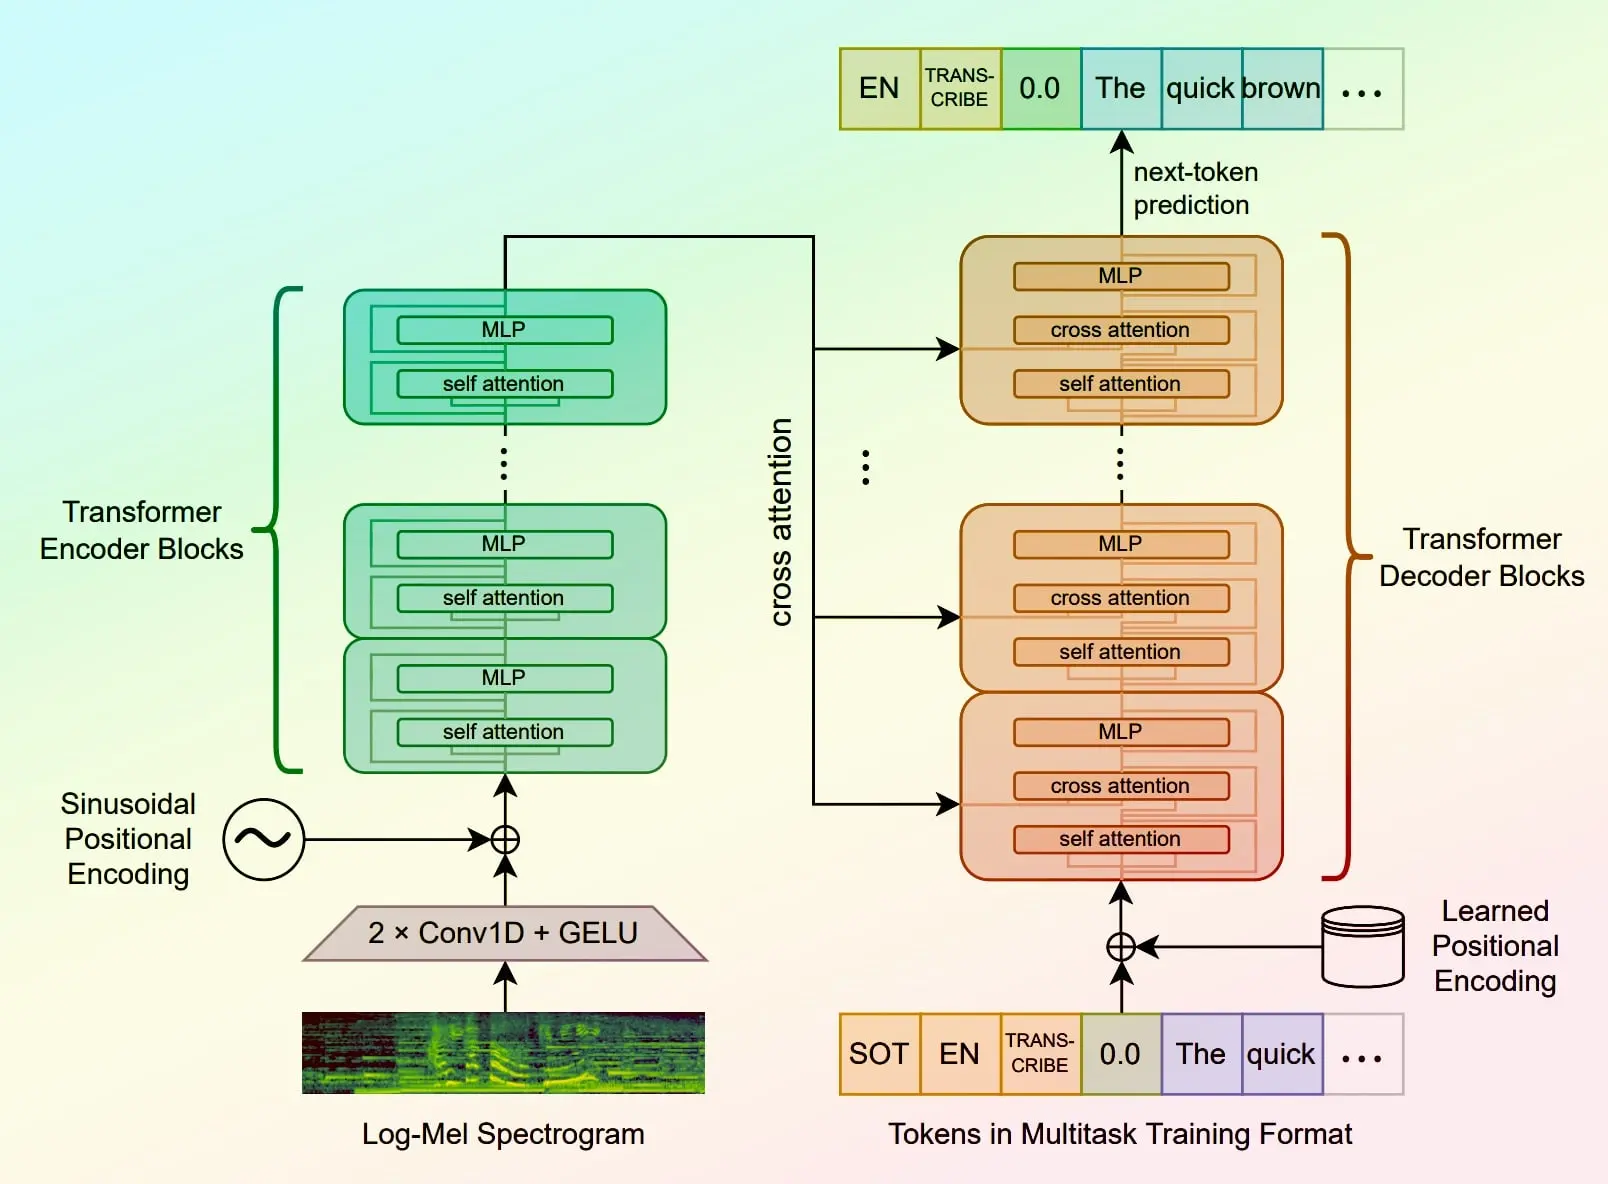
OpenAIs Whisper Large-v3 Turbo reduziert den Decoder von 32 auf 4 Schichten und senkt die Parameterzahl von 1,55 Milliarden auf 809 Millionen. Bei unseren Tests auf Apple Silicon transkribierte es dieselbe Aufnahme rund fünfmal schneller und blieb bei der Genauigkeit nahe am vollständigen Modell. Whisper Notes bietet Turbo auf dem Mac an und lässt es auf dem iPhone bewusst weg, weil dort kleinere Modelle besser passen.
V3 Turbo vs V3: Was sich geaendert hat
Turbo ist keine neue Architektur, sondern exakt dasselbe Whisper Large-v3 Modell, bei dem der Decoder von 32 auf 4 Schichten beschnitten und anschliessend feingetunt wurde, um die Genauigkeit wiederherzustellen. Der Encoder ist unveraendert.
| Large-v3 Turbo | Large-v3 | |
|---|---|---|
| Parameter | 809M | 1,550M |
| Decoder-Schichten | 4 | 32 |
| Sprachen | 100+ | 100+ |
| Uebersetzungsaufgabe | Nicht unterstuetzt | Unterstuetzt |
| Lizenz | MIT | Apache 2.0 |
Methode: Auf jedem genannten Gerät wurde dieselbe zehnminütige Audiodatei mit demselben Whisper-Notes-Build transkribiert. Gemessen wurde die Zeit vom Start bis zum fertigen Text; zwischen V3 und Turbo änderte sich nur das Modell.
Die Uebersetzungsaufgabe wurde explizit aus Turbos Trainingsdaten ausgeschlossen. Das vollstaendige Large-v3 Modell unterstuetzt sie, aber Whisper Notes liefert nur Turbo -- in der Mac-Version von unserer Website kann der KI-Assistent ein Transkript mit dem lokalen Gemma-Modell übersetzen.
Das Basismodell: Was ist Whisper Large-v3?
Whisper Large-v3 ist OpenAIs größtes offenes Spracherkennungsmodell und erschien im November 2023. Es besitzt 1,55 Milliarden Parameter, verarbeitet Spektrogramme mit 128 Mel-Bins und wurde mit fünf Millionen Stunden Audio trainiert, davon eine Million Stunden mit schwachen Labels und vier Millionen Stunden mit Pseudo-Labels. Das Modell unterstützt 100+ Sprachen. Im Hugging Face Open ASR Leaderboard liegt die durchschnittliche Wortfehlerrate bei etwa 7,4 %; an diesem Genauigkeitsniveau wird Turbo im restlichen Artikel gemessen. Alle Modelle nebeneinander, mit Fehlerraten in 42 Sprachen, findest du in unserer Übersicht der Whisper-Modelle.
Geschwindigkeits-Benchmark: Whisper Notes auf Apple Silicon
In Whisper Notes fuer Mac laeuft Turbo ueber CoreML auf der Neural Engine. Verarbeitung von 10 Minuten Audio:
| Geraet | Whisper V3 | V3 Turbo | Beschleunigung |
|---|---|---|---|
| iPhone 15 Pro | 425 s | 82 s | 5.2× |
| iPad Pro M2 | 380 s | 71 s | 5.4× |
| MacBook Pro M2 | 316 s | 63 s | 5.0× |
Die 5-fache Beschleunigung gilt speziell fuer Whisper Notes auf Apple Silicon, wo der kleinere Decoder von der Neural Engine-Optimierung profitiert. Auf GPU mit Frameworks wie faster-whisper verringert sich der Abstand auf ca. 2,7× (siehe Community-Benchmarks unten).
Genauigkeit: WER-Vergleich
Das Hugging Face Open ASR Leaderboard testet beide Modelle auf denselben englischen Datensaetzen. Turbos Wortfehlerrate liegt bei jedem Benchmark innerhalb eines halben Prozentpunkts von V3:
| Datensatz | Whisper Large-v3 Turbo WER | Whisper Large-v3 WER |
|---|---|---|
| LibriSpeech Clean | 2.10% | 2.01% |
| LibriSpeech Other | 4.24% | 3.91% |
| GigaSpeech | 10.14% | 10.02% |
| Earnings22 | 11.63% | 11.29% |
| AMI | 16.13% | 15.95% |
| Durchschnittliche WER | 7.83% | 7.44% |
V3 ist bei jedem Datensatz etwas genauer, aber der Unterschied ist gering -- durchschnittlich 0,39 Prozentpunkte. Bei den meisten realen Transkriptionen ist der Unterschied nicht spuerbar.
Bei der YouTube-commons Langform-Evaluation (einem der groessten Open-Source-ASR-Benchmarks) erreicht Turbo 13,40% WER gegenueber 13,20% bei V3 -- bei einem Echtzeit-Faktor von 129,5× gegenueber 55,3×. Das ist 2,3× schneller bei nahezu identischer Genauigkeit auf realen Audiodaten.
Wie genau ist Turbo auf Koreanisch, Russisch und anderen Sprachen?
Die bisherigen Tabellen messen Englisch. Laut OpenAI-Modellkarte kostet der verkürzte Decoder bei nicht englischen und besonders bei ressourcenärmeren Sprachen etwas mehr Genauigkeit. Bei Russisch und den meisten europäischen Sprachen bleibt Turbo nahe an Large-v3; in Whisper Notes deckt das integrierte Parakeet-Modell (Parakeet Ultra von Moondream, auf Basis von NVIDIA Parakeet V3 nachtrainiert) Russisch und 24 weitere europäische Sprachen ab; Parakeet V3 lief mit rund 60× Echtzeit auf Apple Silicon.
Für Chinesisch, Japanisch, Koreanisch und Kantonesisch ist SenseVoice deutlich schneller, mit 115- bis 131-facher Echtzeit, und am Mac macht Qwen3-ASR 1.7B (Beta) die wenigsten Fehler. Bei Japanisch und Koreanisch hält Turbo gut mit: In unserem FLEURS-Durchlauf machte es dort weniger Fehler als SenseVoice. Whisper Notes bietet SenseVoice auf iPhone und Mac an, auf dem Mac neben Turbo, sodass du das Modell nach Sprache wählen kannst.
Community-Benchmarks: GPU & CPU
Unabhaengige Benchmarks aus den faster-whisper und whisper.cpp Communities zeigen konsistente Ergebnisse ueber verschiedene Hardware. Transkription von 13 Minuten Audio mit faster-whisper auf GPU:
| Modell | Praezision | Zeit | GPU-Speicher | WER |
|---|---|---|---|---|
| Large-v3 Turbo | fp16 | 19.2 s | 2,537 MB | 1.92% |
| Large-v3 | fp16 | 52.0 s | 4,521 MB | 2.88% |
| Large-v3 Turbo | int8 | 19.6 s | 1,545 MB | 1.92% |
| Distil-Large-v3 | fp16 | 26.1 s | 2,409 MB | 2.39% |
Quelle: faster-whisper Benchmark auf NVIDIA GPU, LibriSpeech clean Validierungssplit. Turbo int8 benoetigt nur 1,5 GB VRAM -- laeuft auch auf einer 2-GB-GPU.
Batch-Inferenz auf einem RTX 3060 Laptop (6 GB VRAM, int8 Praezision) verstaerkt den Vorteil weiter:
| Modell | Sequentiell | Batch (10) | Batch-WER |
|---|---|---|---|
| Large-v3 Turbo | 46.1 s | 18.7 s | 7.7% |
| Large-v3 | 230.8 s | 43.0 s | 7.9% |
| Large-v2 | 178.3 s | 43.2 s | 8.8% |
| Medium | 113.3 s | 26.3 s | 8.9% |
Quelle: NilaierMusic Benchmark, Intel i7-12650H + RTX 3060 Laptop 6 GB, franzoesisches Audio, int8 Praezision.
Mit Batch-Verarbeitung erzielt Turbo die beste WER aller getesteten Modelle (7,7%) und ist gleichzeitig das schnellste. Der klare Sweet Spot fuer den Produktionseinsatz.
Turbo, Medium und alle Whisper-Modellgrößen
Vor Turbo war Medium der übliche Kompromiss aus brauchbarer Genauigkeit und vertretbarer Geschwindigkeit. Turbo verändert diese Abwägung: Mit 809 Millionen Parametern ist es nur wenig größer als Medium mit 769 Millionen, erreicht aber nahezu die Genauigkeit der Large-Klasse und läuft deutlich schneller.
| Modell | Parameter | Größe auf dem Datenträger | Relative Geschwindigkeit | Genauigkeitsklasse |
|---|---|---|---|---|
| tiny | 39M | ca. 75 MB | ca. 10× | Niedrigste |
| base | 74M | ca. 142 MB | ca. 7× | Niedrig |
| small | 244M | ca. 466 MB | ca. 4× | Mittel |
| medium | 769M | ca. 1,5 GB | ca. 2× | Hoch |
| large-v3 | 1.550M | ca. 2,9 GB | 1× (Referenz) | Höchste |
| large-v3-turbo | 809M | ca. 1,6 GB (Modelldatei; in Whisper Notes etwa 2 GB Download) | ca. 5× auf Apple Silicon | Nahe an der höchsten |
Turbo wurde am 30. September 2024 veröffentlicht und besitzt 809 Millionen Parameter. Wer Medium bisher wegen Speicherbedarf oder Geschwindigkeit gewählt hat, erhält mit Turbo bei ähnlicher Größe sowohl höhere Genauigkeit als auch mehr Tempo.
Bekannte Einschraenkungen (und wie Whisper Notes damit umgeht)
Keine integrierte Uebersetzung
Turbo wurde ohne Uebersetzungsdaten trainiert. Es transkribiert nur in der Ausgangssprache -- im Gegensatz zu Large-v3, das Audio-zu-Englisch-Uebersetzung unterstuetzt.
Whisper Notes -- in der Mac-Version von unserer Website schaltest du die KI-Funktionen ein, und das lokale Gemma-Modell übersetzt ein Transkript in die gewünschte Sprache, egal welches Spracherkennungsmodell es erzeugt hat.
Mehr Halluzinationen bei verrauschtem Audio
Community-Berichte zeigen, dass Turbo bei sehr kurzen Clips oder verrauschten Aufnahmen mehr halluziniert als V3. Angesichts des reduzierten Decoders (4 Schichten vs 32) zu erwarten.
Whisper Notes -- lässt vor der Transkription Silero VAD laufen: Es findet die gesprochenen Stellen und überspringt die Stille, damit Whisper nur echte Sprache verarbeitet.
Welches Modell solltest du verwenden?
| Englisch / Europaeisch | Parakeet V3 -- rund 60× Echtzeit auf Apple Silicon, 6.32% WER auf Englisch gegenüber 7.83% bei Turbo |
| Chinesisch / Japanisch / Koreanisch | SenseVoice für Tempo, 115- bis 131-fache Echtzeit; Qwen3-ASR 1.7B (Beta) am Mac für die wenigsten Fehler |
| Andere Sprachen | Whisper Large V3 Turbo -- 100+ Sprachen, hohe Genauigkeit, langsamer |
Whisper Large-v3 Turbo: Häufig gestellte Fragen
Was ist der Unterschied zwischen Whisper Large-v3 und Large-v3 Turbo?
Large-v3 Turbo behält den Encoder von Large-v3, reduziert den Decoder aber von 32 auf 4 Schichten. Dadurch läuft es deutlich schneller und bleibt bei Transkriptionen nahe an der Genauigkeit von Large-v3. Der Kompromiss: Turbo unterstützt Whispers eingebaute Übersetzungsaufgabe nicht.
Unterstützt faster-whisper Large-v3 Turbo?
Ja. faster-whisper unterstützt Large-v3 Turbo über CTranslate2-Konvertierungen. Community-Benchmarks zeigen, dass Turbo auch bei knappem Grafikspeicher gut passt; im oben genannten Test benötigte Turbo mit int8 etwa 1,5 GB VRAM.
Unterstützt whisper.cpp Large-v3 Turbo?
Ja. whisper.cpp kann konvertierte GGML- oder GGUF-Versionen von Whisper Large-v3 Turbo ausführen. Für eine selbst gebaute lokale Transkriptions-Pipeline passt Turbo meist leichter auf Consumer-Hardware als das vollständige Large-v3.
Wo kann ich openai/whisper-large-v3-turbo herunterladen?
Die offiziellen Modellgewichte stellt OpenAI auf Hugging Face bereit. Nutzer von Whisper Notes müssen sie nicht manuell laden; die App richtet das lokale Modell über ihre Oberfläche ein.
Einen direkten Vergleich aller lokalen Optionen findest du auf unserer Vergleichsseite für Whisper-Modelle: Alle Spracherkennungsmodelle in Whisper Notes, von Parakeet und Whisper bis Qwen3-ASR und SenseVoice, stehen dort Sprache für Sprache nebeneinander. Wenn du Whisper selbst erst kennenlernst, beginne mit dem Leitfaden zur Whisper-Transkription, der Modellfamilie, Ausführungswege und Kosten erklärt.
 Download fuer iOS