
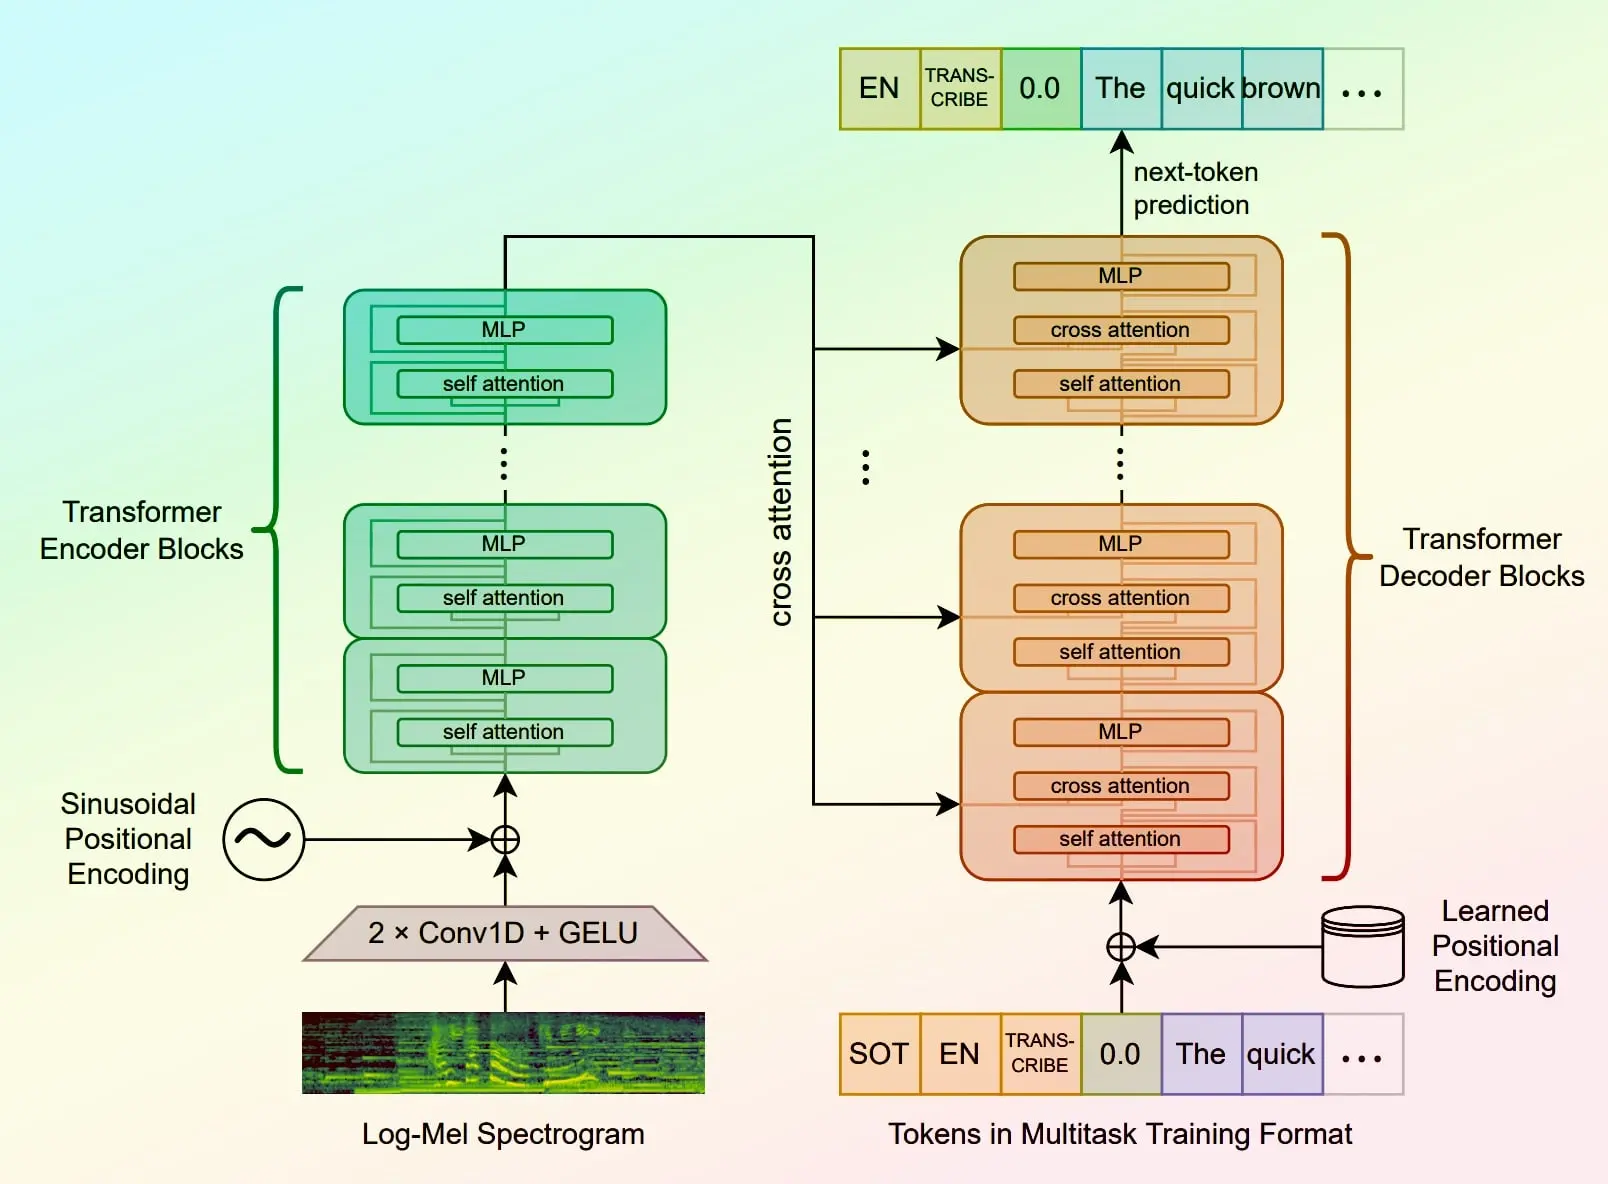
Whisper Large-v3 Turbo dari OpenAI memangkas decoder dari 32 lapisan menjadi 4, menurunkan parameter dari 1,55B menjadi 809M. Dalam pengujian kami di Apple Silicon, model ini mentranskripsi audio yang sama sekitar 5× lebih cepat dengan akurasi hampir identik. Whisper Notes menghadirkannya di Mac dan sengaja tidak memasangnya di iPhone, karena di sana model yang lebih kecil lebih pas.
V3 Turbo vs V3: apa yang berubah
Turbo bukan arsitektur baru. Ini adalah model Whisper Large-v3 yang sama persis dengan decoder yang dipangkas dari 32 lapisan menjadi 4, lalu di-fine-tune untuk memulihkan akurasi. Encoder tidak diubah.
| Large-v3 Turbo | Large-v3 | |
|---|---|---|
| Parameter | 809M | 1,550M |
| Lapisan decoder | 4 | 32 |
| Bahasa | 100+ | 100+ |
| Tugas terjemahan | Tidak didukung | Didukung |
| Lisensi | MIT | Apache 2.0 |
Metode: file audio 10 menit yang sama ditranskripsi dengan build Whisper Notes yang sama di setiap perangkat yang disebutkan. Waktu adalah detik wall-clock dari awal transkripsi hingga teks akhir; hanya model yang berubah antara V3 dan Turbo.
Tugas terjemahan secara eksplisit dikecualikan dari data pelatihan Turbo. Model Large-v3 lengkap mendukungnya, tetapi Whisper Notes hanya menggunakan Turbo — di aplikasi Mac dari situs web kami, asisten AI dapat menerjemahkan transkrip dengan model Gemma lokal.
Model dasar: apa itu Whisper Large-v3?
Whisper Large-v3 adalah model pengenalan suara open-source andalan OpenAI, dirilis pada November 2023. Model ini memiliki 1,55B parameter, menggunakan input spektrogram 128 mel-bin, dilatih dengan 5 juta jam audio (1 juta jam weakly labeled + 4 juta jam pseudo-labeled), dan mendukung lebih dari 100 bahasa. Di Hugging Face Open ASR Leaderboard, rata-rata word error rate-nya sekitar ~7,4% — batas akurasi yang menjadi pembanding Turbo di sepanjang artikel ini. Untuk melihat bagaimana Whisper Large V3 Turbo dibandingkan dengan model lain di Whisper Notes, bahasa demi bahasa, lihat halaman perbandingan model Whisper kami.
Benchmark kecepatan: Whisper Notes di Apple Silicon
Di Whisper Notes untuk Mac, Turbo berjalan di Mac itu sendiri, terutama di GPU. Memproses 10 menit audio:
| Perangkat | Whisper V3 | V3 Turbo | Percepatan |
|---|---|---|---|
| iPhone 15 Pro | 425 s | 82 s | 5.2× |
| iPad Pro M2 | 380 s | 71 s | 5.4× |
| MacBook Pro M2 | 316 s | 63 s | 5.0× |
Percepatan 5× ini spesifik untuk Whisper Notes di Apple Silicon. Di GPU NVIDIA dengan framework seperti faster-whisper, selisihnya menyempit menjadi ~2,7× (lihat benchmark komunitas di bawah).
Satu catatan tentang baris iPhone dan iPad: angka itu hasil uji model di perangkat keras tersebut, bukan daftar model yang tersedia di aplikasi iPhone yang dirilis. Whisper Notes untuk iPhone dan iPad tidak menyediakan Large V3 Turbo.
Akurasi: perbandingan WER
Hugging Face Open ASR Leaderboard menguji kedua model pada dataset bahasa Inggris yang sama. Word error rate Turbo berada dalam setengah poin dari V3 di setiap benchmark:
| Dataset | Whisper Large-v3 Turbo WER | Whisper Large-v3 WER |
|---|---|---|
| LibriSpeech Clean | 2.10% | 2.01% |
| LibriSpeech Other | 4.24% | 3.91% |
| GigaSpeech | 10.14% | 10.02% |
| Earnings22 | 11.63% | 11.29% |
| AMI | 16.13% | 15.95% |
| Rata-rata WER | 7.83% | 7.44% |
V3 sedikit lebih akurat di setiap dataset, tetapi selisihnya kecil — rata-rata 0,39 poin persentase. Untuk sebagian besar transkripsi dunia nyata, Anda tidak akan merasakan perbedaannya.
Pada evaluasi YouTube-commons format panjang (salah satu benchmark ASR open-source terbesar), Turbo mencatat 13.40% WER vs 13.20% milik V3 — sambil berjalan pada faktor waktu nyata 129.5× vs 55.3×. Itu 2,3× lebih cepat dengan akurasi hampir identik pada audio dunia nyata.
Seberapa akurat Turbo dalam bahasa Korea, Rusia, dan bahasa lainnya?
Benchmark di atas menggunakan bahasa Inggris. Menurut model card OpenAI, decoder 4 lapisan Turbo yang dipangkas sedikit lebih mengorbankan akurasi di bahasa non-Inggris dibandingkan bahasa Inggris, dengan penurunan terbesar pada bahasa bersumber daya rendah. Untuk bahasa Rusia dan sebagian besar bahasa Eropa, Turbo tetap dekat dengan Large-v3 penuh — dan jika Anda menggunakan Whisper Notes, model Parakeet yang terpasang di aplikasi (Parakeet Ultra dari Moondream, hasil pelatihan lanjutan dari NVIDIA Parakeet V3) mencakup bahasa Rusia dan 24 bahasa Eropa lainnya; Parakeet V3 berjalan dengan kecepatan sekitar 60× waktu nyata di Apple Silicon.
Untuk bahasa Mandarin, Jepang, Korea, dan Kanton, SenseVoice jauh lebih cepat, yaitu 115–131× waktu nyata. Model yang kesalahannya paling sedikit bergantung pada bahasanya: pada uji FLEURS kami, untuk bahasa Jepang itu Turbo, di depan Qwen3-ASR 1.7B (Beta) dan SenseVoice. Untuk bahasa Mandarin, Korea, dan Kanton itu Qwen3-ASR 1.7B (Beta) di Mac, dan di bahasa Korea Turbo di urutan kedua, tetap di depan SenseVoice. Whisper Notes menghadirkan SenseVoice di iPhone dan Mac, dan di Mac berdampingan dengan Turbo, sehingga Anda dapat memilih model yang tepat untuk setiap bahasa alih-alih memaksakan semuanya melalui satu model.
Benchmark komunitas: GPU & CPU
Benchmark independen dari komunitas faster-whisper dan whisper.cpp menunjukkan hasil konsisten di berbagai perangkat keras. Transkripsi 13 menit audio dengan faster-whisper di GPU:
| Model | Presisi | Waktu | Memori GPU | WER |
|---|---|---|---|---|
| Large-v3 Turbo | fp16 | 19.2 s | 2,537 MB | 1.92% |
| Large-v3 | fp16 | 52.0 s | 4,521 MB | 2.88% |
| Large-v3 Turbo | int8 | 19.6 s | 1,545 MB | 1.92% |
| Distil-Large-v3 | fp16 | 26.1 s | 2,409 MB | 2.39% |
Sumber: benchmark faster-whisper di NVIDIA GPU, split validasi LibriSpeech clean. Turbo int8 hanya menggunakan 1,5 GB VRAM — cukup untuk GPU 2 GB.
Inferensi batch pada RTX 3060 Laptop (6 GB VRAM, presisi int8) menunjukkan keunggulan lebih jauh:
| Model | Sekuensial | Batch (10) | WER Batch |
|---|---|---|---|
| Large-v3 Turbo | 46.1 s | 18.7 s | 7.7% |
| Large-v3 | 230.8 s | 43.0 s | 7.9% |
| Large-v2 | 178.3 s | 43.2 s | 8.8% |
| Medium | 113.3 s | 26.3 s | 8.9% |
Sumber: benchmark NilaierMusic, Intel i7-12650H + RTX 3060 Laptop 6 GB, audio bahasa Prancis, presisi int8.
Dengan pemrosesan batch, Turbo mencapai WER terbaik dari semua model yang diuji (7,7%) sekaligus menjadi yang tercepat. Ini adalah titik optimal yang jelas untuk penggunaan produksi.
Turbo vs Medium vs semua ukuran model Whisper
Sebelum Turbo, Medium adalah kompromi yang lazim: akurasi yang dapat diterima dengan kecepatan yang masih bisa ditoleransi. Turbo membuat kompromi itu usang — dengan 809M parameter, ukurannya nyaris tidak lebih besar dari Medium (769M), namun memberikan akurasi kelas large dengan kecepatan beberapa kali lipat. Berikut seluruh keluarga model berdampingan:
| Model | Parameter | Ukuran Disk | Kecepatan Relatif | Tingkat Akurasi |
|---|---|---|---|---|
| tiny | 39M | ~75 MB | ~10× | Terendah |
| base | 74M | ~142 MB | ~7× | Rendah |
| small | 244M | ~466 MB | ~4× | Sedang |
| medium | 769M | ~1,5 GB | ~2× | Tinggi |
| large-v3 | 1,550M | ~2,9 GB | 1× (garis dasar) | Tertinggi |
| large-v3-turbo | 809M | ~1,6 GB (file model; unduhan di Whisper Notes sekitar 2 GB) | ~5× di Apple Silicon | Hampir tertinggi |
Dirilis pada 30 September 2024, Turbo memiliki 809M parameter. Jika sebelumnya Anda memilih Medium untuk menghemat ruang disk atau mengejar kecepatan, Turbo kini mengunggulinya baik dalam akurasi maupun kecepatan dengan jejak penyimpanan yang kurang lebih sama.
Keterbatasan yang diketahui (dan cara Whisper Notes menanganinya)
Tidak ada terjemahan bawaan
Turbo dilatih tanpa data terjemahan. Ia hanya mentranskripsi dalam bahasa sumber — tidak seperti Large-v3, yang mendukung terjemahan audio ke bahasa Inggris.
Whisper Notes — di aplikasi Mac dari situs web kami, aktifkan fitur AI dan model Gemma lokal akan menerjemahkan transkrip ke bahasa pilihan Anda, apa pun model ucapan yang menghasilkannya.
Lebih banyak halusinasi pada audio berisik
Laporan komunitas menunjukkan Turbo lebih banyak berhalusinasi pada klip sangat pendek atau rekaman berisik dibandingkan V3. Hal ini diperkirakan mengingat decoder yang lebih kecil (4 lapisan vs 32).
Whisper Notes — menjalankan Silero VAD sebelum Whisper mentranskripsi, mendeteksi segmen suara dan melewati bagian hening sehingga model hanya memproses suara nyata.
Model mana yang harus Anda gunakan?
| Inggris / Eropa | Parakeet — sekitar 74× waktu nyata di Mac, dan WER bahasa Inggris 6.32% berbanding 7.83% milik Turbo (diukur pada Parakeet V3) |
| Tionghoa / Jepang / Korea | SenseVoice — untuk kecepatan, 115–131× waktu nyata; untuk kesalahan paling sedikit di Mac, Whisper Large V3 Turbo untuk bahasa Jepang dan Qwen3-ASR 1.7B (Beta) untuk bahasa Mandarin dan Korea |
| Bahasa lainnya | Whisper Large V3 Turbo — 100+ bahasa, akurasi tinggi, lebih lambat |
FAQ Whisper Large-v3 Turbo
Apa perbedaan antara Whisper Large-v3 dan Large-v3 Turbo?
Large-v3 Turbo mempertahankan encoder Large-v3 tetapi mengurangi decoder dari 32 lapisan menjadi 4. Itulah sebabnya ia jauh lebih cepat sambil tetap mendekati akurasi transkripsi Large-v3. Kompromi yang harus diterima: Turbo tidak mendukung tugas terjemahan bawaan Whisper.
Apakah faster-whisper mendukung Large-v3 Turbo?
Ya. faster-whisper mendukung Large-v3 Turbo melalui konversi CTranslate2, dan benchmark komunitas menunjukkan Turbo adalah pilihan kuat saat VRAM terbatas. Dalam benchmark di atas, Turbo int8 menggunakan sekitar 1,5 GB VRAM.
Apakah whisper.cpp mendukung Large-v3 Turbo?
Ya. whisper.cpp dapat menjalankan versi GGML/GGUF hasil konversi dari Whisper Large-v3 Turbo. Jika Anda membangun pipeline transkripsi lokal sendiri, Turbo sering kali lebih mudah dimuat di perangkat keras konsumen daripada Large-v3 penuh.
Di mana saya bisa mengunduh openai/whisper-large-v3-turbo?
Bobot model resminya tersedia dari OpenAI di Hugging Face. Pengguna Whisper Notes tidak perlu mengunduhnya secara manual: aplikasi Mac menangani penyiapan model lokal melalui antarmuka aplikasi.
Sedang membandingkan semua opsi lokal? Setiap model pengenalan suara di Whisper Notes, dari Parakeet dan Whisper hingga Qwen3-ASR dan SenseVoice, dibandingkan bahasa demi bahasa di halaman perbandingan model Whisper kami. Baru mengenal Whisper? Mulailah dengan Panduan Transkripsi Whisper — apa itu modelnya, semua cara menjalankannya, dan berapa biayanya.
