macOS 26 と iOS 26 から、Apple は新世代のオンデバイス音声認識である SpeechAnalyzer と SpeechTranscriber を提供しています。以下ではまとめて Apple Speech と呼びます。旧来の音声入力エンジンより大幅に正確です。確かめたかったのは、実際の利用で、利用者がダウンロードするオンデバイスのオープンモデルである Whisper、Parakeet、Qwen3-ASR、SenseVoice と比べてどうなのかということです: Apple の内蔵音声認識は、文字起こしアプリをまったく使わずに済むほど十分になったのか?
これまで使っていた音声入力よりどれだけ良くなったか
これまで Mac の音声認識を担っていたのは SFSpeechRecognizer 時代のエンジンで、システム音声入力が今も使っているものです(DictationTranscriber)。macOS 26 と iOS 26 で加わったのが SpeechAnalyzer API と、その SpeechTranscriber モジュールです。同じ Mac で、両方を FLEURS のテスト分割、一言語あたり約 150 文、約 30 分で測定しました。
| 言語 | Apple Dictation | Apple Speech |
|---|---|---|
| 韓国語 | 7.11 | 4.31 |
| イタリア語 | 6.93 | 4.39 |
| スペイン語(ラテンアメリカ) | 8.43 | 5.41 |
| ドイツ語 | 12.69 | 6.26 |
| 日本語 | 9.37 | 6.36 |
| フランス語 | 17.10 | 7.61 |
| 中国語 | 10.28 | 7.97 |
| 広東語 | 10.18 | 8.69 |
| 英語 | 13.83 | 8.80 |
| ポルトガル語(ブラジル) | 10.85 | 9.35 |
Apple の二つのエンジンがともに正しく測定できた全言語を、Apple Speech の誤り率順に並べました。緑は行内で良い方の値です。同じ測定、同じクリップ、同じ Mac を使用しています。日本語・韓国語・中国語・広東語は文字誤り率、それ以外は単語誤り率です。
両方のエンジンを正しく測定できた十言語すべてで、Apple Speech の方が正確でした。フランス語とドイツ語では誤りが半分以上、中央値の言語ではおよそ三分の一、ブラジルポルトガル語と広東語ではおよそ七件に一件減りました。
音声入力の方が今も多くの言語に対応します。今回 Apple Speech が結果を返したのは 83 の言語構成のうち 21、音声入力は 33 で、新しいエンジンにないオランダ語・ポーランド語・ロシア語も 17.34、13.50、13.13 で含まれます。引用できる固定リストもありません。言語アセットは macOS が管理するため、アプリは実行時にその Mac で利用できるものを照会します。
ではダウンロード型モデルを省けるか
六つのエンジン、同じクリップ、一台の Mac です。以下の十言語は利用者の多い言語のうちの十言語で、結果とは関係のない固定順に並べています。
| 言語 | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| 英語 | 8.80 | 4.49 | 5.49 | 7.04 | 6.89 | 8.46 |
| ドイツ語 | 6.26 | 2.85 | 4.05 | 8.67 | 6.26 | — |
| オランダ語 | — | 7.36 | 5.69 | 16.75 | 8.58 | — |
| ロシア語 | — | 5.65 | 5.13 | 11.37 | 7.12 | — |
| ポーランド語 | — | 12.59 | 5.45 | 15.81 | 8.30 | — |
| 日本語 | 6.36 | 5.74 | 5.30 | 11.37 | — | 6.78 |
| 韓国語 | 4.31 | 3.54 | 4.25 | 7.30 | — | 7.85 |
| フランス語 | 7.61 | 4.57 | 5.97 | 13.24 | 5.83 | — |
| 中国語 | 7.97 | 6.49 | 7.97 | 20.50 | — | 7.69 |
| スペイン語(ラテンアメリカ) | 5.41 | 3.38 | 3.62 | 6.22 | 4.86 | — |
利用者の多い言語のうち十言語を、一列につき一エンジンで比較しました。各セルはそのエンジンの誤り率で、低いほど優秀です。緑は行内の最低値、白は二番目に低い値を示します。日本語・韓国語・中国語は文字誤り率(CER)、それ以外は単語誤り率(WER)で、一つの数値には統合していません。Whisper Notes チームが自ら回した FLEURS、M5 MacBook Air 一台、朗読音声です。
表内の略称:Qwen3-ASR = Qwen3-ASR 1.7B、Whisper Large = Whisper Large V3 Turbo、Parakeet = Parakeet V3、SenseVoice = SenseVoice Small。ダッシュは、そのエンジンに該当言語のモデルがないことを示します。
十言語のうち、誤り率が最も低かったのは Qwen3-ASR 1.7B が六言語、Whisper Large V3 Turbo が残り四言語で、Apple Speech が首位の言語はありませんでした。行内トップに最も近いのは韓国語の 0.77 ポイント差で、次が日本語の 1.06 ポイント、中国語の 1.48 ポイントです。中国語では Whisper Large V3 Turbo と 7.97 で並びます。差が最大なのは英語の 8.80(Apple Speech)対 4.49(Qwen3-ASR 1.7B)で、オランダ語・ポーランド語・ロシア語には Apple Speech の結果がありません。
Whisper Small と比べると、両方を正しく測定できた十言語のうち八言語で Apple Speech の方が正確でした。負けたのは英語の 8.80(Apple Speech)対 7.04(Whisper Small)と、ブラジルポルトガル語の 9.35 対 8.61 です。
七月に公開されたベンチマークは、英語で Apple Speech と Whisper Small を測り、Apple を上位としました。どの Whisper を比べるかだけでなく、クリップも重要です。その測定は LibriSpeech で、オーディオブックのナレーターが朗読した音声でした。私たちは FLEURS で、多くの異なる話者が Wikipedia の文を読んだ音声です。今回の測定から英語の差は分かりますが、その原因までは分かりません。
Whisper Large V3 Turbo と比べると順序は逆です。Apple Speech はその十言語のうち八言語で及ばず、中国語は 7.97 で並び、上回るのは広東語の 8.69(Apple Speech)対 36.75(Whisper Large V3 Turbo)だけです。下の広東語の行も参照してください。OpenAI の Turbo リリースノートは、モデルの劣化が特に大きい言語に広東語を挙げています。そのため 36.75 は今回だけの現象ではなく、Whisper で既知の弱点です。
韓国語では、Apple Speech はおよそ 23 文字に一つを誤ります。今回最も正確だった Qwen3-ASR 1.7B はおよそ 28 文字に一つで、4.31(Apple Speech)対 3.54(Qwen3-ASR 1.7B)です。
Parakeet V3 のダウンロード容量は 465 MB で、両方が対応するすべてのヨーロッパ言語でより正確です。英語は 8.80(Apple Speech)に対して 6.89(Parakeet V3)、フランス語は 7.61 対 5.83、スペイン語は 5.41 対 4.86、イタリア語は 4.39 対 3.43、ブラジルポルトガル語は 9.35 対 6.49 で、ドイツ語は 6.26 で並びます。日本語・韓国語・中国語・広東語のモデルはなく、これらで使えるのは二つのうち Apple Speech だけです。
Qwen3-ASR 1.7B が首位の六行には、英語、ドイツ語、フランス語、スペイン語などが含まれます。
SenseVoice Small はここで最速で、実時間の 162.3 倍です。中国語と英語では Apple Speech と同水準で、それぞれ 7.69(SenseVoice Small)対 7.97(Apple Speech)、8.46 対 8.80 です。韓国語では大きく及ばず、7.85(SenseVoice Small)対 4.31(Apple Speech)でした。
容量と速度
| エンジン | 速度 | ピークメモリ | ダウンロード |
|---|---|---|---|
| SenseVoice Small | 実時間の 162.3 倍 | 0.95 GiB | 827 MB |
| Parakeet V3 | 実時間の 75.6 倍 | 0.09 GiB | 465 MB |
| Apple Speech | 実時間の 30.8 倍 | 数値非掲載 | <5 MB |
| Qwen3-ASR 1.7B | 実時間の 11.1 倍 | 2.43 GiB | 約 2.5 GB |
| Whisper Small | 実時間の 7.9 倍 | 0.87 GiB | 600 MB |
| Whisper Large V3 Turbo | 実時間の 3.0 倍 | 1.87 GiB | 約 1.6 GB |
速度は、この記事で正しく測定できた十三言語のうち各エンジンが実際に走った言語における中央値です。項目を個別処理したスループットという診断値であり、製品の待ち時間ではありません。ピークメモリは今回のプロセスグループの最大値です。Apple Speech は呼び出し元アプリが所有しない macOS サービス内でデコードするため、ここに数値を置いても他の五エンジンと同じ意味にはなりません。
Apple Speech の速度は実時間の 30.8 倍で、Parakeet V3 の 75.6 倍、SenseVoice Small の 162.3 倍に及びません。言語パックは macOS が一度だけダウンロードして各アプリで共有するため、アプリ自身のプロセスには何も割り当てられません。デコードを行うサービスはメモリを使用しますが、正確に帰属させられないため、ゼロと書くのではなく数値を掲載していません。
Whisper Large V3 Turbo はここで最も遅く、実時間の 3.0 倍で、十行のうち四行で誤り率が最も低く、ディスク使用量は約 1.6 GB です。Qwen3-ASR 1.7B は残り六行で首位となり、ディスク使用量は約 2.5 GB、ピークは 2.43 GiB です。内蔵エンジンとの妥当な比較対象は 600 MB の Whisper Small です。
Apple Speech が適している言語はどれか
言語別の結果は次のとおりです。
- 英語:適していません。Apple Speech は 8.80。 Qwen3-ASR 1.7B (4.49)または Whisper Large V3 Turbo (5.49)の方が明らかに正確です。
- ドイツ語:適していません。Apple Speech は 6.26。 Qwen3-ASR 1.7B (2.85)または Whisper Large V3 Turbo (4.05)の方が明らかに正確です。
- オランダ語・ロシア語・ポーランド語:Apple Speech にはこの三言語のモデルがありません。 Whisper Large V3 Turbo がそれぞれ 5.69、5.13、5.45 で最も正確でした。
- 日本語:利用できます。Apple Speech は 6.36 で、 Whisper Large V3 Turbo の 5.30 に及びません。
- 韓国語:利用できます。Apple Speech は 4.31 で、 Qwen3-ASR 1.7B の 3.54 に及びません。
- フランス語:適していません。Apple Speech は 7.61。 Qwen3-ASR 1.7B (4.57)または Parakeet V3 (5.83)の方が明らかに正確です。
- 中国語:利用できます。Apple Speech は 7.97 で Whisper Large V3 Turbo と並びます。最も正確だったのは Qwen3-ASR 1.7B の 6.49 です。
- スペイン語:適していません。Apple Speech は 5.41。 Qwen3-ASR 1.7B (3.38)または Whisper Large V3 Turbo (3.62)の方が明らかに正確です。
精度では、今もダウンロード型モデルが上です。主表の各行は Qwen3-ASR 1.7B または Whisper Large V3 Turbo が首位です。韓国語・日本語・中国語では Apple Speech が現実的な選択肢で、ヨーロッパ言語では Parakeet V3 が適しています。
Mac 版 Whisper Notes では、Parakeet V3 は今もデフォルトです。公式サイトからダウンロードする Mac 版では、macOS 26 以降の Mac で Apple Speech を任意のモデルとして選べます。ある言語が選べるのは、その Mac で使えると macOS が報告した場合だけです。
Apple Speech は、Apple の SpeechTranscriber をこの記事で短く呼ぶ名前です。macOS 26 以降なら、どの Mac アプリからも呼び出せるオンデバイス API です。これはダウンロードするモデルではなくシステム側のエンジンで、Mac 版 Whisper Notes は 公式サイトからダウンロードする版でこれを利用でき、言語パックは macOS が用意します。アプリ自身がダウンロードするモデルは今も、その版が Whisper、Parakeet V3、SenseVoice、Qwen3-ASR、iPhone 版と Mac App Store 版が Whisper、Parakeet V3、SenseVoice です。エンジン別の一覧は Whisper、Parakeet V3、SenseVoice の対応言語リスト に掲載しています。
十言語以外の結果
| 言語 | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| イタリア語 | 4.39 | 2.58 | 2.58 | 7.64 | 3.43 | — |
| 広東語 | 8.69 | 6.44 | 36.75 | 119.01 | — | 37.23 |
| ポルトガル語(ブラジル) | 9.35 | 5.17 | 5.44 | 8.61 | 6.49 | — |
| ヒンディー語 | 101.50 | 13.19 | 29.64 | 61.26 | — | — |
同じ測定からさらに四言語です。列・配色・略称は上と同じです。広東語は文字誤り率、それ以外は単語誤り率です。
Apple Speech のヒンディー語の結果は、以下の理由で行内順位から除外しています。挿入誤りも分子に数えるため、誤り率は 100% を超えることがあります。
イタリア語の 4.39(Apple Speech)は、Qwen3-ASR 1.7B と Whisper Large V3 Turbo が 2.58 で並ぶ後ろです。広東語は、Apple Speech が Whisper Large V3 Turbo を上回った唯一の言語で、8.69(Apple Speech)対 36.75(Whisper Large V3 Turbo)、首位は Qwen3-ASR 1.7B の 6.44 です。ブラジルポルトガル語の 9.35(Apple Speech)は、Whisper Small の 8.61 が上回る二行の一つです。
ヒンディー語は別種の結果です。Apple Speech はヒンディー語本来の表記で書かず、英字でつづったため、ほぼすべての単語が誤りとなり、誤り率は 100% を超えました。テルグ語、ウルドゥー語、パンジャブ語、ベンガル語、ネパール語、マラヤーラム語、マラーティー語、カンナダ語、グジャラート語、タミル語などの十言語も同じで、すべて 100% を超えたため、表から外しています。
SpeechAnalyzer の仕組み
SpeechAnalyzer は、Apple が iOS 10 から提供してきた音声認識 API を、watchOS を除くすべての Apple プラットフォームで置き換えます。アプリは SpeechAnalyzer を作成してモジュールを与え、自ら埋める非同期シーケンスとして音声を送ります。音声をテキストに変えるモジュールが SpeechTranscriber です。結果は通常別のタスク上で、二つ目のシーケンスとして返り、すべてのバッファと結果には音声自身のタイムラインに沿った時刻情報が付きます。
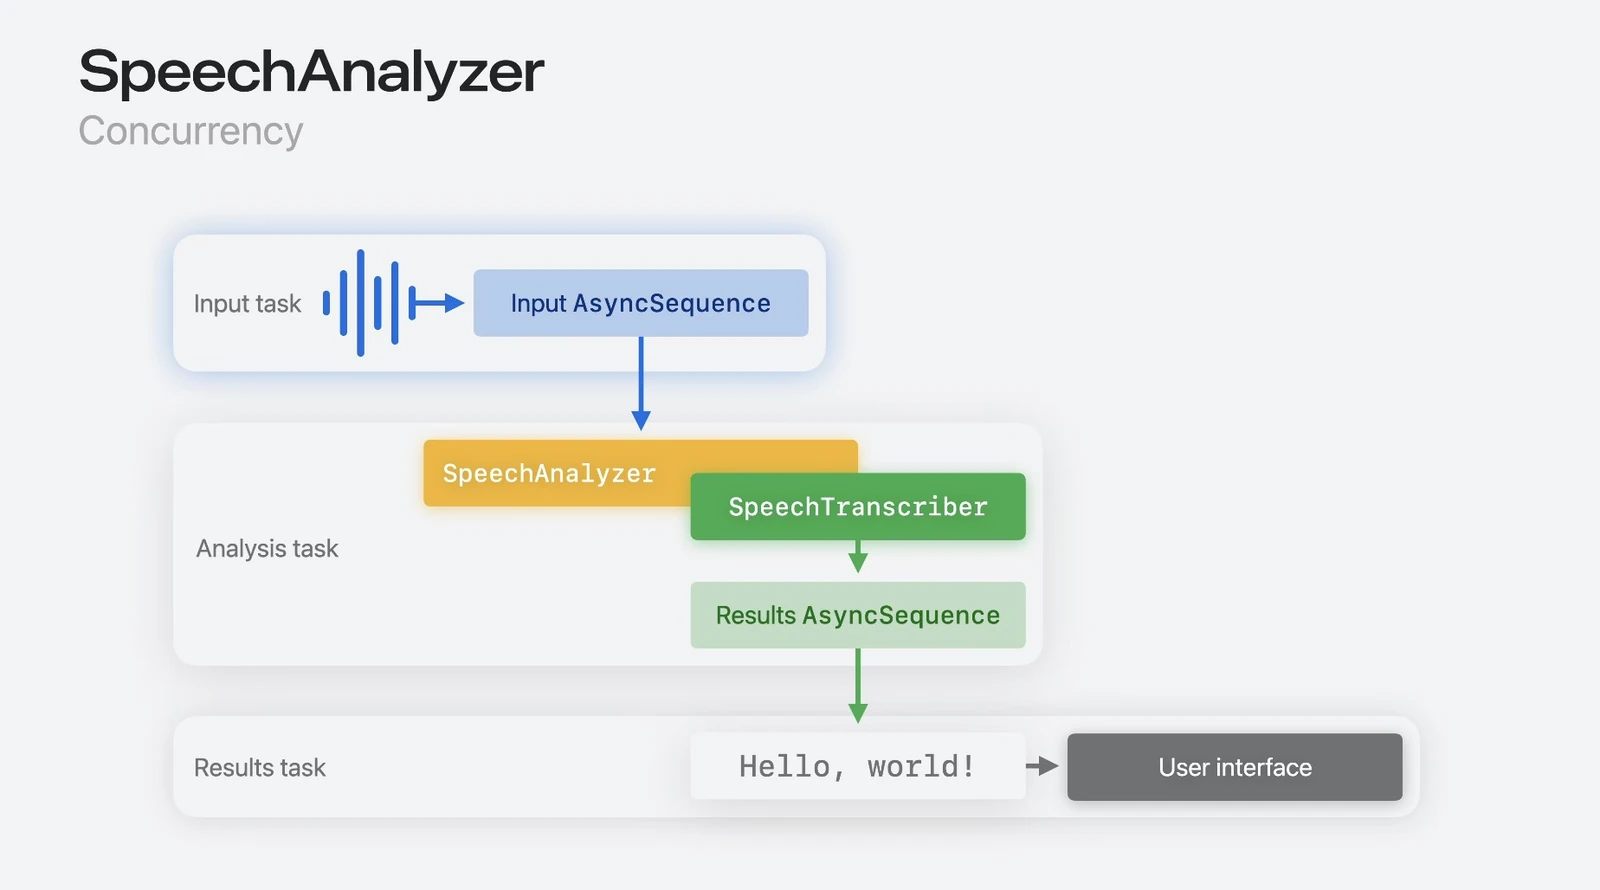
一つのセッション、三つのタスク。音声は AsyncSequence として入力され、SpeechAnalyzer と SpeechTranscriber が解析し、結果は別の AsyncSequence としてインターフェースに戻ります。出典:Apple、 WWDC25 セッション 277。
結果は二回届きます。Apple が volatile range と呼ぶ可変範囲の内側は、後からより良い結果に置き換わる可能性があり、外側は確定済みです。アプリはこの仕組みで、話している最中に暫定的な文字起こしを表示し、その後に修正できます。 Apple が SpeechTranscriber モデルについて掲げる設計目標は五つです。長い音声、会話音声、離れた話者、低遅延、そして端末上で動作することによるプライバシーです。メモ、ボイスメモ、ジャーナル、通話要約はこの技術を基盤にしています。
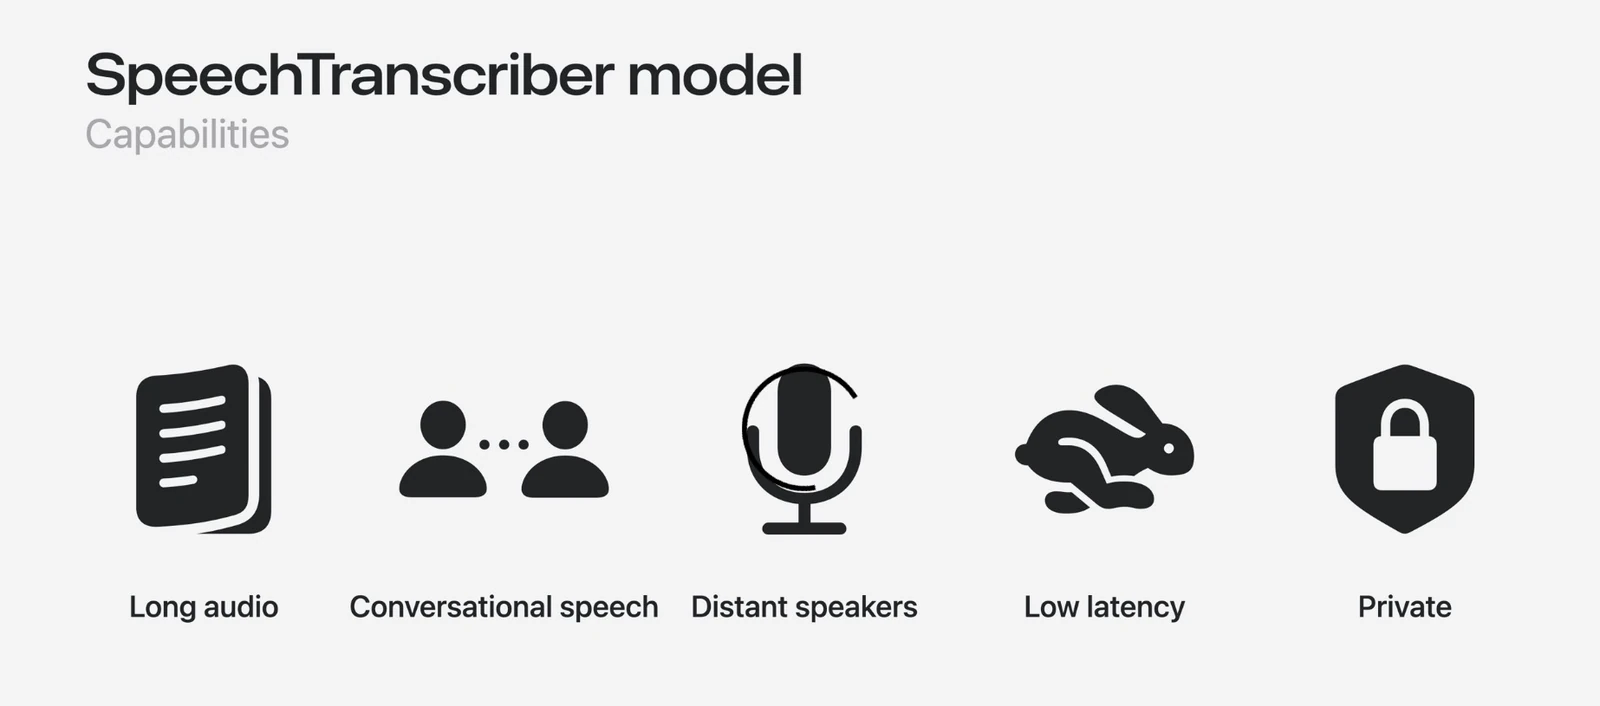
Apple が示した SpeechTranscriber モデルの五つの設計目標。出典:Apple、 WWDC25 セッション 277。
モデルはどのアプリにも含まれません。Apple のサーバーから AssetInventory 経由でダウンロードされ、システムが保存・更新し、アプリ間で共有します。アプリのダウンロード容量には加算されず、デコードは呼び出し元プロセスの外で行われます。SpeechTranscriber に特定の言語または端末向けのモデルがない場合は、DictationTranscriber がシステム音声入力と同じモデルで引き継ぎます。
測定方法と限界
この表の六つのエンジンのうち五つは、Whisper Notes がダウンロードするモデルです。すべてのエンジンに、同じクリップを同じ順序で一つずつ、M5 MacBook Air(32 GB、macOS 27.0)上で文字起こしさせました。音声は Google FLEURS のテスト分割リビジョン 70bb2e84 で、一言語あたり約 150 文、約 30 分です。データセット自身の項目 ID を固定ハッシュで並べ、三十分を超える最短の項目単位の連続区間を使いました。この選択にモデル出力は一切関与していません。各セルは固有の記録から再計算して再確認し、285 セルすべてが検査を通りました。単語を空白で区切る言語は単語誤り率、日本語・韓国語・中国語・広東語は文字誤り率で、一つの数値には統合していません。
Whisper の列は OpenAI 自身の数値と照合できます。OpenAI が公開している Whisper Large V3 Turbo の FLEURS 結果がある十二言語では、私たちの数値との差は平均 0.7 ポイントで、十二言語中十言語が今回の 95% 区間に入ります。南アジア諸語の行を除く十一言語では、Whisper Small の数値と Whisper 論文の言語別表との差は平均 1.0 ポイントです。Apple Speech の列も、同じクリップ、同じ採点器、同じ正規化処理から得ました。
FLEURS は雑音のない朗読音声です。ここからは、騒がしい部屋や二時間の会議で各エンジンがどう動き、どれほど差が付くかは分かりません。すべて一台の Mac で実行しました。また、一言語あたり約 150 文では、差が約一ポイント未満の二エンジンは同等です。表も完全な同値をそのように示しており、たとえばイタリア語では Qwen3-ASR 1.7B と Whisper Large V3 Turbo がともに 2.58 です。
よくある質問
Apple Speech と Whisper Small はどちらが正確ですか?
両方を正しく測定できた十言語のうち八言語で Apple Speech です。負けたのは英語の 8.80(Apple Speech)対 7.04(Whisper Small)と、ブラジルポルトガル語の 9.35 対 8.61 です。差が最も大きいのは中国語の 7.97(Apple Speech)対 20.50(Whisper Small)、フランス語の 7.61 対 13.24、日本語の 6.36 対 11.37、広東語の 8.69 対 119.01 です。Whisper Small はダウンロード容量が 600 MB で、速度は実時間の 7.9 倍、Apple Speech は 30.8 倍でした。
Apple Speech と Parakeet V3 はどちらが正確ですか?
両方が対応するすべてのヨーロッパ言語で Parakeet V3 です。英語は 6.89(Parakeet V3)対 8.80(Apple Speech)、フランス語は 5.83 対 7.61、スペイン語は 4.86 対 5.41、イタリア語は 3.43 対 4.39、ブラジルポルトガル語は 6.49 対 9.35 で、ドイツ語は 6.26 で並びます。Parakeet V3 には日本語・韓国語・中国語・広東語のモデルがなく、これらで使えるのは二つのうち Apple Speech だけです。Parakeet V3 のダウンロード容量は 465 MB、速度は実時間の 75.6 倍で、Apple Speech は 30.8 倍です。
Apple Speech と Whisper Large V3 Turbo はどちらが正確ですか?
両方を正しく測定できた十言語のうち八言語で Whisper Large V3 Turbo です。英語は 5.49(Whisper Large V3 Turbo)対 8.80(Apple Speech)、ドイツ語は 4.05 対 6.26、日本語は 5.30 対 6.36、韓国語は 4.25 対 4.31、フランス語は 5.97 対 7.61、スペイン語は 3.62 対 5.41、イタリア語は 2.58 対 4.39、ブラジルポルトガル語は 5.44 対 9.35 です。中国語は 7.97 で並び、Apple Speech が上回るのは広東語だけで、8.69(Apple Speech)対 36.75(Whisper Large V3 Turbo)です。Turbo はオランダ語・ロシア語・ポーランド語にも対応し、それぞれ 5.69、5.13、5.45 です。容量は約 1.6 GB で、ここで最も遅く、実時間の 3.0 倍です。
Apple Speech はどの言語に対応していますか?
今回の測定で Apple Speech が結果を返したのは 83 の言語構成のうち 21 です。英語、ドイツ語、フランス語、スペイン語、イタリア語、ポルトガル語(ブラジル)、日本語、韓国語、中国語、広東語、そして南アジアの十一言語、すなわちヒンディー語、テルグ語、ウルドゥー語、パンジャブ語、ベンガル語、ネパール語、マラヤーラム語、マラーティー語、カンナダ語、グジャラート語、タミル語です。この十一言語は、その言語本来の文字ではなく英字でつづられて返りました。オランダ語・ポーランド語・ロシア語はありません。一覧を決めるのは macOS で、端末ごとに変わります。行内トップに最も近いのは韓国語・日本語・中国語で、それぞれ 0.77、1.06、1.48 ポイント差、最も遠いのは英語の 8.80(Apple Speech)対 4.49(Qwen3-ASR 1.7B)です。両方を測定できた十言語すべてで、旧来の音声入力より正確でした。Whisper Notes の Whisper はどの配布チャネルでもアプリの言語一覧すべてをカバーします。
SpeechAnalyzer とは何ですか?Apple Dictation と同じものですか?
SpeechAnalyzer は Apple が WWDC 2025 で発表し、macOS 26 と iOS 26 で提供を始めた API です。SpeechTranscriber はその中の文字起こしエンジンで、この記事でいう Apple Speech です。Dictation は従来の互換性エンジンです。両方を測定し、両方を正しく測定できた十言語すべてで Apple Speech の方が正確でした。Dictation はより多くの言語をカバーし、33 構成対 21 構成で、オランダ語・ポーランド語・ロシア語も含みます。この三言語の単語誤り率は 17.34%、13.50%、13.13%(Dictation)に対し、5.69%、5.45%、5.13%(Whisper Large V3 Turbo)です。
Apple Speech を使うと音声は Mac の外に出ますか?
Apple は SpeechTranscriber をオンデバイス音声認識として説明しています。macOS が言語アセットを一度ダウンロードし、認識処理はローカルで動きます。私たちが測ったのは精度と速度で、ネットワーク挙動ではないため、この点は Apple の説明に沿っています。Whisper Notes が自らダウンロードする Whisper、Parakeet V3、SenseVoice、Qwen3-ASR は、自分の Mac の GPU または Neural Engine で動作し、アカウントも API key も不要です。どの配布チャネルでも、ネットワークを切った状態で文字起こしできます。Apple Speech は 公式サイトからダウンロードする Mac 版で、macOS 26 以降なら使えます。Mac 上で動くシステムのエンジンで、言語パックは macOS がダウンロードします。
自分の録音で得られる精度と、この数値が一致しないのはなぜですか?
FLEURS は短く、雑音のない朗読音声で、自分の録音とは違うからです。今回の測定は公開データセット上の較正で、一言語あたり約 150 文・約 30 分、M5 MacBook Air 一台、すべてのエンジンに同じクリップを使っています。あるエンジンがその言語で使えそうかは判断できますが、会議、雑音の多い音声、二時間のファイルで得られる結果を予測するものではありません。
試してみる
ここにあるダウンロード型の五つのモデル、Whisper Small、Whisper Large V3 Turbo、Parakeet V3、SenseVoice Small、Qwen3-ASR 1.7B はすべて 公式サイトからダウンロードする Mac 版 Whisper Notes にあり、設定 → 文字起こしモデルから選べます。macOS 26 以降なら、同じ一覧に Apple Speech も並びます。すでにアプリをお使いなら、最新版にアップデートしてください。
ある言語で私たちの数値と実際の体験が一致しない場合は、 mac@whispernotes.app までメールをお送りください。リリースノート全文: whispernotes.app/changelog。
出典: Google FLEURS テスト分割リビジョン 70bb2e84 での自社測定、Apple の SpeechAnalyzer ドキュメント、および先に実施した 三十言語の Qwen3-ASR 測定。
 macOS 版をダウンロード