Sejak macOS 26 dan iOS 26, Apple telah menyediakan generasi baharu pengecaman pertuturan pada peranti — SpeechAnalyzer dan SpeechTranscriber, yang diringkaskan sebagai Apple Speech di bawah. Sistem ini jauh lebih tepat daripada enjin imlak lama. Kami ingin mengetahui perbandingannya dalam penggunaan sebenar dengan model terbuka pada peranti yang dimuat turun oleh pengguna — Whisper, Parakeet, Qwen3-ASR dan SenseVoice: adakah pengecaman pertuturan terbina dalam Apple kini cukup baik sehingga anda boleh mengetepikan aplikasi transkripsi sepenuhnya?
Sejauh manakah sistem ini lebih baik daripada imlak yang sudah anda miliki?
Hingga kini, pengecaman pertuturan pada Mac menggunakan enjin dari era SFSpeechRecognizer, enjin yang masih digunakan oleh imlak sistem hari ini (DictationTranscriber). macOS 26 dan iOS 26 menambah API SpeechAnalyzer bersama modul SpeechTranscriber. Kami telah menjalankan kedua-duanya pada bahagian ujian FLEURS, kira-kira 150 ayat dan 30 minit bagi setiap bahasa, pada Mac yang sama.
| Bahasa | Apple Dictation | Apple Speech |
|---|---|---|
| Korea | 7.11 | 4.31 |
| Itali | 6.93 | 4.39 |
| Sepanyol (Amerika Latin) | 8.43 | 5.41 |
| Jerman | 12.69 | 6.26 |
| Jepun | 9.37 | 6.36 |
| Perancis | 17.10 | 7.61 |
| Mandarin | 10.28 | 7.97 |
| Kantonis | 10.18 | 8.69 |
| Inggeris | 13.83 | 8.80 |
| Portugis (Brazil) | 10.85 | 9.35 |
Semua bahasa yang telah diukur dengan baik oleh kedua-dua enjin Apple, disusun mengikut kadar ralat Apple Speech; hijau menandakan nilai yang lebih baik dalam baris. Ujian yang sama, klip yang sama, Mac yang sama. CER bagi bahasa Jepun, Korea, Mandarin dan Kantonis, WER bagi bahasa lain.
Apple Speech lebih tepat dalam kesemua sepuluh bahasa yang diukur dengan baik oleh kedua-dua enjin. Bahasa Perancis dan Jerman kehilangan lebih separuh ralatnya, bahasa median kira-kira satu pertiga, manakala Portugis Brazil dan Kantonis kira-kira satu daripada setiap tujuh ralat.
Imlak masih merangkumi lebih banyak bahasa. Dalam ujian ini, Apple Speech telah memberikan hasil bagi 21 daripada 83 konfigurasi bahasa, manakala imlak bagi 33, termasuk tiga bahasa yang tiada pada enjin baharu di sini: bahasa Belanda, Poland dan Rusia, pada 17.34, 13.50 dan 13.13. Tiada juga senarai tetap untuk dipetik. Aset bahasa dimiliki oleh macOS, jadi aplikasi bertanya semasa masa jalan tentang apa yang tersedia pada mesin tertentu.
Jadi, bolehkah anda mengetepikan model yang dimuat turun?
Enam enjin, klip yang sama, satu Mac. Sepuluh bahasa di bawah adalah antara bahasa yang paling banyak digunakan, dalam susunan tetap yang tidak berkaitan dengan skor.
| Bahasa | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Inggeris | 8.80 | 4.49 | 5.49 | 7.04 | 6.89 | 8.46 |
| Jerman | 6.26 | 2.85 | 4.05 | 8.67 | 6.26 | — |
| Belanda | — | 7.36 | 5.69 | 16.75 | 8.58 | — |
| Rusia | — | 5.65 | 5.13 | 11.37 | 7.12 | — |
| Poland | — | 12.59 | 5.45 | 15.81 | 8.30 | — |
| Jepun | 6.36 | 5.74 | 5.30 | 11.37 | — | 6.78 |
| Korea | 4.31 | 3.54 | 4.25 | 7.30 | — | 7.85 |
| Perancis | 7.61 | 4.57 | 5.97 | 13.24 | 5.83 | — |
| Mandarin | 7.97 | 6.49 | 7.97 | 20.50 | — | 7.69 |
| Sepanyol (Amerika Latin) | 5.41 | 3.38 | 3.62 | 6.22 | 4.86 | — |
Sepuluh daripada bahasa yang paling banyak digunakan, satu enjin bagi setiap lajur. Setiap sel ialah kadar ralat enjin tersebut, lebih rendah lebih baik; hijau menandakan nilai terendah dalam baris, putih nilai kedua terendah. CER untuk bahasa Jepun, Korea dan Mandarin, WER untuk yang lain; kedua-duanya tidak pernah digabungkan menjadi satu angka. Ujian FLEURS oleh pasukan Whisper Notes, satu M5 MacBook Air, pertuturan yang dibaca.
Nama ringkas: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Tanda sengkang bermaksud enjin itu tiada model untuk bahasa tersebut.
Qwen3-ASR 1.7B telah mencatat kadar ralat terendah dalam enam daripada sepuluh bahasa, Whisper Large V3 Turbo dalam empat bahasa yang lain, dan Apple Speech tidak dalam mana-mana bahasa. Enjin ini paling hampir dalam bahasa Korea, 0.77 mata di belakang peneraju baris, kemudian bahasa Jepun pada 1.06 dan Mandarin pada 1.48, dan di situ ia seri dengan Whisper Large V3 Turbo pada 7.97. Jurang terbesar adalah dalam bahasa Inggeris, 8.80 (Apple Speech) berbanding 4.49 (Qwen3-ASR 1.7B), dan tiada hasil Apple Speech sama sekali bagi bahasa Belanda, Poland atau Rusia.
Berbanding Whisper Small, Apple Speech telah lebih tepat dalam lapan daripada sepuluh bahasa yang diukur dengan baik oleh kedua-duanya. Dua kekalahannya ialah bahasa Inggeris, 8.80 (Apple Speech) berbanding 7.04 (Whisper Small), dan Portugis Brazil, 9.35 berbanding 8.61.
Satu ujian yang diterbitkan pada bulan Julai telah mengukur Apple Speech dalam bahasa Inggeris berbanding Whisper Small dan meletakkan Apple di hadapan. Versi Whisper yang dibandingkan membawa perbezaan, begitu juga dengan klip. Ujian itu menggunakan LibriSpeech, iaitu pembaca buku audio yang membaca dengan kuat; ujian kami menggunakan FLEURS, dengan ramai penutur berbeza membaca ayat Wikipedia. Ujian kami menunjukkan jurang dalam bahasa Inggeris tetapi tidak dapat menentukan puncanya.
Berbanding Whisper Large V3 Turbo, susunannya terbalik. Apple Speech telah ketinggalan dalam lapan daripada sepuluh bahasa tersebut, seri dalam Mandarin pada 7.97 dan mendahului hanya dalam Kantonis, 8.69 (Apple Speech) berbanding 36.75 (Whisper Large V3 Turbo) — lihat baris Kantonis di bawah. Nota keluaran Turbo daripada OpenAI menyenaraikan Kantonis antara bahasa yang paling merosot pada model tersebut, jadi 36.75 ialah kelemahan Whisper yang diketahui, bukannya keanehan dalam ujian kami.
Dalam bahasa Korea, Apple Speech telah tersalah mengenal kira-kira satu daripada 23 aksara. Model paling tepat dalam ujian ini, Qwen3-ASR 1.7B, telah tersalah mengenal kira-kira satu daripada 28: 4.31 (Apple Speech) berbanding 3.54 (Qwen3-ASR 1.7B).
Parakeet V3 ialah muat turun 465 MB dan telah lebih tepat dalam setiap bahasa Eropah yang disokong oleh kedua-duanya: 6.89 (Parakeet V3) berbanding 8.80 (Apple Speech) dalam bahasa Inggeris, 5.83 berbanding 7.61 dalam bahasa Perancis, 4.86 berbanding 5.41 dalam bahasa Sepanyol, 3.43 berbanding 4.39 dalam bahasa Itali dan 6.49 berbanding 9.35 dalam Portugis Brazil; kedua-duanya seri dalam bahasa Jerman pada 6.26. Model ini tiada bahasa Jepun, Korea, Mandarin atau Kantonis; bagi bahasa tersebut Apple Speech ialah satu-satunya daripada kedua-duanya yang tersedia.
Enam baris yang didahului Qwen3-ASR 1.7B termasuk bahasa Inggeris, Jerman, Perancis dan Sepanyol.
SenseVoice Small ialah enjin terpantas di sini pada 162.3× masa nyata, dan dalam Mandarin serta bahasa Inggeris, enjin ini setara dengan Apple Speech: 7.69 (SenseVoice Small) berbanding 7.97 (Apple Speech) dan 8.46 berbanding 8.80. Dalam bahasa Korea, enjin ini telah jauh ketinggalan, 7.85 (SenseVoice Small) berbanding 4.31 (Apple Speech).
Saiz dan kelajuan
| Enjin | Kelajuan | Memori puncak | Muat turun |
|---|---|---|---|
| SenseVoice Small | 162.3× masa nyata | 0.95 GiB | 827 MB |
| Parakeet V3 | 75.6× masa nyata | 0.09 GiB | 465 MB |
| Apple Speech | 30.8× masa nyata | tidak dilaporkan | <5 MB |
| Qwen3-ASR 1.7B | 11.1× masa nyata | 2.43 GiB | kira-kira 2.5 GB |
| Whisper Small | 7.9× masa nyata | 0.87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3.0× masa nyata | 1.87 GiB | kira-kira 1.6 GB |
Kelajuan ialah median setiap enjin merentas tiga belas bahasa yang diukur dengan baik dalam artikel ini, hanya mengira bahasa yang telah dijalankan oleh enjin tersebut — daya pemprosesan item secara berasingan, satu diagnostik, bukannya kependaman produk. Memori puncak ialah puncak kumpulan proses dalam ujian ini. Apple Speech menyahkod dalam perkhidmatan macOS yang tidak dimiliki oleh aplikasi pemanggil, jadi tiada angka di situ yang membawa maksud sama seperti lima enjin yang lain.
Apple Speech telah berjalan pada 30.8× masa nyata, di belakang Parakeet V3 pada 75.6× dan SenseVoice Small pada 162.3×. Pek bahasanya dimuat turun sekali oleh macOS dan dikongsi oleh setiap aplikasi, jadi tiada apa-apa diperuntukkan dalam proses aplikasi itu sendiri. Perkhidmatan yang melakukan penyahkodan masih menggunakan memori, tetapi kami tidak dapat mengaitkannya dengan tepat; oleh itu, kami tidak melaporkan sebarang angka di situ dan bukannya melaporkan sifar.
Whisper Large V3 Turbo ialah enjin paling perlahan di sini pada 3.0× masa nyata dan mencatat kadar ralat terendah dalam empat daripada sepuluh baris, dengan kira-kira 1.6 GB pada cakera. Qwen3-ASR 1.7B mendahului enam baris yang lain, dengan kira-kira 2.5 GB pada cakera dan puncak 2.43 GiB. Whisper Small dengan 600 MB ialah perbandingan yang munasabah untuk enjin terbina dalam.
Bahasa apakah yang sesuai untuk Apple Speech?
Bahasa demi bahasa:
- Inggeris: tidak sesuai. Apple Speech telah mencatat 8.80; Qwen3-ASR 1.7B (4.49) atau Whisper Large V3 Turbo (5.49) jelas lebih tepat.
- Jerman: tidak sesuai. Apple Speech telah mencatat 6.26; Qwen3-ASR 1.7B (2.85) atau Whisper Large V3 Turbo (4.05) jelas lebih tepat.
- Belanda, Rusia dan Poland: Apple Speech tiada model untuk ketiga-tiganya. Whisper Large V3 Turbo telah menjadi yang paling tepat bagi setiap bahasa, pada 5.69, 5.13 dan 5.45.
- Jepun: boleh digunakan. Apple Speech telah mencatat 6.36, di belakang Whisper Large V3 Turbo pada 5.30.
- Korea: boleh digunakan. Apple Speech telah mencatat 4.31, di belakang Qwen3-ASR 1.7B pada 3.54.
- Perancis: tidak sesuai. Apple Speech telah mencatat 7.61; Qwen3-ASR 1.7B (4.57) atau Parakeet V3 (5.83) jelas lebih tepat.
- Mandarin: boleh digunakan. Apple Speech telah mencatat 7.97, seri dengan Whisper Large V3 Turbo; yang paling tepat ialah Qwen3-ASR 1.7B pada 6.49.
- Sepanyol: tidak sesuai. Apple Speech telah mencatat 5.41; Qwen3-ASR 1.7B (3.38) atau Whisper Large V3 Turbo (3.62) jelas lebih tepat.
Dalam ujian ini, model yang dimuat turun masih lebih tepat: setiap baris dalam jadual utama didahului Qwen3-ASR 1.7B atau Whisper Large V3 Turbo. Apple Speech ialah pilihan sebenar untuk bahasa Korea, Jepun dan Mandarin; bagi bahasa Eropah, Parakeet V3 ialah pilihan yang wajar.
Dalam Whisper Notes untuk Mac, Parakeet V3 masih merupakan model lalai. Dalam aplikasi Mac yang dimuat turun dari laman web kami, Apple Speech tersedia sebagai model pilihan pada macOS 26 atau lebih baharu, dan aplikasi hanya menawarkan sesuatu bahasa apabila macOS melaporkan bahawa Mac anda menyokongnya.
Apple Speech ialah singkatan dalam artikel ini untuk SpeechTranscriber milik Apple, API pada peranti yang boleh dipanggil oleh mana-mana aplikasi Mac pada macOS 26 atau lebih baharu. Ia ialah enjin sistem, bukan model yang anda muat turun: Whisper Notes untuk Mac boleh menggunakannya pada versi yang dimuat turun dari laman web kami, dengan pakej bahasa yang dibekalkan macOS. Model yang dimuat turun sendiri oleh aplikasi masih Whisper, Parakeet V3, SenseVoice dan Qwen3-ASR pada versi itu, serta Whisper, Parakeet V3 dan SenseVoice pada iPhone dan versi Mac App Store. Jadual bagi setiap enjin ialah senarai bahasa yang disokong Whisper, Parakeet V3 dan SenseVoice.
Selain sepuluh bahasa
| Bahasa | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Itali | 4.39 | 2.58 | 2.58 | 7.64 | 3.43 | — |
| Kantonis | 8.69 | 6.44 | 36.75 | 119.01 | — | 37.23 |
| Portugis (Brazil) | 9.35 | 5.17 | 5.44 | 8.61 | 6.49 | — |
| Hindi | 101.50 | 13.19 | 29.64 | 61.26 | — | — |
Empat bahasa lain daripada ujian yang sama. Lajur, warna dan nama ringkas yang sama seperti di atas; CER bagi Kantonis, WER bagi bahasa lain.
Hasil bahasa Hindi Apple Speech tidak disertakan dalam kedudukan baris tersebut atas sebab di bawah. Kadar ralat boleh melebihi 100% kerana sisipan turut dikira dalam pengangka.
Bahasa Itali pada 4.39 (Apple Speech) berada di belakang keputusan seri 2.58 antara Qwen3-ASR 1.7B dengan Whisper Large V3 Turbo. Kantonis ialah satu-satunya bahasa yang mana Apple Speech telah berada di hadapan Whisper Large V3 Turbo, 8.69 (Apple Speech) berbanding 36.75 (Whisper Large V3 Turbo), dengan Qwen3-ASR 1.7B di tempat pertama pada 6.44. Portugis Brazil berada pada 9.35 (Apple Speech), satu daripada dua baris yang mana Whisper Small, pada 8.61, berada di hadapan.
Bahasa Hindi ialah jenis hasil yang berbeza. Apple Speech telah menulis bahasa Hindi dengan huruf bahasa Inggeris dan bukannya cara penulisan bahasa Hindi sendiri, jadi hampir setiap perkataan dikira salah dan kadarnya melebihi 100%. Telugu, Urdu, Punjabi, Bengali, Nepal, Malayalam, Marathi, Kannada, Gujarati dan Tamil telah kembali dengan cara yang sama, semuanya melebihi 100%, lalu tidak disertakan dalam jadual.
Cara SpeechAnalyzer berfungsi
SpeechAnalyzer menggantikan API pengecaman pertuturan yang telah dimiliki Apple sejak iOS 10, pada setiap platform Apple kecuali watchOS. Aplikasi mencipta SpeechAnalyzer, memberinya modul dan menyalurkan audio sebagai urutan tak segerak yang diisi sendiri oleh aplikasi; SpeechTranscriber ialah modul yang menukar pertuturan kepada teks. Hasil kembali sebagai urutan kedua, biasanya pada tugas lain, dan setiap penimbal serta hasil mempunyai kod masa berdasarkan garis masa audio itu sendiri.
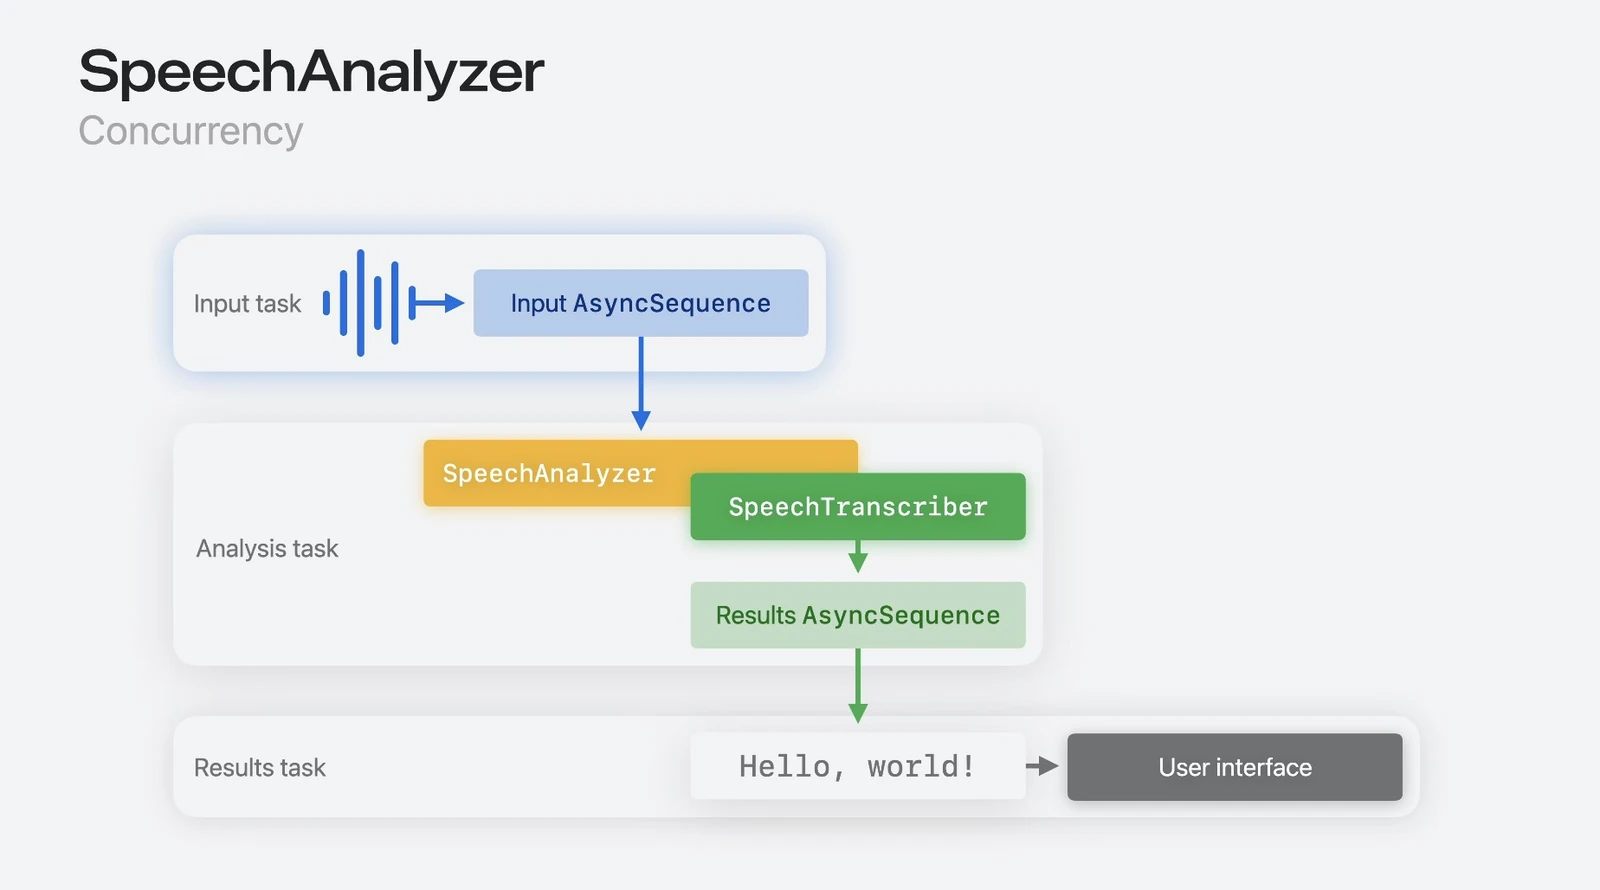
Satu sesi, tiga tugas: audio masuk sebagai AsyncSequence, SpeechAnalyzer dan SpeechTranscriber menganalisisnya, dan hasil kembali sebagai AsyncSequence kedua untuk dibaca oleh antara muka. Sumber: Apple, sesi 277 WWDC25.
Hasil tiba dua kali. Apa-apa di dalam julat yang disebut oleh Apple sebagai julat meruap masih boleh digantikan dengan hasil yang lebih baik; apa-apa di luarnya adalah muktamad. Dengan cara ini, aplikasi memaparkan transkrip kasar semasa anda masih bercakap dan membetulkannya selepas itu. Apple menyatakan lima matlamat reka bentuk untuk model SpeechTranscriber: audio panjang, pertuturan perbualan, penutur jauh, kependaman rendah dan privasi, yang bermaksud model berjalan pada peranti. Nota, Memo Suara, Jurnal dan peringkasan panggilan dibina berasaskannya.
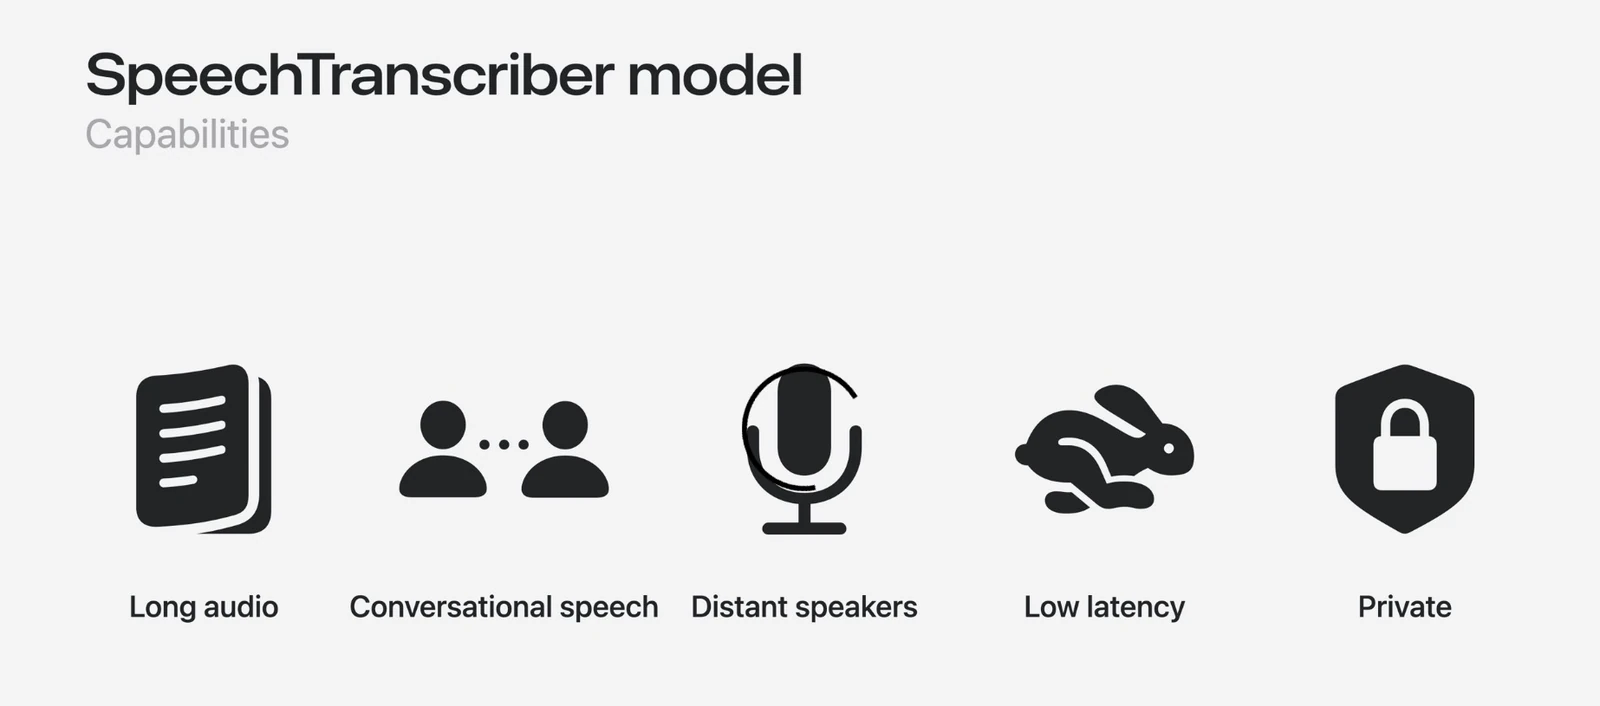
Lima matlamat reka bentuk yang dinyatakan oleh Apple untuk model SpeechTranscriber. Sumber: Apple, sesi 277 WWDC25.
Model-model tersebut bukan sebahagian daripada mana-mana aplikasi. Model dimuat turun daripada pelayan Apple melalui AssetInventory, disimpan dan dikemas kini oleh sistem serta dikongsi antara aplikasi. Model tidak menambah saiz muat turun aplikasi, dan penyahkodan berlaku di luar proses pemanggil. Apabila SpeechTranscriber tiada model bagi sesuatu bahasa atau peranti, DictationTranscriber mengambil alih dengan model yang sama seperti imlak sistem.
Kaedah dan batasan
Lima daripada enam enjin dalam jadual ini ialah model yang dimuat turun oleh Whisper Notes. Setiap enjin telah mentranskripsikan klip yang sama, dalam susunan yang sama, satu demi satu, pada M5 MacBook Air (32 GB, macOS 27.0). Audio itu berasal daripada bahagian ujian Google FLEURS pada semakan 70bb2e84, kira-kira 150 ayat dan 30 minit bagi setiap bahasa. Cincangan tetap ID bagi setiap item dalam set data telah menyusun item, dan kami mengambil jujukan item lengkap terpendek yang melepasi tiga puluh minit; tiada output model memainkan peranan dalam pilihan itu. Setiap sel telah dibina semula daripada bukti masing-masing dan diperiksa sekali lagi, dan kesemua 285 sel telah lulus. Skor ialah kadar ralat perkataan apabila perkataan dipisahkan oleh ruang, dan kadar ralat aksara bagi bahasa Jepun, Korea, Mandarin dan Kantonis; kedua-duanya tidak pernah digabungkan menjadi satu angka.
Lajur Whisper boleh anda semak dengan angka OpenAI sendiri. Bagi dua belas bahasa yang OpenAI menerbitkan hasil FLEURS untuk Whisper Large V3 Turbo, angka kami berada dalam perbezaan purata 0.7 mata daripada angkanya, dan sepuluh daripada dua belas berada dalam selang 95% ujian kami; bagi sebelas bahasa di luar baris bahasa India, angka Whisper Small kami berada dalam perbezaan purata 1.0 mata daripada jadual setiap bahasa dalam makalah Whisper. Lajur Apple Speech telah dihasilkan daripada klip yang sama, penilai yang sama dan penormal yang sama.
FLEURS ialah pertuturan bersih yang dibaca. Tiada apa-apa di sini yang menyatakan cara enjin ini berfungsi di dalam bilik bising atau sepanjang mesyuarat dua jam, dan kami tidak mengukur perbezaannya dalam keadaan tersebut. Semuanya telah berjalan pada satu mesin. Dengan kira-kira 150 ayat bagi setiap bahasa, dua enjin yang berbeza kurang daripada kira-kira satu mata dianggap seri; jadual telah menandakan keputusan seri tepat seperti itu, contohnya dalam bahasa Itali, yang mana Qwen3-ASR 1.7B dan Whisper Large V3 Turbo kedua-duanya telah mencatat 2.58.
Soalan Lazim
Apple Speech atau Whisper Small: yang mana lebih tepat?
Apple Speech, dalam lapan daripada sepuluh bahasa yang diukur dengan baik oleh kedua-duanya. Ia kalah dalam bahasa Inggeris, 8.80 (Apple Speech) berbanding 7.04 (Whisper Small), dan Portugis Brazil, 9.35 berbanding 8.61. Jurang terluasnya ialah Mandarin, 7.97 (Apple Speech) berbanding 20.50 (Whisper Small); bahasa Perancis, 7.61 berbanding 13.24; bahasa Jepun, 6.36 berbanding 11.37; dan Kantonis, 8.69 berbanding 119.01. Whisper Small ialah muat turun 600 MB dan berjalan pada 7.9× masa nyata, berbanding 30.8× bagi Apple Speech.
Apple Speech atau Parakeet V3: yang mana lebih tepat?
Parakeet V3, dalam setiap bahasa Eropah yang disokong oleh kedua-duanya: 6.89 (Parakeet V3) berbanding 8.80 (Apple Speech) dalam bahasa Inggeris, 5.83 berbanding 7.61 dalam bahasa Perancis, 4.86 berbanding 5.41 dalam bahasa Sepanyol, 3.43 berbanding 4.39 dalam bahasa Itali dan 6.49 berbanding 9.35 dalam Portugis Brazil; kedua-duanya seri dalam bahasa Jerman pada 6.26. Parakeet V3 tiada bahasa Jepun, Korea, Mandarin atau Kantonis, jadi di situ Apple Speech ialah satu-satunya daripada kedua-duanya yang tersedia. Parakeet V3 ialah muat turun 465 MB dan berjalan pada 75.6× masa nyata, Apple Speech pada 30.8×.
Apple Speech atau Whisper Large V3 Turbo: yang mana lebih tepat?
Whisper Large V3 Turbo, dalam lapan daripada sepuluh bahasa yang diukur dengan baik oleh kedua-duanya: bahasa Inggeris 5.49 (Whisper Large V3 Turbo) berbanding 8.80 (Apple Speech), bahasa Jerman 4.05 berbanding 6.26, bahasa Jepun 5.30 berbanding 6.36, bahasa Korea 4.25 berbanding 4.31, bahasa Perancis 5.97 berbanding 7.61, bahasa Sepanyol 3.62 berbanding 5.41, bahasa Itali 2.58 berbanding 4.39, Portugis Brazil 5.44 berbanding 9.35. Kedua-duanya seri dalam Mandarin pada 7.97; Apple Speech mendahului hanya dalam Kantonis, 8.69 (Apple Speech) berbanding 36.75 (Whisper Large V3 Turbo). Turbo turut merangkumi bahasa Belanda, Rusia dan Poland, pada 5.69, 5.13 dan 5.45. Saiznya kira-kira 1.6 GB dan ia enjin paling perlahan di sini pada 3.0× masa nyata.
Bahasa apakah yang disokong oleh Apple Speech?
Dalam ujian kami, Apple Speech memberikan hasil bagi 21 daripada 83 konfigurasi: bahasa Inggeris, Jerman, Perancis, Sepanyol, Itali, Portugis (Brazil), Jepun, Korea, Mandarin, Kantonis, dan sebelas bahasa Asia Selatan — Hindi, Telugu, Urdu, Punjabi, Bengali, Nepal, Malayalam, Marathi, Kannada, Gujarati dan Tamil — yang dijawabnya dalam huruf bahasa Inggeris dan bukannya cara penulisannya sendiri. Tiada bahasa Belanda, Poland atau Rusia; macOS menentukan senarai itu bagi setiap mesin. Enjin ini paling hampir dengan peneraju dalam bahasa Korea, Jepun dan Mandarin, 0.77, 1.06 dan 1.48 di belakang; paling jauh dalam bahasa Inggeris, 8.80 (Apple Speech) berbanding 4.49 (Qwen3-ASR 1.7B); dan mendahului imlak lama dalam kesemua sepuluh bahasa yang diukur oleh kedua-duanya. Whisper dalam Whisper Notes merangkumi seluruh senarai bahasa aplikasi pada setiap saluran.
Apakah SpeechAnalyzer, dan adakah ia sama dengan Apple Dictation?
SpeechAnalyzer ialah API yang diperkenalkan oleh Apple pada WWDC 2025 dan disertakan dalam macOS 26 serta iOS 26. SpeechTranscriber ialah enjin transkripsi di dalamnya, yang disebut artikel ini sebagai Apple Speech; imlak ialah enjin keserasian yang lebih lama. Kami telah menjalankan kedua-duanya, dan Apple Speech telah lebih tepat dalam kesemua sepuluh bahasa yang diukur dengan baik oleh kedua-duanya. Imlak merangkumi lebih banyak bahasa, 33 konfigurasi berbanding 21, termasuk bahasa Belanda, Poland dan Rusia pada 17.34%, 13.50% dan 13.13% WER (imlak), berbanding 5.69%, 5.45% dan 5.13% (Whisper Large V3 Turbo).
Adakah audio meninggalkan Mac saya apabila saya menggunakan Apple Speech?
Apple mendokumentasikan SpeechTranscriber sebagai pengecaman pertuturan pada peranti: macOS memuat turun aset bahasa sekali, kemudian pengecaman berjalan secara setempat. Kami telah mengukur ketepatan dan kelajuan, bukannya tingkah laku rangkaian, jadi kami menerangkan bahagian itu seperti yang diterangkan Apple. Enjin yang dimuat turun sendiri oleh Whisper Notes — Whisper, Parakeet V3, SenseVoice dan Qwen3-ASR — berjalan pada GPU atau Neural Engine Mac anda sendiri tanpa akaun dan tanpa API key, dan transkripsi berfungsi apabila rangkaian dimatikan pada setiap saluran. Apple Speech tersedia dalam aplikasi Mac yang dimuat turun dari laman web kami, pada macOS 26 atau lebih baharu: enjin sistem pada Mac anda, dengan pakej bahasanya dimuat turun oleh macOS.
Mengapakah angka ini tidak sepadan dengan ketepatan pada rakaman saya?
Kerana FLEURS ialah pertuturan pendek, bersih dan dibaca, sedangkan rakaman anda tidak sedemikian. Ujian kami ialah penentukuran pada set data awam: kira-kira 150 ayat dan 30 minit bagi setiap bahasa, satu M5 MacBook Air, dan klip yang sama bagi setiap enjin. Hasil ini menunjukkan sama ada enjin munasabah untuk bahasa anda, bukan apa yang akan anda peroleh dalam mesyuarat, pada audio bising atau pada fail dua jam.
Cuba Sekarang
Lima model yang boleh dimuat turun di sini — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small dan Qwen3-ASR 1.7B — semuanya tersedia dalam aplikasi Whisper Notes untuk Mac yang dimuat turun dari laman web kami, di Tetapan, kemudian Model Transkripsi. Pada macOS 26 atau lebih baharu, Apple Speech muncul dalam senarai yang sama; jika aplikasi sudah dipasang, kemas kininya ke versi terbaharu.
Jika angka kami tidak sepadan dengan pengalaman anda dalam sesuatu bahasa, e-mel mac@whispernotes.app. Nota keluaran penuh: whispernotes.app/changelog.
Sumber: ujian kami pada bahagian ujian Google FLEURS pada semakan 70bb2e84, dokumentasi SpeechAnalyzer Apple, dan ujian Qwen3-ASR tiga puluh bahasa sebelumnya.
 Muat turun untuk macOS