Depuis macOS 26 et iOS 26, Apple propose une nouvelle génération de reconnaissance vocale sur appareil — SpeechAnalyzer et SpeechTranscriber, appelés Apple Speech dans la suite. Elle est nettement plus précise que l'ancien moteur de dictée. Ce que nous voulions savoir, c'est comment elle se compare en conditions réelles aux modèles ouverts sur appareil que l'on télécharge — Whisper, Parakeet, Qwen3-ASR et SenseVoice : la reconnaissance vocale intégrée d'Apple est-elle désormais assez bonne pour se passer complètement d'une app de transcription ?
Quel progrès par rapport à la dictée que vous aviez déjà ?
Jusqu'ici, la reconnaissance vocale d'un Mac reposait sur le moteur de l'époque de SFSpeechRecognizer, celui qu'utilise encore aujourd'hui la dictée système (DictationTranscriber). macOS 26 et iOS 26 ajoutent l'API SpeechAnalyzer et son module SpeechTranscriber. Nous avons exécuté les deux sur la partie test de FLEURS, environ 150 phrases et 30 minutes par langue, sur le même Mac.
| Langue | Apple Dictation | Apple Speech |
|---|---|---|
| Coréen | 7,11 | 4,31 |
| Italien | 6,93 | 4,39 |
| Espagnol (Amérique latine) | 8,43 | 5,41 |
| Allemand | 12,69 | 6,26 |
| Japonais | 9,37 | 6,36 |
| Français | 17,10 | 7,61 |
| Chinois | 10,28 | 7,97 |
| Cantonais | 10,18 | 8,69 |
| Anglais | 13,83 | 8,80 |
| Portugais (Brésil) | 10,85 | 9,35 |
Toutes les langues mesurées proprement par les deux moteurs Apple, classées selon le taux d'erreur d'Apple Speech ; le vert indique la meilleure valeur de la ligne. Même série, mêmes extraits, même Mac. CER pour le japonais, le coréen, le chinois et le cantonais, WER pour le reste.
Apple Speech est plus précis dans les dix langues mesurées proprement par les deux moteurs. En français et en allemand, plus de la moitié des erreurs disparaissent ; pour la langue médiane, environ un tiers ; pour le portugais brésilien et le cantonais, environ une erreur sur sept.
La dictée couvre toujours davantage de langues. Apple Speech a produit des résultats pour 21 des 83 configurations linguistiques de cette série, contre 33 pour la dictée, dont les trois absentes du nouveau moteur ici : le néerlandais, le polonais et le russe, à 17,34, 13,50 et 13,13. Il n'existe pas non plus de liste fixe à citer. Les ressources linguistiques appartiennent à macOS, une app demande donc à l'exécution ce dont dispose une machine donnée.
Peut-on alors se passer des modèles téléchargés ?
Six moteurs, les mêmes extraits, un seul Mac. Les dix langues ci-dessous font partie des plus utilisées ; leur ordre est fixe et sans rapport avec les scores.
| Langue | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Anglais | 8,80 | 4,49 | 5,49 | 7,04 | 6,89 | 8,46 |
| Allemand | 6,26 | 2,85 | 4,05 | 8,67 | 6,26 | — |
| Néerlandais | — | 7,36 | 5,69 | 16,75 | 8,58 | — |
| Russe | — | 5,65 | 5,13 | 11,37 | 7,12 | — |
| Polonais | — | 12,59 | 5,45 | 15,81 | 8,30 | — |
| Japonais | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Coréen | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Français | 7,61 | 4,57 | 5,97 | 13,24 | 5,83 | — |
| Chinois | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Espagnol (Amérique latine) | 5,41 | 3,38 | 3,62 | 6,22 | 4,86 | — |
Dix des langues les plus utilisées, un moteur par colonne. Chaque cellule indique le taux d'erreur du moteur ; plus il est bas, mieux c'est. Le vert marque le plus bas de la ligne, le blanc le deuxième. CER pour le japonais, le coréen et le chinois, WER pour le reste, jamais fusionnés en un seul chiffre. Notre propre série FLEURS, réalisée par l'équipe de Whisper Notes, sur un M5 MacBook Air, parole lue.
Noms courts : Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Un tiret signifie que le moteur n'a pas de modèle pour cette langue.
Qwen3-ASR 1.7B affiche le taux d'erreur le plus bas dans six des dix langues, Whisper Large V3 Turbo dans les quatre autres et Apple Speech dans aucune. Ce dernier s'approche le plus du meilleur de la ligne en coréen, à 0,77 point, puis en japonais à 1,06 et en chinois à 1,48, où il est à égalité avec Whisper Large V3 Turbo à 7,97. L'écart est le plus grand en anglais, avec 8,80 (Apple Speech) contre 4,49 (Qwen3-ASR 1.7B), et Apple Speech n'a aucun résultat pour le néerlandais, le polonais et le russe.
Face à Whisper Small, Apple Speech était plus précis dans huit des dix langues mesurées proprement par les deux. Les deux langues où il a perdu sont l'anglais, avec 8,80 (Apple Speech) contre 7,04 (Whisper Small), et le portugais brésilien, avec 9,35 contre 8,61.
Une évaluation publiée en juillet a comparé Apple Speech à Whisper Small en anglais et placé Apple devant. Le modèle Whisper choisi compte, tout comme les extraits. Cette évaluation utilisait LibriSpeech, avec des narrateurs de livres audio lisant à voix haute ; la nôtre utilise FLEURS, avec de nombreux locuteurs lisant des phrases de Wikipédia. Notre série montre l'écart en anglais, sans permettre d'en déterminer la cause.
Face à Whisper Large V3 Turbo, l'ordre s'inverse. Apple Speech reste derrière dans huit de ces dix langues, est à égalité en chinois à 7,97 et ne mène qu'en cantonais, avec 8,69 (Apple Speech) contre 36,75 (Whisper Large V3 Turbo) — voir la ligne du cantonais ci-dessous. Les notes de version d'OpenAI pour Turbo citent le cantonais parmi les langues où le modèle se dégrade le plus ; 36,75 est donc une faiblesse connue de Whisper, pas une particularité de notre série.
En coréen, Apple Speech se trompe sur environ un caractère sur 23. Le modèle le plus précis de cette série, Qwen3-ASR 1.7B, se trompe sur environ un sur 28 : 4,31 (Apple Speech) contre 3,54 (Qwen3-ASR 1.7B).
Parakeet V3 représente un téléchargement de 465 Mo et est plus précis dans toutes les langues européennes couvertes par les deux : 6,89 (Parakeet V3) contre 8,80 (Apple Speech) en anglais, 5,83 contre 7,61 en français, 4,86 contre 5,41 en espagnol, 3,43 contre 4,39 en italien et 6,49 contre 9,35 en portugais brésilien ; les deux sont à égalité en allemand à 6,26. Il n'a ni japonais, ni coréen, ni chinois, ni cantonais : dans ces langues, Apple Speech est le seul des deux qui existe.
Parmi les six lignes dominées par Qwen3-ASR 1.7B figurent l'anglais, l'allemand, le français et l'espagnol.
SenseVoice Small est le moteur le plus rapide ici, à 162,3× le temps réel. En chinois et en anglais, il est au même niveau qu'Apple Speech : 7,69 (SenseVoice Small) contre 7,97 (Apple Speech), puis 8,46 contre 8,80. En coréen, il est loin derrière, à 7,85 (SenseVoice Small) contre 4,31 (Apple Speech).
Taille et vitesse
| Moteur | Vitesse | Mémoire maximale | Téléchargement |
|---|---|---|---|
| SenseVoice Small | 162,3× le temps réel | 0,95 GiB | 827 Mo |
| Parakeet V3 | 75,6× le temps réel | 0,09 GiB | 465 Mo |
| Apple Speech | 30,8× le temps réel | non communiquée | <5 Mo |
| Qwen3-ASR 1.7B | 11,1× le temps réel | 2,43 GiB | environ 2,5 Go |
| Whisper Small | 7,9× le temps réel | 0,87 GiB | 600 Mo |
| Whisper Large V3 Turbo | 3,0× le temps réel | 1,87 GiB | environ 1,6 Go |
La vitesse est la médiane de chaque moteur sur les treize langues mesurées proprement dans cet article, en ne comptant que celles qu'il a exécutées — le débit de traitement d'éléments isolés, une valeur de diagnostic et non la latence du produit. La mémoire maximale est le pic du groupe de processus dans cette série. Apple Speech décode dans un service macOS qui n'appartient pas à l'app appelante ; aucune valeur à cet endroit n'aurait donc le même sens que pour les cinq autres.
Apple Speech a tourné à 30,8× le temps réel, derrière Parakeet V3 à 75,6× et SenseVoice Small à 162,3×. Son pack linguistique est téléchargé une seule fois par macOS et partagé par toutes les apps, si bien que rien n'est alloué dans le propre processus de l'app. Le service qui assure le décodage utilise tout de même de la mémoire, sans que nous puissions l'attribuer précisément ; nous ne communiquons donc aucune valeur plutôt qu'un zéro.
Whisper Large V3 Turbo est le moteur le plus lent ici, à 3,0× le temps réel, et affiche le taux d'erreur le plus bas dans quatre des dix lignes, pour environ 1,6 Go sur disque. Qwen3-ASR 1.7B remporte les six autres, pour environ 2,5 Go sur disque et un pic de 2,43 GiB. Whisper Small constitue la comparaison équitable avec un moteur intégré, à 600 Mo.
Pour quelles langues Apple Speech est-il un bon choix ?
Langue par langue :
- Anglais : choix peu adapté. Apple Speech a obtenu 8,80 ; Qwen3-ASR 1.7B (4,49) ou Whisper Large V3 Turbo (5,49) est nettement plus précis.
- Allemand : choix peu adapté. Apple Speech a obtenu 6,26 ; Qwen3-ASR 1.7B (2,85) ou Whisper Large V3 Turbo (4,05) est nettement plus précis.
- Néerlandais, russe et polonais : Apple Speech n'a pas de modèle pour ces trois langues. Whisper Large V3 Turbo était le plus précis pour chacune, à 5,69, 5,13 et 5,45.
- Japonais : utilisable. Apple Speech a obtenu 6,36, derrière Whisper Large V3 Turbo à 5,30.
- Coréen : utilisable. Apple Speech a obtenu 4,31, derrière Qwen3-ASR 1.7B à 3,54.
- Français : choix peu adapté. Apple Speech a obtenu 7,61 ; Qwen3-ASR 1.7B (4,57) ou Parakeet V3 (5,83) est nettement plus précis.
- Chinois : utilisable. Apple Speech a obtenu 7,97, à égalité avec Whisper Large V3 Turbo ; le plus précis était Qwen3-ASR 1.7B à 6,49.
- Espagnol : choix peu adapté. Apple Speech a obtenu 5,41 ; Qwen3-ASR 1.7B (3,38) ou Whisper Large V3 Turbo (3,62) est nettement plus précis.
Les modèles téléchargés restent les plus précis : chaque ligne du tableau principal est dominée par Qwen3-ASR 1.7B ou Whisper Large V3 Turbo. Apple Speech est une véritable option en coréen, en japonais et en chinois ; pour les langues européennes, Parakeet V3 est le choix à privilégier.
Dans Whisper Notes pour Mac, Parakeet V3 reste le modèle par défaut. Dans l'app Mac téléchargée sur notre site, Apple Speech est disponible comme modèle optionnel sous macOS 26 ou version ultérieure, et l'app ne propose une langue que si macOS signale qu'elle est prise en charge sur votre Mac.
Apple Speech est le nom court donné ici au SpeechTranscriber d'Apple, l'API sur appareil que toute app Mac peut appeler sous macOS 26 ou version ultérieure. C'est un moteur du système plutôt qu'un modèle à télécharger : Whisper Notes pour Mac peut l'utiliser dans la version téléchargée sur notre site, avec le pack linguistique fourni par macOS. Les modèles que l'app télécharge elle-même restent Whisper, Parakeet V3, SenseVoice et Qwen3-ASR dans cette version, et Whisper, Parakeet V3 et SenseVoice sur iPhone et dans la version du Mac App Store. Le tableau par moteur se trouve dans notre liste des langues prises en charge par Whisper, Parakeet V3 et SenseVoice.
Au-delà des dix langues
| Langue | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Italien | 4,39 | 2,58 | 2,58 | 7,64 | 3,43 | — |
| Cantonais | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Portugais (Brésil) | 9,35 | 5,17 | 5,44 | 8,61 | 6,49 | — |
| Hindi | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Quatre langues supplémentaires de la même série. Mêmes colonnes, couleurs et noms courts que ci-dessus ; CER pour le cantonais, WER pour le reste.
Le résultat d'Apple Speech en hindi est exclu du classement de cette ligne, pour la raison expliquée ci-dessous. Un taux d'erreur peut dépasser 100 % parce que les insertions comptent elles aussi au numérateur.
L'italien, à 4,39 (Apple Speech), se place derrière l'égalité à 2,58 entre Qwen3-ASR 1.7B et Whisper Large V3 Turbo. Le cantonais est la langue où Apple Speech devance Whisper Large V3 Turbo, avec 8,69 (Apple Speech) contre 36,75 (Whisper Large V3 Turbo), tandis que Qwen3-ASR 1.7B arrive en tête à 6,44. Le portugais brésilien est à 9,35 (Apple Speech) : c'est l'une des deux lignes où Whisper Small, à 8,61, est devant.
Le hindi donne un résultat d'un autre type. Apple Speech a écrit le hindi avec des lettres anglaises au lieu de l'écrire dans le système d'écriture propre au hindi ; presque chaque mot compte donc comme faux et le taux dépasse 100 %. Le télougou, l'ourdou, le pendjabi, le bengali, le népalais, le malayalam, le marathi, le kannada, le gujarati et le tamoul ont donné le même type de résultat, tous au-dessus de 100 % ; ils ne figurent donc pas dans le tableau.
Fonctionnement de SpeechAnalyzer
SpeechAnalyzer remplace l'API de reconnaissance vocale qu'Apple propose depuis iOS 10, sur toutes les plateformes Apple sauf watchOS. Une app crée un SpeechAnalyzer, lui fournit des modules et l'alimente en audio sous la forme d'une séquence asynchrone qu'elle remplit elle-même ; SpeechTranscriber est le module qui transforme la parole en texte. Les résultats reviennent sous la forme d'une seconde séquence, généralement dans une autre tâche, et chaque mémoire tampon comme chaque résultat est horodaté par rapport à la propre chronologie de l'audio.
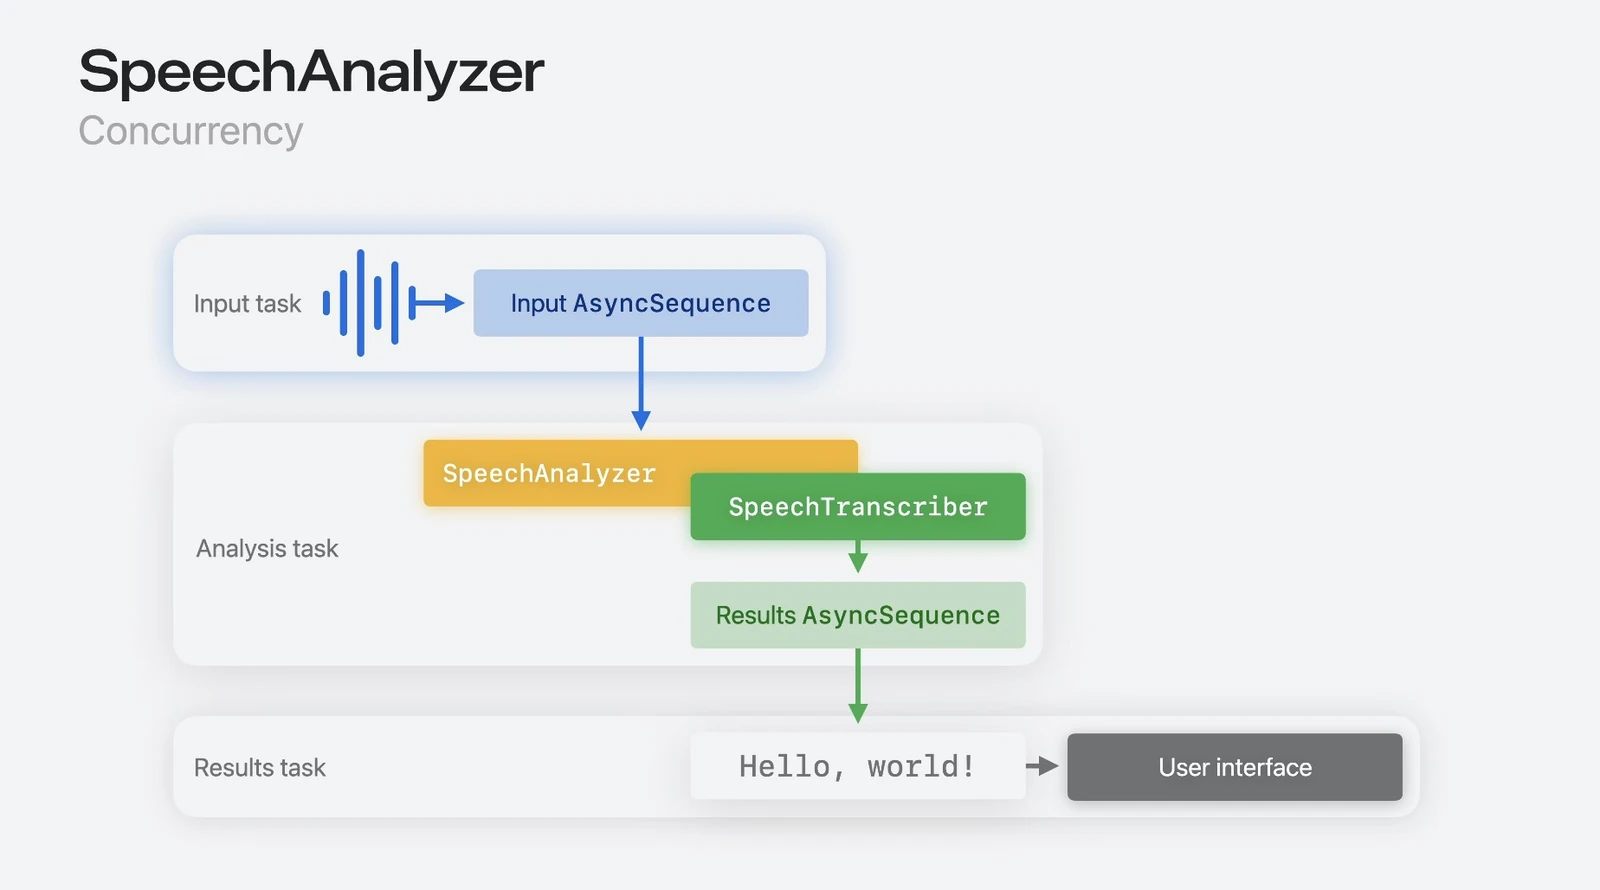
Une session, trois tâches : l'audio entre sous forme d'AsyncSequence, SpeechAnalyzer et SpeechTranscriber l'analysent, puis les résultats reviennent dans une seconde AsyncSequence que l'interface peut lire. Source : Apple, session 277 de la WWDC25.
Les résultats arrivent deux fois. Tout ce qui se trouve dans ce qu'Apple appelle la plage volatile peut encore être remplacé par un meilleur résultat ; tout ce qui est à l'extérieur est définitif. C'est ainsi qu'une app affiche une transcription provisoire pendant que vous parlez encore, puis la corrige ensuite. Apple énonce cinq objectifs de conception pour le modèle SpeechTranscriber : audio long, parole conversationnelle, locuteurs éloignés, faible latence et confidentialité, ce qui signifie qu'il s'exécute sur l'appareil. Notes, Dictaphone, Journal et les résumés d'appels reposent dessus.
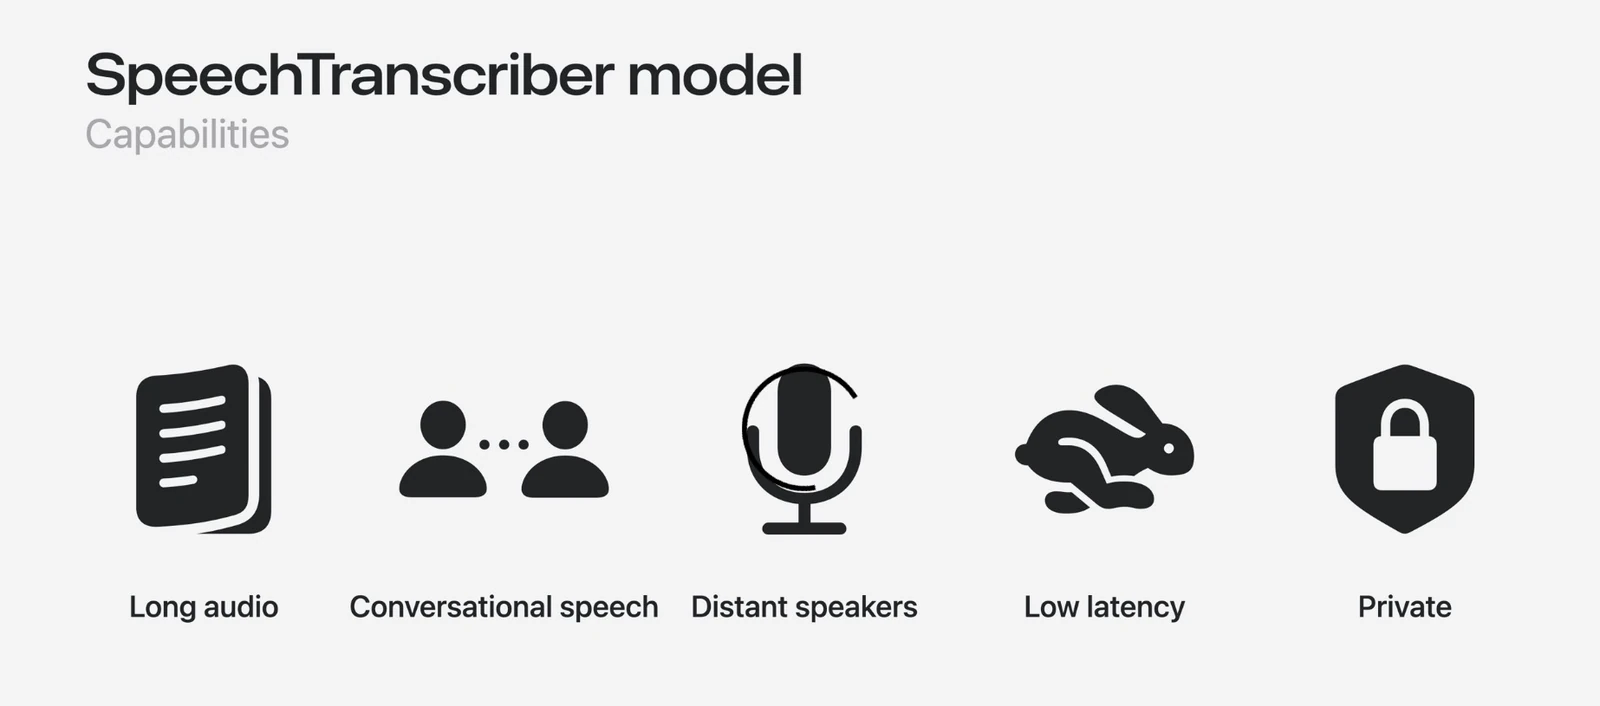
Les cinq objectifs de conception annoncés par Apple pour le modèle SpeechTranscriber. Source : Apple, session 277 de la WWDC25.
Les modèles ne font partie d'aucune app. Ils sont téléchargés depuis les serveurs d'Apple par AssetInventory, stockés et mis à jour par le système, puis partagés entre les apps. Ils n'ajoutent rien à la taille de téléchargement de l'app, et le décodage a lieu hors du processus appelant. Lorsque SpeechTranscriber n'a pas de modèle pour une langue ou un appareil, DictationTranscriber prend le relais avec les mêmes modèles que la dictée système.
Méthode et limites
Cinq des six moteurs de ces tableaux sont des modèles téléchargés par Whisper Notes. Chaque moteur a transcrit les mêmes extraits, dans le même ordre et un par un, sur un M5 MacBook Air (32 Go, macOS 27.0). L'audio provient du jeu de test Google FLEURS à la révision 70bb2e84, environ 150 phrases et 30 minutes par langue. Un hachage fixe des identifiants d'élément du jeu de données ordonne les éléments, et nous prenons la plus courte suite d'éléments entiers qui dépasse trente minutes ; aucune sortie de modèle n'a participé à ce choix. Chaque cellule a été reconstruite à partir de son propre relevé et vérifiée à nouveau, et les 285 ont réussi. Les scores sont le taux d'erreur sur les mots lorsque les mots sont séparés par des espaces, et le taux d'erreur sur les caractères pour le japonais, le coréen, le chinois et le cantonais, sans jamais les fusionner en un seul chiffre.
Vous pouvez comparer les colonnes Whisper aux propres chiffres d'OpenAI. Pour les douze langues dont OpenAI publie un résultat FLEURS de Whisper Large V3 Turbo, nos chiffres se situent en moyenne à 0,7 point des siens, et dix des douze se trouvent dans l'intervalle à 95 % de notre série ; pour les onze langues hors des lignes d'Asie du Sud, nos chiffres de Whisper Small se situent en moyenne à 1,0 point du tableau par langue de l'article sur Whisper. La colonne Apple Speech provient des mêmes extraits, du même outil d'évaluation et de la même normalisation.
FLEURS contient de la parole lue et propre. Rien ici n'indique comment ces moteurs se comportent dans une pièce bruyante ou pendant une réunion de deux heures, et nous n'avons pas mesuré les écarts dans ces conditions. Toute la série a été exécutée sur une seule machine. Avec environ 150 phrases par langue, deux moteurs séparés de moins d'environ un point sont à égalité ; les tableaux indiquent déjà ainsi les égalités exactes, comme en italien, où Qwen3-ASR 1.7B et Whisper Large V3 Turbo ont tous deux obtenu 2,58.
Questions fréquentes
Apple Speech ou Whisper Small : lequel est le plus précis ?
Apple Speech, dans huit des dix langues mesurées proprement par les deux. Il perd en anglais, avec 8,80 (Apple Speech) contre 7,04 (Whisper Small), et en portugais brésilien, avec 9,35 contre 8,61. Ses écarts les plus nets sont en chinois, 7,97 (Apple Speech) contre 20,50 (Whisper Small) ; en français, 7,61 contre 13,24 ; en japonais, 6,36 contre 11,37 ; et en cantonais, 8,69 contre 119,01. Whisper Small représente un téléchargement de 600 Mo et tourne à 7,9× le temps réel, contre 30,8× pour Apple Speech.
Apple Speech ou Parakeet V3 : lequel est le plus précis ?
Parakeet V3, dans toutes les langues européennes couvertes par les deux : 6,89 (Parakeet V3) contre 8,80 (Apple Speech) en anglais, 5,83 contre 7,61 en français, 4,86 contre 5,41 en espagnol, 3,43 contre 4,39 en italien et 6,49 contre 9,35 en portugais brésilien, à égalité en allemand à 6,26. Parakeet V3 n'a ni japonais, ni coréen, ni chinois, ni cantonais : dans ces langues, Apple Speech est le seul des deux qui existe. Parakeet V3 représente un téléchargement de 465 Mo et tourne à 75,6× le temps réel, Apple Speech à 30,8×.
Apple Speech ou Whisper Large V3 Turbo : lequel est le plus précis ?
Whisper Large V3 Turbo, dans huit des dix langues mesurées proprement par les deux : anglais 5,49 (Whisper Large V3 Turbo) contre 8,80 (Apple Speech), allemand 4,05 contre 6,26, japonais 5,30 contre 6,36, coréen 4,25 contre 4,31, français 5,97 contre 7,61, espagnol 3,62 contre 5,41, italien 2,58 contre 4,39, portugais brésilien 5,44 contre 9,35. Les deux sont à égalité en chinois à 7,97 ; Apple Speech ne mène qu'en cantonais, avec 8,69 (Apple Speech) contre 36,75 (Whisper Large V3 Turbo). Turbo couvre aussi le néerlandais, le russe et le polonais, à 5,69, 5,13 et 5,45. Il pèse environ 1,6 Go et reste le moteur le plus lent ici, à 3,0× le temps réel.
Quelles langues Apple Speech prend-il en charge ?
Dans notre série, Apple Speech a produit des résultats dans 21 des 83 configurations : anglais, allemand, français, espagnol, italien, portugais (Brésil), japonais, coréen, chinois, cantonais, et onze langues d'Asie du Sud — hindi, télougou, ourdou, pendjabi, bengali, népalais, malayalam, marathi, kannada, gujarati et tamoul — pour lesquelles il a répondu avec des lettres anglaises, pas avec leur propre écriture. Pas de néerlandais, de polonais ni de russe ; c'est macOS qui décide de la liste, machine par machine. Il s'approche le plus des meilleurs de la ligne en coréen, en japonais et en chinois, à 0,77, 1,06 et 1,48, et s'en éloigne le plus en anglais, avec 8,80 (Apple Speech) contre 4,49 (Qwen3-ASR 1.7B) ; il devance l'ancienne dictée dans les dix langues mesurées par les deux. Whisper dans Whisper Notes couvre toute la liste des langues de l'app, sur chaque canal.
Qu'est-ce que SpeechAnalyzer, et est-ce la même chose qu'Apple Dictation ?
SpeechAnalyzer est l'API qu'Apple a présentée à la WWDC 2025 et livrée avec macOS 26 et iOS 26. SpeechTranscriber est le moteur de transcription qu'elle contient, appelé Apple Speech dans cet article ; la dictée est l'ancien moteur de compatibilité. Nous avons exécuté les deux, et Apple Speech était plus précis dans les dix langues mesurées proprement par les deux. La dictée couvre davantage de langues, avec 33 configurations contre 21, dont le néerlandais, le polonais et le russe à 17,34 %, 13,50 % et 13,13 % de WER (dictée), contre 5,69 %, 5,45 % et 5,13 % (Whisper Large V3 Turbo).
L'audio quitte-t-il mon Mac lorsque j'utilise Apple Speech ?
Apple présente SpeechTranscriber comme une reconnaissance vocale sur appareil : macOS télécharge une fois les ressources linguistiques et la reconnaissance s'exécute localement. Nous avons mesuré la précision et la vitesse, pas le comportement du réseau ; nous décrivons donc cette partie telle qu'Apple la décrit. Les moteurs que Whisper Notes télécharge lui-même — Whisper, Parakeet V3, SenseVoice et Qwen3-ASR — s'exécutent sur le GPU ou le Neural Engine de votre propre Mac sans compte ni API key, et la transcription fonctionne sans réseau, sur chaque canal. Apple Speech est disponible dans l'app Mac téléchargée sur notre site, sous macOS 26 ou version ultérieure : un moteur du système sur votre Mac, dont le pack linguistique est téléchargé par macOS.
Pourquoi ces chiffres ne correspondent-ils pas à la précision obtenue sur mes enregistrements ?
Parce que FLEURS contient de la parole lue, courte et propre, contrairement à vos enregistrements. Notre série est un étalonnage sur un jeu de données public : environ 150 phrases et 30 minutes par langue, un M5 MacBook Air, les mêmes extraits pour chaque moteur. Elle indique si un moteur est plausible pour votre langue, pas ce que vous obtiendrez dans une réunion, sur un audio bruité ou avec un fichier de deux heures.
Essayez-les
Les cinq modèles téléchargeables présentés ici — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small et Qwen3-ASR 1.7B — figurent tous dans l'app Whisper Notes pour Mac téléchargée sur notre site, sous Réglages, puis Modèle de transcription. Sous macOS 26 ou version ultérieure, Apple Speech apparaît dans la même liste ; si vous avez déjà l'app, mettez-la à jour vers la dernière version.
Si nos chiffres ne correspondent pas à votre expérience dans une langue, écrivez à mac@whispernotes.app. Notes de version complètes : whispernotes.app/changelog.
Sources : notre série sur le jeu de test Google FLEURS à la révision 70bb2e84, la documentation SpeechAnalyzer d'Apple, et la série Qwen3-ASR en trente langues qui l'a précédée.
 Télécharger pour macOS