Desde o macOS 26 e o iOS 26, a Apple oferece uma nova geração de reconhecimento de voz no dispositivo — SpeechAnalyzer e SpeechTranscriber, chamados abaixo, de forma abreviada, de Apple Speech. Ela é claramente mais precisa que o antigo mecanismo de ditado. Queríamos saber como ela se compara, no uso real, aos modelos abertos no dispositivo que as pessoas baixam — Whisper, Parakeet, Qwen3-ASR e SenseVoice: o reconhecimento de voz integrado da Apple já é bom o bastante para você dispensar completamente um app de transcrição?
Quanto ele supera o ditado que você já tinha?
Até agora, o reconhecimento de voz do Mac era o mecanismo da era do SFSpeechRecognizer, o mesmo que o ditado do sistema ainda usa (DictationTranscriber). O macOS 26 e o iOS 26 acrescentam a API SpeechAnalyzer e o módulo SpeechTranscriber. Rodamos os dois no conjunto de teste do FLEURS, cerca de 150 frases e 30 minutos por idioma, no mesmo Mac.
| Idioma | Ditado da Apple | Apple Speech |
|---|---|---|
| Coreano | 7,11 | 4,31 |
| Italiano | 6,93 | 4,39 |
| Espanhol (América Latina) | 8,43 | 5,41 |
| Alemão | 12,69 | 6,26 |
| Japonês | 9,37 | 6,36 |
| Francês | 17,10 | 7,61 |
| Chinês | 10,28 | 7,97 |
| Cantonês | 10,18 | 8,69 |
| Inglês | 13,83 | 8,80 |
| Português (Brasil) | 10,85 | 9,35 |
Todos os idiomas medidos corretamente pelos dois mecanismos da Apple, ordenados pela taxa de erro do Apple Speech; o verde marca o melhor valor da linha. Mesmo teste, mesmos trechos, mesmo Mac. CER para japonês, coreano, chinês e cantonês, WER para os demais.
O Apple Speech é mais preciso nos dez idiomas medidos corretamente pelos dois mecanismos. No francês e no alemão desaparece mais da metade dos erros, no idioma mediano cerca de um terço e, no português do Brasil e no cantonês, cerca de um erro em sete.
O ditado ainda alcança mais idiomas. O Apple Speech retornou resultados para 21 das 83 configurações de idioma deste teste, e o ditado para 33, incluindo as três que faltam aqui ao novo mecanismo: holandês, polonês e russo, com 17,34, 13,50 e 13,13. Também não existe uma lista fixa para citar. Os recursos de idioma pertencem ao macOS, então um app pergunta em tempo de execução o que está disponível em uma determinada máquina.
Então você pode dispensar os modelos baixados?
Seis mecanismos, os mesmos trechos, um Mac. Os dez idiomas abaixo estão entre os mais usados e aparecem em uma ordem fixa que não tem relação com os resultados.
| Idioma | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Inglês | 8,80 | 4,49 | 5,49 | 7,04 | 6,89 | 8,46 |
| Alemão | 6,26 | 2,85 | 4,05 | 8,67 | 6,26 | — |
| Holandês | — | 7,36 | 5,69 | 16,75 | 8,58 | — |
| Russo | — | 5,65 | 5,13 | 11,37 | 7,12 | — |
| Polonês | — | 12,59 | 5,45 | 15,81 | 8,30 | — |
| Japonês | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Coreano | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Francês | 7,61 | 4,57 | 5,97 | 13,24 | 5,83 | — |
| Chinês | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Espanhol (América Latina) | 5,41 | 3,38 | 3,62 | 6,22 | 4,86 | — |
Dez dos idiomas mais usados, um mecanismo por coluna. Cada célula mostra a taxa de erro desse mecanismo: quanto menor, melhor; o verde marca o menor valor da linha e o branco o segundo menor. CER para japonês, coreano e chinês, WER para os demais, nunca combinados em um único número. O nosso teste FLEURS, feito pela equipe do Whisper Notes, em um único M5 MacBook Air, fala lida.
Nomes abreviados: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Um travessão significa que o mecanismo não tem modelo para esse idioma.
O Qwen3-ASR 1.7B tem a taxa de erro mais baixa em seis dos dez idiomas, o Whisper Large V3 Turbo nos outros quatro e o Apple Speech em nenhum. Ele chega mais perto no coreano, 0,77 atrás do líder da linha, depois no japonês, a 1,06, e no chinês, a 1,48, onde empata com o Whisper Large V3 Turbo em 7,97. Fica mais distante no inglês, 8,80 (Apple Speech) contra 4,49 (Qwen3-ASR 1.7B), e não existe nenhum resultado do Apple Speech para holandês, polonês ou russo.
Contra o Whisper Small, o Apple Speech foi mais preciso em oito dos dez idiomas medidos corretamente pelos dois. As duas derrotas são o inglês, 8,80 (Apple Speech) contra 7,04 (Whisper Small), e o português do Brasil, 9,35 contra 8,61.
Um benchmark publicado em julho mediu o Apple Speech em inglês contra o Whisper Small e colocou a Apple na frente. Faz diferença qual versão do Whisper entra na comparação, assim como os trechos usados. Esse teste usou o LibriSpeech, com narradores de audiolivros lendo em voz alta; o nosso usa o FLEURS, com muitos falantes diferentes lendo frases da Wikipedia. Nosso teste mostra a diferença no inglês, mas não pode dizer o que a causa.
Contra o Whisper Large V3 Turbo, a ordem se inverte. O Apple Speech fica atrás em oito desses dez idiomas, empata no chinês em 7,97 e lidera apenas no cantonês, 8,69 (Apple Speech) contra 36,75 (Whisper Large V3 Turbo) — veja a linha do cantonês abaixo. Nas notas de lançamento do Turbo, a OpenAI inclui o cantonês entre os idiomas em que o modelo mais piora; portanto, 36,75 é uma fraqueza conhecida do Whisper, não uma particularidade do nosso teste.
No coreano, o Apple Speech erra cerca de um caractere em 23. O modelo mais preciso deste teste, o Qwen3-ASR 1.7B, erra cerca de um em 28: 4,31 (Apple Speech) contra 3,54 (Qwen3-ASR 1.7B).
O Parakeet V3 exige um download de 465 MB e é mais preciso em todos os idiomas europeus cobertos pelos dois: 6,89 (Parakeet V3) contra 8,80 (Apple Speech) no inglês, 5,83 contra 7,61 no francês, 4,86 contra 5,41 no espanhol, 3,43 contra 4,39 no italiano e 6,49 contra 9,35 no português do Brasil; no alemão, os dois empatam em 6,26. Ele não tem japonês, coreano, chinês nem cantonês, casos em que o Apple Speech é o único dos dois disponível.
As seis linhas lideradas pelo Qwen3-ASR 1.7B incluem inglês, alemão, francês e espanhol.
O SenseVoice Small é o mecanismo mais rápido, a 162,3× o tempo real. No chinês e no inglês, ele fica no mesmo nível do Apple Speech: 7,69 (SenseVoice Small) contra 7,97 (Apple Speech) e 8,46 contra 8,80. No coreano, fica muito atrás, 7,85 (SenseVoice Small) contra 4,31 (Apple Speech).
Tamanho e velocidade
| Mecanismo | Velocidade | Pico de memória | Download |
|---|---|---|---|
| SenseVoice Small | 162,3× o tempo real | 0,95 GiB | 827 MB |
| Parakeet V3 | 75,6× o tempo real | 0,09 GiB | 465 MB |
| Apple Speech | 30,8× o tempo real | não indicado | <5 MB |
| Qwen3-ASR 1.7B | 11,1× o tempo real | 2,43 GiB | cerca de 2,5 GB |
| Whisper Small | 7,9× o tempo real | 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3,0× o tempo real | 1,87 GiB | cerca de 1,6 GB |
A velocidade é a mediana de cada mecanismo nos treze idiomas que este post mede corretamente, contando apenas aqueles em que ele rodou — vazão do processamento de itens isolados, um diagnóstico, não a latência do produto. O pico de memória é o máximo do grupo de processos neste teste. O Apple Speech decodifica dentro de um serviço do macOS que não pertence ao app que faz a chamada, então nenhum valor teria o mesmo significado que os dos outros cinco.
O Apple Speech rodou a 30,8× o tempo real, atrás do Parakeet V3 a 75,6× e do SenseVoice Small a 162,3×. O pacote de idioma dele é baixado uma única vez pelo macOS e compartilhado por todos os apps, então nada é alocado no processo do próprio app. O serviço que faz a decodificação ainda usa memória, e não podemos atribuí-la com exatidão; por isso, não informamos nenhum número ali em vez de indicar zero.
O Whisper Large V3 Turbo é o mecanismo mais lento, a 3,0× o tempo real, e tem a taxa de erro mais baixa em quatro das dez linhas, usando cerca de 1,6 GB no disco. O Qwen3-ASR 1.7B vence as outras seis, usando cerca de 2,5 GB no disco e com um pico de 2,43 GiB. O Whisper Small, com 600 MB, é a comparação adequada para um mecanismo integrado.
Para quais idiomas o Apple Speech é uma boa opção?
Idioma por idioma:
- Inglês: não é uma boa opção. O Apple Speech marcou 8,80; Qwen3-ASR 1.7B (4,49) ou o Whisper Large V3 Turbo (5,49) é claramente mais preciso.
- Alemão: não é uma boa opção. O Apple Speech marcou 6,26; Qwen3-ASR 1.7B (2,85) ou o Whisper Large V3 Turbo (4,05) é claramente mais preciso.
- Holandês, russo e polonês: o Apple Speech não tem modelo para estes três idiomas. Whisper Large V3 Turbo foi o mais preciso em todos, com 5,69, 5,13 e 5,45.
- Japonês: utilizável. O Apple Speech marcou 6,36, atrás do Whisper Large V3 Turbo com 5,30.
- Coreano: utilizável. O Apple Speech marcou 4,31, atrás do Qwen3-ASR 1.7B com 3,54.
- Francês: não é uma boa opção. O Apple Speech marcou 7,61; Qwen3-ASR 1.7B (4,57) ou o Parakeet V3 (5,83) é claramente mais preciso.
- Chinês: utilizável. O Apple Speech marcou 7,97, empatado com o Whisper Large V3 Turbo; o mais preciso foi o Qwen3-ASR 1.7B com 6,49.
- Espanhol: não é uma boa opção. O Apple Speech marcou 5,41; Qwen3-ASR 1.7B (3,38) ou o Whisper Large V3 Turbo (3,62) é claramente mais preciso.
Os modelos baixados ainda vencem em precisão: todas as linhas da tabela principal são lideradas pelo Qwen3-ASR 1.7B ou pelo Whisper Large V3 Turbo. O Apple Speech é uma opção real para coreano, japonês e chinês; nos idiomas europeus, o Parakeet V3 é a escolha indicada.
No Whisper Notes para Mac, o Parakeet V3 continua sendo o modelo padrão. No app para Mac que você baixa do nosso site, o Apple Speech fica disponível como modelo opcional no macOS 26 ou posterior, e o app só oferece um idioma quando o macOS informa que o seu Mac tem suporte para ele.
Apple Speech é a abreviação usada neste post para o SpeechTranscriber da Apple, a API no dispositivo que qualquer app para Mac pode chamar no macOS 26 ou posterior. Ele é um mecanismo do sistema, não um modelo que você baixa: o Whisper Notes para Mac pode usá-lo na versão baixada do nosso site, com o pacote de idioma fornecido pelo macOS. Os modelos que o próprio app baixa continuam sendo o Whisper, o Parakeet V3, o SenseVoice e o Qwen3-ASR nessa versão, e o Whisper, o Parakeet V3 e o SenseVoice no iPhone e na versão da Mac App Store. A tabela por mecanismo é a nossa lista de idiomas suportados pelo Whisper, Parakeet V3 e SenseVoice.
Além dos dez idiomas
| Idioma | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Italiano | 4,39 | 2,58 | 2,58 | 7,64 | 3,43 | — |
| Cantonês | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Português (Brasil) | 9,35 | 5,17 | 5,44 | 8,61 | 6,49 | — |
| Hindi | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Mais quatro idiomas do mesmo teste. As mesmas colunas, cores e nomes curtos usados acima; CER para cantonês, WER para os demais.
O resultado do Apple Speech em hindi é excluído da classificação daquela linha pelo motivo abaixo. Uma taxa de erro pode passar de 100% porque as inserções também contam no numerador.
O italiano, com 4,39 (Apple Speech), fica atrás do empate em 2,58 entre o Qwen3-ASR 1.7B e o Whisper Large V3 Turbo. O cantonês é o único idioma em que o Apple Speech terminou à frente do Whisper Large V3 Turbo, 8,69 (Apple Speech) contra 36,75 (Whisper Large V3 Turbo), com o Qwen3-ASR 1.7B em primeiro em 6,44. O português do Brasil fica em 9,35 (Apple Speech), uma das duas linhas em que o Whisper Small, com 8,61, fica à frente.
O hindi produziu um tipo diferente de resultado. O Apple Speech escreveu o hindi com letras inglesas em vez de usar a forma de escrita própria do idioma, por isso quase todas as palavras contam como erradas e a taxa passa de 100%. Telugu, urdu, punjabi, bengali, nepalês, malaiala, marata, canarês, guzerate e tâmil retornaram da mesma forma, todos acima de 100%, e por isso foram excluídos da tabela.
Como funciona o SpeechAnalyzer
O SpeechAnalyzer substitui a API de reconhecimento de voz que a Apple oferece desde o iOS 10, em todas as plataformas da Apple, exceto o watchOS. Um app cria um SpeechAnalyzer, fornece módulos e envia áudio como uma sequência assíncrona que o próprio app preenche; o SpeechTranscriber é o módulo que transforma a fala em texto. Os resultados retornam como uma segunda sequência, geralmente em outra tarefa, e cada buffer e cada resultado têm um código de tempo relativo à linha do tempo do áudio.
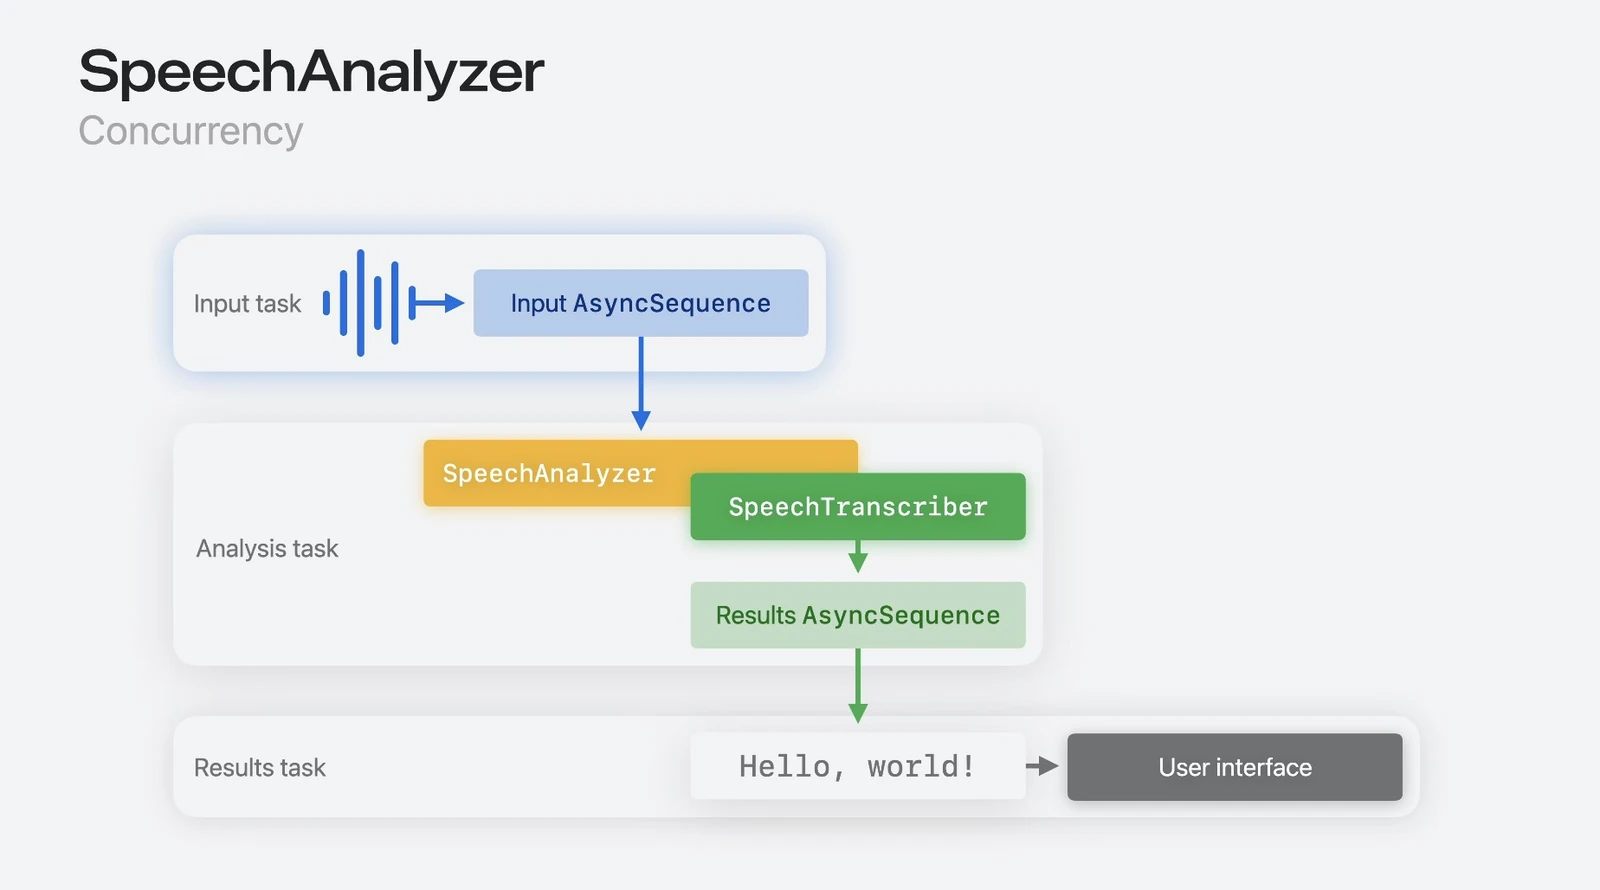
Uma sessão, três tarefas: o áudio entra como AsyncSequence, o SpeechAnalyzer e o SpeechTranscriber o analisam e os resultados voltam como uma segunda AsyncSequence que a interface pode ler. Fonte: Apple, sessão WWDC25 277.
Os resultados chegam duas vezes. Tudo dentro do que a Apple chama de intervalo volátil ainda pode ser substituído por um resultado melhor; tudo fora dele é definitivo. É assim que um app mostra uma transcrição provisória enquanto você ainda está falando e a corrige depois. A Apple indica cinco objetivos de design para o modelo SpeechTranscriber: áudio longo, fala conversacional, vozes distantes, baixa latência e privacidade, o que significa que ele roda no dispositivo. Os apps Notas, Gravador e Diário, além do resumo de chamadas, usam esse modelo.
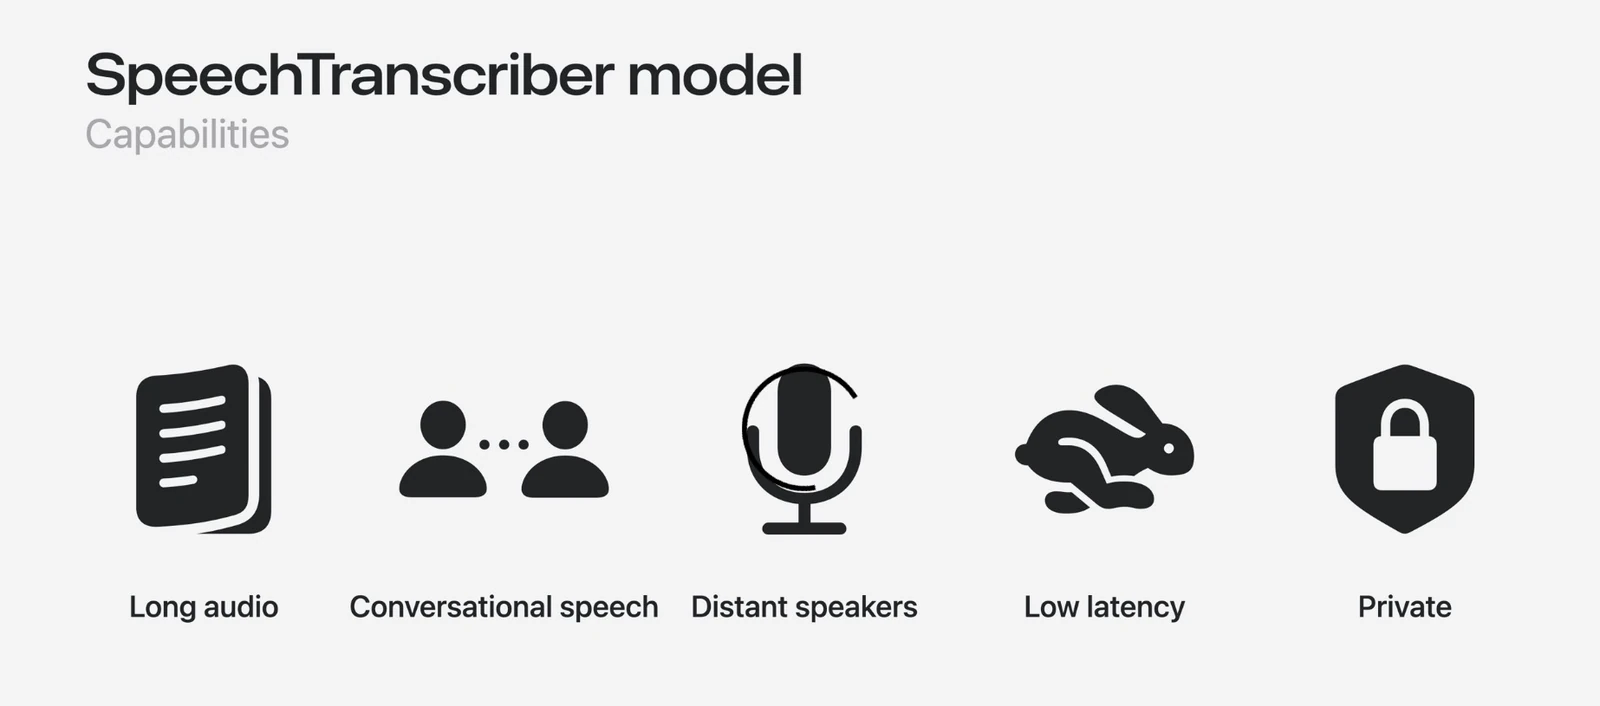
Os cinco objetivos de design declarados pela Apple para o modelo SpeechTranscriber. Fonte: Apple, sessão WWDC25 277.
Os modelos não fazem parte de nenhum app. Eles são baixados dos servidores da Apple pelo AssetInventory, armazenados e atualizados pelo sistema e compartilhados entre apps. Não acrescentam nada ao tamanho do download de um app, e a decodificação acontece fora do processo que fez a chamada. Quando o SpeechTranscriber não tem um modelo para um idioma ou dispositivo, o DictationTranscriber assume com os mesmos modelos do ditado do sistema.
Método e limitações
Cinco dos seis mecanismos destas tabelas são modelos baixados pelo Whisper Notes. Cada mecanismo transcreveu os mesmos trechos, na mesma ordem, um de cada vez, em um M5 MacBook Air (32 GB, macOS 27.0). O áudio vem do conjunto de teste do Google FLEURS na revisão 70bb2e84, cerca de 150 frases e 30 minutos por idioma. Um hash fixo dos IDs dos próprios itens do conjunto de dados coloca os itens em ordem, e usamos a sequência mais curta de itens completos que passa de trinta minutos; nenhum resultado de modelo influenciou essa escolha. Cada célula foi reconstruída a partir do respectivo comprovante e verificada novamente; todas as 285 passaram. Os valores são taxas de erro de palavras quando elas são separadas por espaços e taxas de erro de caracteres para japonês, coreano, chinês e cantonês, nunca reunidas em um só número.
Você pode conferir as colunas do Whisper com os números da própria OpenAI. Nos doze idiomas para os quais a OpenAI publica um resultado FLEURS do Whisper Large V3 Turbo, nossos valores ficam, em média, a 0,7 ponto dos valores da OpenAI, e dez dos doze estão dentro do intervalo de 95% do nosso teste. Nos onze idiomas fora das linhas de idiomas do sul da Ásia, nossos valores do Whisper Small ficam, em média, a 1,0 ponto da tabela por idioma no artigo sobre o Whisper. A coluna do Apple Speech veio dos mesmos trechos, do mesmo avaliador e da mesma normalização.
O FLEURS é fala lida e limpa. Nada aqui diz como esses mecanismos se comportam em uma sala barulhenta ou durante uma reunião de duas horas, e não medimos a diferença nesses casos. Tudo rodou em uma só máquina. Com cerca de 150 frases por idioma, dois mecanismos separados por menos de cerca de um ponto são considerados empatados; as tabelas já marcam assim os empates exatos, como no italiano, em que o Qwen3-ASR 1.7B e o Whisper Large V3 Turbo marcaram 2,58.
Perguntas frequentes
Apple Speech ou Whisper Small: qual é mais preciso?
O Apple Speech, em oito dos dez idiomas medidos corretamente pelos dois. Ele perde no inglês, 8,80 (Apple Speech) contra 7,04 (Whisper Small), e no português do Brasil, 9,35 contra 8,61. As maiores vantagens estão no chinês, 7,97 (Apple Speech) contra 20,50 (Whisper Small); no francês, 7,61 contra 13,24; no japonês, 6,36 contra 11,37; e no cantonês, 8,69 contra 119,01. O Whisper Small exige um download de 600 MB e rodou a 7,9× o tempo real, contra 30,8× do Apple Speech.
Apple Speech ou Parakeet V3: qual é mais preciso?
O Parakeet V3, em todos os idiomas europeus cobertos pelos dois: 6,89 (Parakeet V3) contra 8,80 (Apple Speech) no inglês, 5,83 contra 7,61 no francês, 4,86 contra 5,41 no espanhol, 3,43 contra 4,39 no italiano e 6,49 contra 9,35 no português do Brasil; no alemão, os dois empatam em 6,26. O Parakeet V3 não tem japonês, coreano, chinês nem cantonês, casos em que o Apple Speech é o único dos dois disponível. O Parakeet V3 exige um download de 465 MB e rodou a 75,6× o tempo real, e o Apple Speech a 30,8×.
Apple Speech ou Whisper Large V3 Turbo: qual é mais preciso?
O Whisper Large V3 Turbo, em oito dos dez idiomas medidos corretamente pelos dois: inglês 5,49 (Whisper Large V3 Turbo) contra 8,80 (Apple Speech), alemão 4,05 contra 6,26, japonês 5,30 contra 6,36, coreano 4,25 contra 4,31, francês 5,97 contra 7,61, espanhol 3,62 contra 5,41, italiano 2,58 contra 4,39, português do Brasil 5,44 contra 9,35. No chinês, os dois empatam em 7,97; o Apple Speech lidera apenas no cantonês, 8,69 (Apple Speech) contra 36,75 (Whisper Large V3 Turbo). O Turbo cobre ainda holandês, russo e polonês, com 5,69, 5,13 e 5,45. Ele ocupa cerca de 1,6 GB e é o mecanismo mais lento aqui, a 3,0× o tempo real.
Que idiomas são suportados pelo Apple Speech?
No nosso teste, o Apple Speech retornou resultados em 21 das 83 configurações: inglês, alemão, francês, espanhol, italiano, português (Brasil), japonês, coreano, chinês, cantonês e onze idiomas do sul da Ásia — hindi, telugu, urdu, punjabi, bengali, nepalês, malaiala, marata, canarês, guzerate e tâmil — nos quais ele respondeu com letras inglesas, e não na forma de escrita de cada um. Não tem holandês, polonês nem russo; a lista é decidida pelo macOS, máquina a máquina. Ele chega mais perto dos líderes da linha no coreano, no japonês e no chinês, a 0,77, 1,06 e 1,48, e fica mais distante no inglês, 8,80 (Apple Speech) contra 4,49 (Qwen3-ASR 1.7B); nos dez idiomas medidos pelos dois, ele fica à frente do antigo ditado. O Whisper no Whisper Notes cobre toda a lista de idiomas do app, em todos os canais.
O que é o SpeechAnalyzer e é igual ao ditado da Apple?
O SpeechAnalyzer é a API que a Apple apresentou na WWDC 2025 e lançou no macOS 26 e no iOS 26. O SpeechTranscriber é o mecanismo de transcrição dentro dela, aquilo que este post chama de Apple Speech; o ditado é o antigo mecanismo de compatibilidade. Rodamos os dois, e o Apple Speech foi mais preciso nos dez idiomas medidos corretamente por ambos. O ditado alcança mais idiomas, 33 configurações contra 21, incluindo holandês, polonês e russo com 17,34%, 13,50% e 13,13% de WER (ditado), contra 5,69%, 5,45% e 5,13% (Whisper Large V3 Turbo).
O áudio sai do meu Mac quando eu uso o Apple Speech?
A Apple documenta o SpeechTranscriber como reconhecimento de voz no dispositivo: o macOS baixa os recursos de idioma uma vez e o reconhecimento roda localmente. Medimos a precisão e a velocidade, não o comportamento da rede, então descrevemos essa parte como a Apple a descreve. Os mecanismos que o próprio Whisper Notes baixa — Whisper, Parakeet V3, SenseVoice e Qwen3-ASR — rodam na GPU ou no Neural Engine do seu Mac, sem conta e sem API key, e a transcrição funciona com a rede desligada em todos os canais. O Apple Speech está disponível no app para Mac baixado do nosso site, no macOS 26 ou posterior: um mecanismo do sistema no seu Mac, com o pacote de idioma baixado pelo macOS.
Por que estes números não correspondem à precisão que eu obtenho nas minhas gravações?
Porque o FLEURS é fala lida, curta e limpa, e as suas gravações não são. O nosso teste é uma calibração em um conjunto de dados público: cerca de 150 frases e 30 minutos por idioma, um único M5 MacBook Air e os mesmos trechos para todos os mecanismos. Ele diz se um mecanismo é plausível para o seu idioma, não o que você vai obter em uma reunião, em áudio com ruído ou em um arquivo de duas horas.
Experimente
Os cinco modelos disponíveis para baixar aqui — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small e Qwen3-ASR 1.7B — estão todos no app Whisper Notes para Mac que você baixa do nosso site, em Ajustes e depois Modelo de transcrição. No macOS 26 ou posterior, o Apple Speech aparece na mesma lista; se você já tem o app, atualize para a versão mais recente.
Se os nossos números não baterem com a sua experiência em um idioma, escreva para mac@whispernotes.app. Notas de versão completas: whispernotes.app/changelog.
Fontes: o nosso teste no conjunto de teste do Google FLEURS na revisão 70bb2e84, a documentação da Apple sobre o SpeechAnalyzer, e o teste do Qwen3-ASR em trinta idiomas que o antecedeu.
 Baixar para macOS