A Mistral lançou o Voxtral, sua primeira família de modelos de pesos abertos para transcrição e compreensão de áudio. Os benchmarks oficiais mostram um reconhecimento de fala multilíngue forte e perguntas e respostas sobre áudio, mas os dois tamanhos de modelo têm requisitos de hardware bem diferentes. Veja o que o lançamento realmente suporta e por que o Whisper Notes continua usando modelos menores, focados em transcrição, em hardware Apple de consumo.
Dois Modelos
A Mistral lançou dois checkpoints Apache 2.0 em julho de 2025:
Voxtral Small 24B
- •24 bilhões de parâmetros
- •Transcrição, tradução, perguntas e respostas sobre áudio e sumarização
- •Janela de contexto de 32k
- •Cerca de 55 GB de RAM de GPU em bf16/fp16
Voxtral Mini 3B
- •3 bilhões de parâmetros
- •A mesma família de tarefas de áudio e texto em um checkpoint menor
- •Posicionado oficialmente para implantação local e edge
- •Cerca de 9,5 GB de RAM de GPU em bf16/fp16
Pesos Abertos e Licença
Os dois checkpoints de 2025 têm pesos abertos sob a licença Apache 2.0. Você pode baixá-los e executá-los por conta própria:
- ✓ Pesos completos do modelo disponíveis
- ✓ Hospede você mesmo ou adapte os modelos dentro dos termos da licença Apache 2.0
- ✓ Sem taxa de API da Mistral na auto-hospedagem; você ainda paga pela sua própria computação
- ✓ Processe o áudio nos seus próprios servidores
Fontes: o anúncio de lançamento do Voxtral da Mistral, o card oficial do modelo Voxtral Small e o card oficial do modelo Voxtral Mini.
Benchmarks
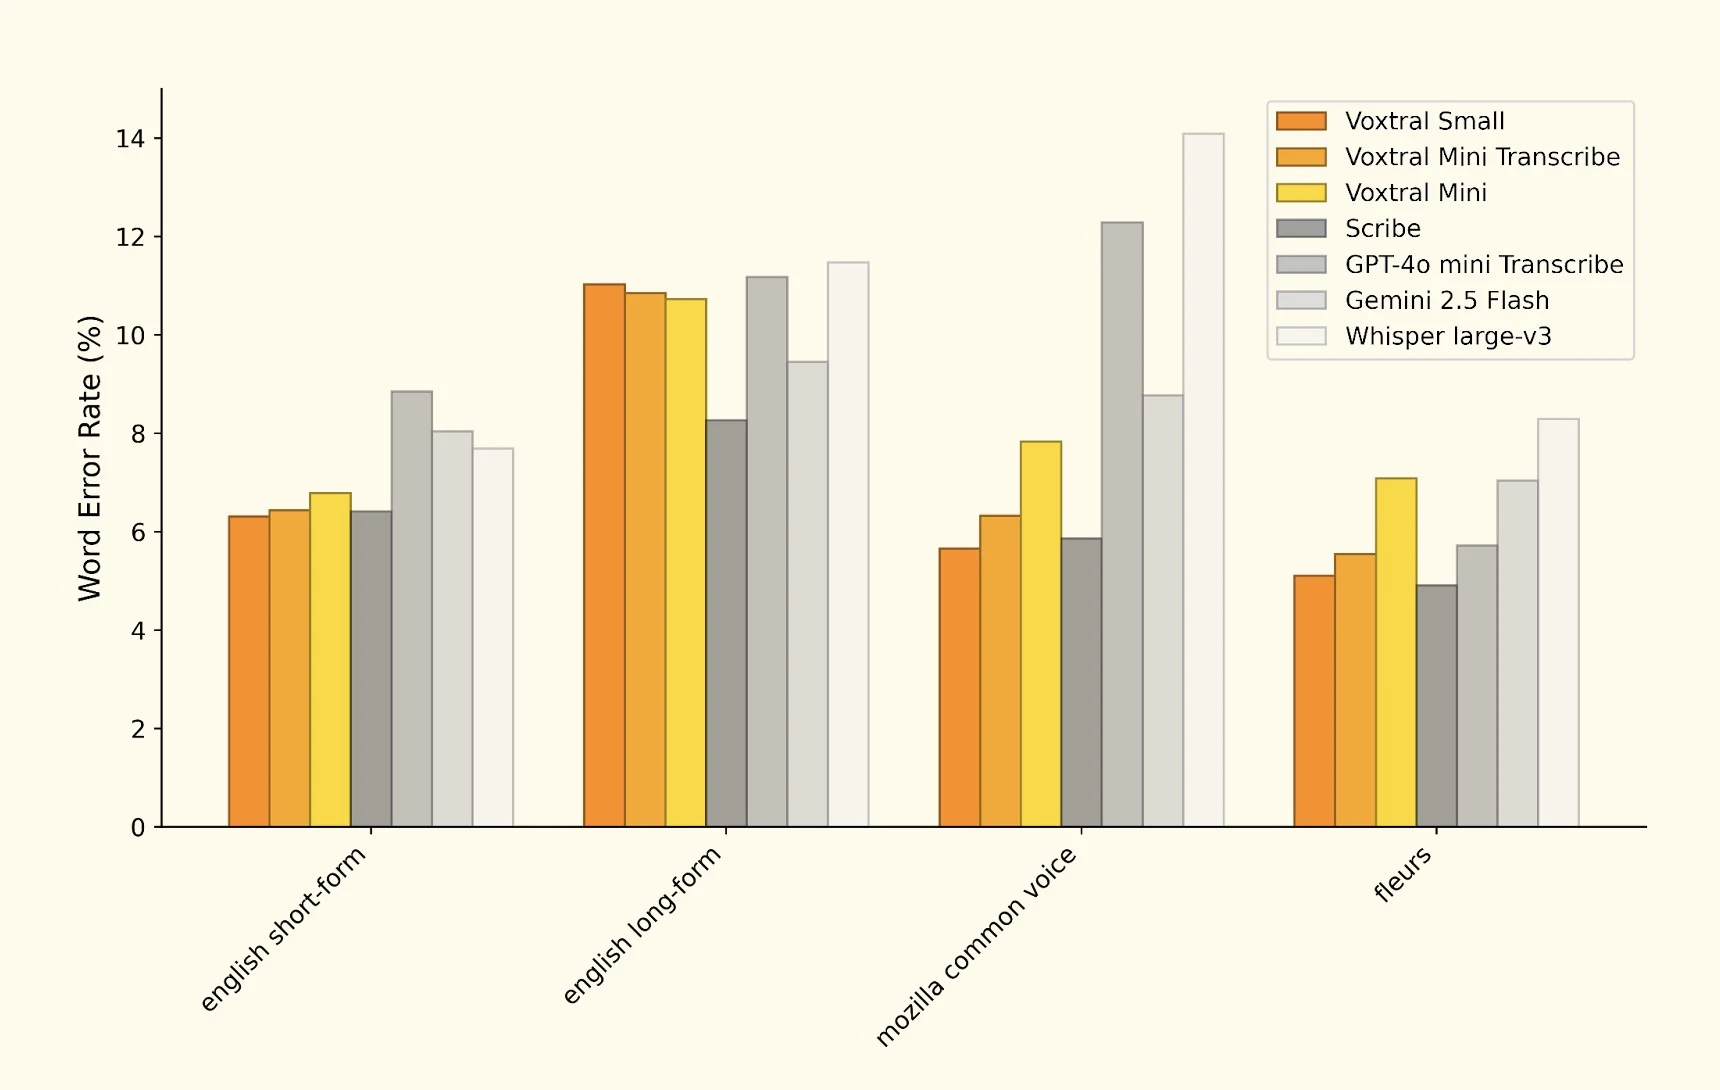
O lançamento da Mistral compara a taxa de erro de palavras (média macro) em conjuntos de inglês de formato curto e longo, Mozilla Common Voice, FLEURS e Multilingual LibriSpeech. Nos resultados de FLEURS divulgados pela Mistral, o Voxtral Small supera o Whisper em todas as tarefas avaliadas. Quanto menor o WER, melhor:
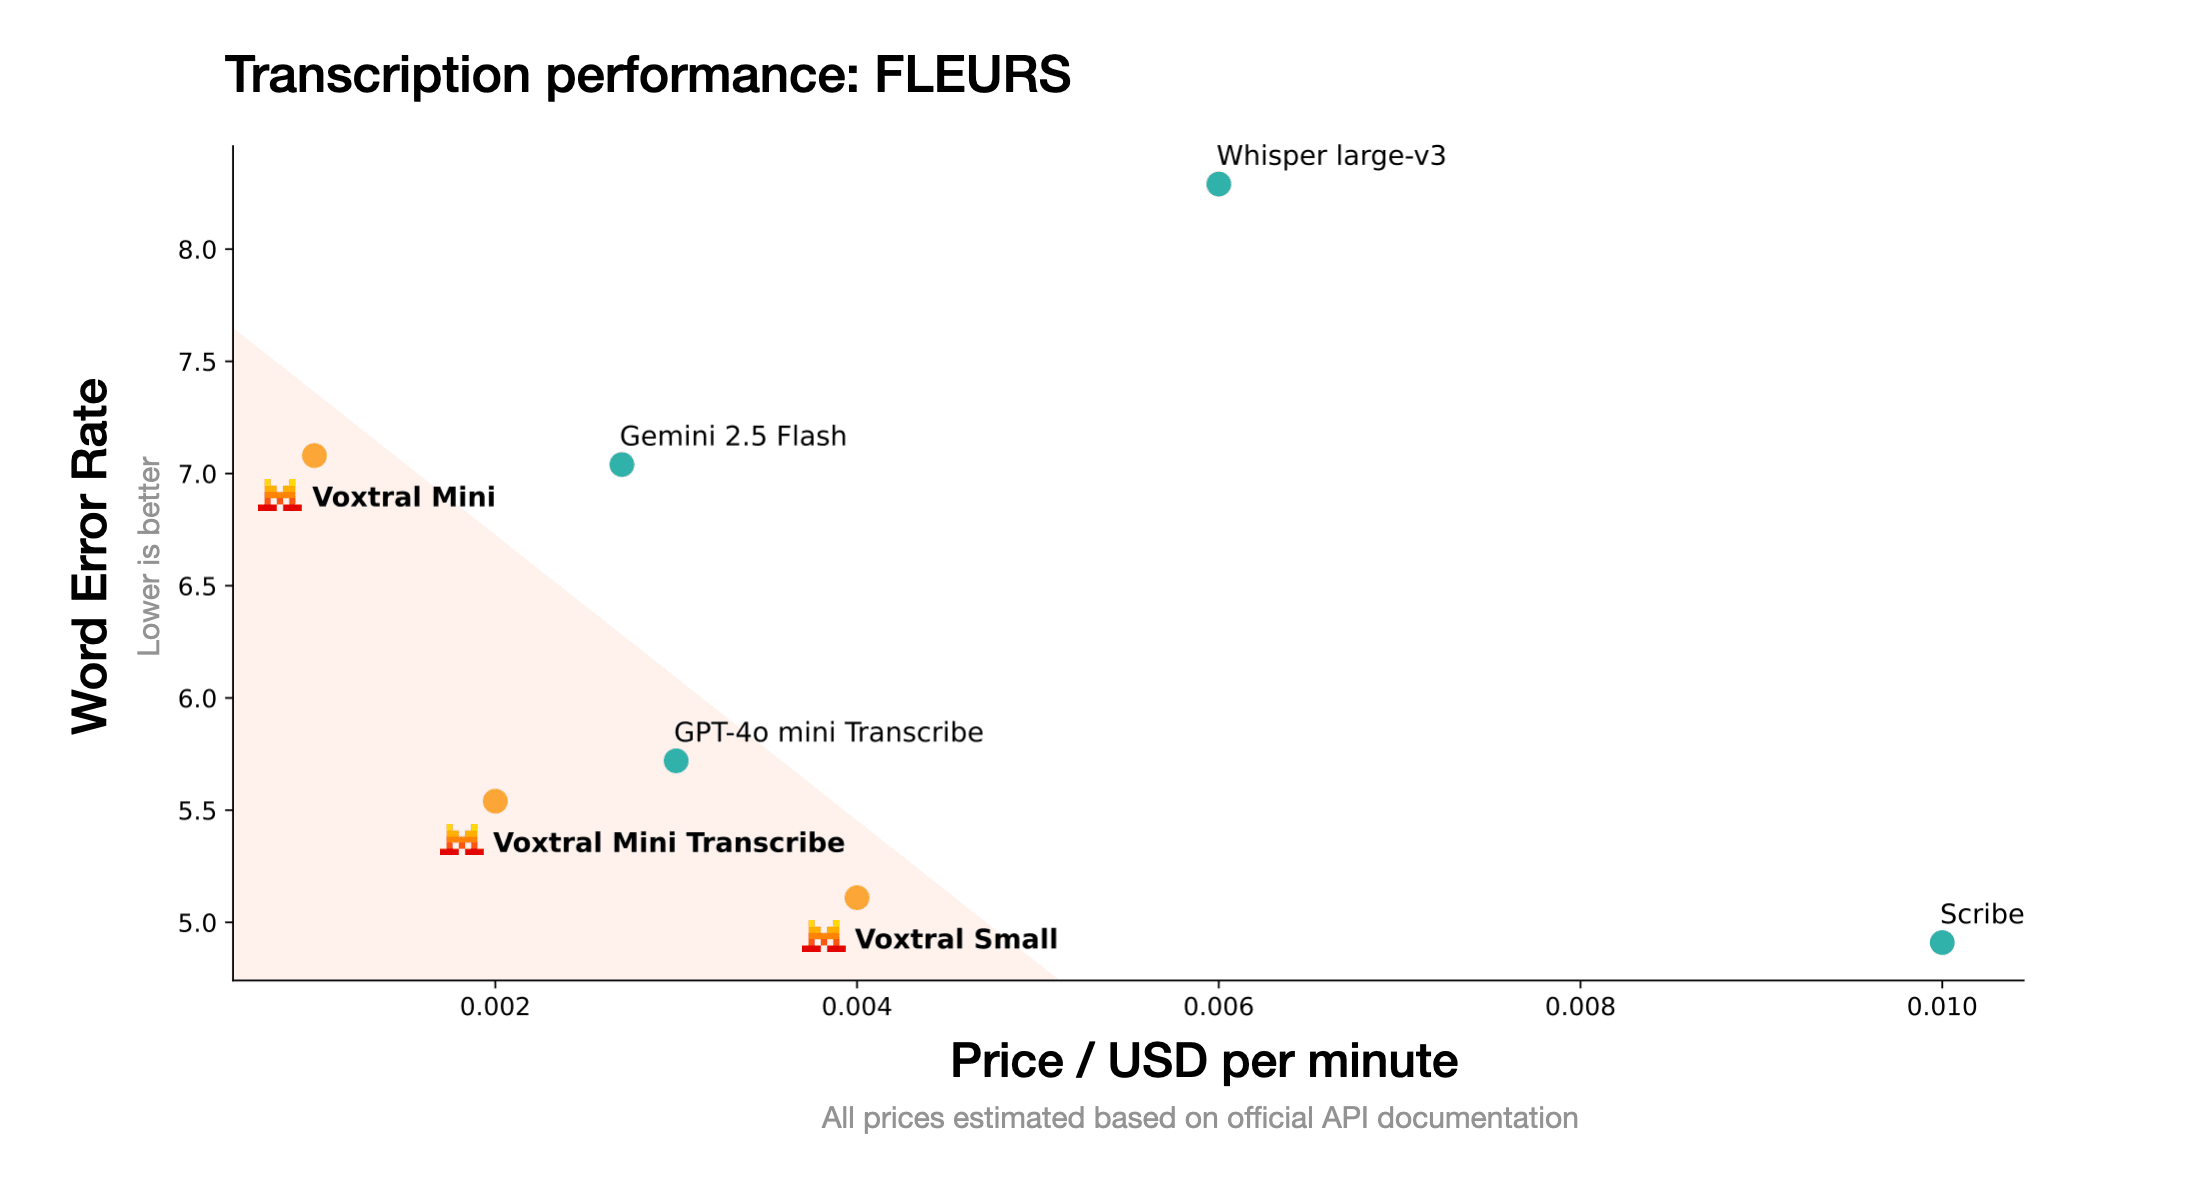
WER no FLEURS dos benchmarks de lançamento da Mistral em relação ao preço estimado da API; tanto os resultados dos benchmarks quanto os preços podem mudar
O FLEURS é só um recorte da qualidade de transcrição. São resultados divulgados pelo próprio fornecedor, então compare as definições publicadas dos benchmarks e teste seus próprios idiomas, microfones e condições de gravação antes de escolher um modelo.
Voxtral vs Whisper: Qual Você Deve Usar?
Os benchmarks contam só uma parte da história. Veja como as duas famílias de modelos se comparam nos fatores que importam se você realmente quiser rodar uma delas:
| Voxtral Small | Voxtral Mini | Whisper Large v3 | Whisper Large-v3 Turbo | |
|---|---|---|---|---|
| Idiomas | 8 idiomas principais | 8 idiomas principais | 100+ | 100+ |
| Código aberto | Sim | Sim | Sim | Sim |
| Tamanho do modelo | 24 bilhões de parâmetros; ~55 GB de RAM de GPU em bf16/fp16 | 3 bilhões de parâmetros; ~9,5 GB de RAM de GPU em bf16/fp16 | 1,55 bilhão de parâmetros | 809 milhões de parâmetros (~1,6 GB) |
| Prático em um Mac de consumo | Não em precisão total em hardware típico | Possível com um runtime compatível; mais pesado que o Turbo | Sim | Sim |
O veredito: o Voxtral Small divulga resultados de WER fortes e adiciona uma compreensão de áudio que o Whisper nem tenta. O Voxtral Mini é o checkpoint que a Mistral posiciona para implantação local e edge, mas seu card oficial ainda lista cerca de 9,5 GB de RAM de GPU em bf16/fp16. Para um aplicativo de transcrição de consumo, o Whisper Large-v3 Turbo continua mais fácil de distribuir e cobre muito mais idiomas. É por isso que o Whisper Notes atualmente combina o Whisper Turbo com o Parakeet V3 e o SenseVoice, em vez do Voxtral.
Custo de API e de Auto-Hospedagem
Conforme verificado em 10 de julho de 2026, o card do modelo da Mistral lista a entrada de áudio do Voxtral Small a $0.004 por minuto. A entrada de texto e o texto gerado são cobrados separadamente nas solicitações de compreensão de áudio. Se você hospedar os pesos Apache 2.0 por conta própria, não há cobrança de API da Mistral, mas você paga pelo hardware e pela operação.
API da Mistral
Pesos auto-hospedados
Como Funciona
O card oficial do modelo descreve o Voxtral como um backbone de modelo de linguagem com um codificador de áudio e um modo de transcrição dedicado. Os limites importantes do produto são concretos:
1. Arquitetura Multimodal
O Voxtral aceita áudio e texto na mesma conversa, em vez de atuar apenas como um decodificador de fala para texto:
- •Modo dedicado para transcrição direta
- •Perguntas e respostas sobre áudio e sumarização estruturada
- •Múltiplas entradas de áudio e conversas de áudio com vários turnos
Limite de formato longo
A janela de contexto de 32k suporta até 30 minutos de áudio para transcrição ou 40 minutos para compreensão de áudio mais ampla.
2. Idiomas e Avaliação
A Mistral lista oito idiomas principais com detecção automática:
- •Inglês, espanhol, francês, português, hindi, alemão, holandês e italiano
- •Os benchmarks incluem FLEURS, Mozilla Common Voice e Multilingual LibriSpeech
- •O lançamento também avalia separadamente áudio em inglês de formato curto e de formato longo
3. Requisitos de Implantação
Pesos abertos não significam que todo checkpoint seja pequeno o suficiente para qualquer dispositivo:
- •O Voxtral Small exige cerca de 55 GB de RAM de GPU em bf16/fp16, segundo seu card de modelo
- •O Voxtral Mini é o checkpoint de 3 bilhões de parâmetros destinado à implantação local e edge
- •A Mistral recomenda o vLLM para servir os checkpoints lançados
4. Principais Funcionalidades
Compreensão Contextual
Consegue responder perguntas e produzir resumos diretamente a partir do áudio, dentro do limite de contexto de 32k.
Multilíngue
Detecta e transcreve automaticamente oito idiomas principais: inglês, espanhol, francês, português, hindi, alemão, holandês e italiano.
Tratamento de Ruído
A avaliação oficial inclui conjuntos de dados de fala variados, mas a Mistral não publica uma garantia geral para toda gravação com ruído.
Implantação Edge
O Voxtral Mini é a opção local e edge. Seu card oficial lista cerca de 9,5 GB de RAM de GPU em bf16/fp16.
5. Arquitetura
Três componentes principais:
- 1. Codificador de áudio: converte a forma de onda em representações de áudio aprendidas
- 2. Projetor: mapeia as representações de áudio para o espaço oculto do modelo de linguagem
- 3. Backbone de modelo de linguagem: gera transcrições, respostas, resumos ou chamadas de ferramentas
Esse design explica por que o Voxtral consegue fazer mais do que transcrever, mas também carrega pesos de modelo de linguagem muito maiores do que um modelo focado só em transcrição, como o Whisper Turbo.
Por Que o Whisper Notes Ainda Faz Sentido
O Voxtral e o Whisper Notes resolvem problemas diferentes. O Voxtral combina transcrição com compreensão de áudio; o Whisper Notes foca em transcrição privada, fácil de rodar em hardware Apple de consumo.
O Que o Whisper Notes Oferece
Privacidade
- •Processamento 100% offline
- •Sem transmissão de dados
- •Sem dependências de nuvem
Desempenho
- •Tecnologia Whisper, precisão comprovada
- •Otimizado para Apple Silicon
- •Resultados confiáveis
Custo
- •compra única; preço indicado no canal de compra; o Mac inclui uma avaliação gratuita de 5.000 palavras
- •Sem cobrança por minuto
- •Transcrição ilimitada
Experiência do Usuário
- •Interface simples
- •Atualizações regulares
- •Melhorias contínuas
Requisitos de Armazenamento
O Voxtral Small é um modelo de classe servidor em precisão total: seu card oficial lista cerca de 55 GB de RAM de GPU. O Voxtral Mini foi pensado especificamente para uso local e edge, mas seu card ainda lista cerca de 9,5 GB de RAM de GPU em bf16/fp16. O download do Whisper Turbo no aplicativo fica em torno de 1,6 GB, o que combina melhor com o produto atual do Whisper Notes.
O Whisper Notes usa o Whisper Large-v3 Turbo — ele equilibra desempenho, velocidade e requisitos de VRAM para o uso diário. Vamos migrar para modelos melhores quando eles ficarem disponíveis com requisitos de recursos razoáveis.
O Voxtral é atraente quando perguntas e respostas sobre áudio, sumarização ou implantação em servidor próprio são o que importa. O Whisper Notes é voltado para usuários individuais que querem transcrição privada e sem assinatura recorrente.
O Que Isso Significa
O Voxtral é um passo importante dos pesos abertos para além do simples reconhecimento de fala, porque consegue raciocinar sobre o áudio além de transcrevê-lo.
Para transcrição offline privada no Mac e no iPhone, mecanismos especializados menores continuam mais fáceis de empacotar e de rodar de forma consistente.
Comparando todas as opções locais? Todos os modelos de fala para texto no dispositivo — as variantes do Whisper, o Parakeet V3, o SenseVoice e o Voxtral — estão comparados lado a lado na nossa página de comparação de modelos Whisper.
Perguntas Frequentes
O que é o Mistral Voxtral?
O Voxtral é a família de modelos de pesos abertos da Mistral para transcrição de fala e compreensão de áudio. O lançamento de julho de 2025 inclui o Voxtral Small 24B para cargas de trabalho de classe servidor e o Voxtral Mini 3B para implantação local e edge. Os dois checkpoints usam a licença Apache 2.0.
O Voxtral roda localmente em um Mac?
Os pesos disponíveis para download podem ser auto-hospedados, mas os dois tamanhos têm requisitos diferentes. O Voxtral Small precisa de cerca de 55 GB de RAM de GPU em bf16/fp16, então é uma escolha de classe servidor. O Voxtral Mini é o checkpoint local e edge; seu card de modelo lista cerca de 9,5 GB em bf16/fp16, e a velocidade e o uso real de memória em um Mac dependem do runtime e da quantização.
O Whisper Notes usa o Voxtral?
Não. O Whisper Notes roda o Parakeet V3 (o padrão no Mac), o Whisper Large-v3 Turbo e o SenseVoice — modelos escolhidos por equilibrarem desempenho, velocidade e requisitos de VRAM para o uso diário em Apple Silicon. Vamos adotar modelos melhores assim que eles se tornarem práticos de rodar em hardware de consumo.
Quantos idiomas o Voxtral suporta?
Os cards oficiais dos modelos listam oito idiomas principais com detecção automática: inglês, espanhol, francês, português, hindi, alemão, holandês e italiano. A Mistral também avalia árabe no FLEURS, mas ele não entra na lista de idiomas principais do card do modelo.
Quando o Mistral Voxtral foi lançado?
A Mistral lançou o Voxtral em 15 de julho de 2025. Os checkpoints Apache 2.0 iniciais foram o Voxtral Small 24B e o Voxtral Mini 3B.
 Baixar para iOS