TL;DR — Comparativa de tres models al dispositiu
| Parakeet V3 | SenseVoice Small | Whisper Large V3 Turbo | |
|---|---|---|---|
| 5 min anglès | 2,91s (103×) | 5,8s (52×) | 20,92s (14,3×) |
| 27 min xinès | Sense suport de xinès | 13,83s (118×) | 2 min 4s (13,1×) |
| Llengües | 25 (europees) | 5 (zh, en, ja, ko, yue) | 100+ |
| Descàrrega | 465 MB | 827 MB | ~1,6 GB |
| Ideal per a | Anglès i llengües europees | Xinès, japonès, coreà, cantonès | Tota la resta (100+ llengües) |
* Benchmarks de velocitat en un Apple M4 Pro, 32 GB. Podcast en anglès de 5 minuts i podcast en xinès de 27 minuts. Factor de temps real = durada de l'àudio ÷ temps de processament (més alt = més ràpid). Els benchmarks corresponen a la versió per a Mac; SenseVoice també està disponible a l'iPhone.
A partir de la versió 1.5.0 (Direct Download / DMG), Whisper Notes per a Mac incorpora SenseVoice Small com a motor dedicat per a la transcripció de xinès, japonès, coreà i cantonès. Substitueix Qwen3-ASR i s'executa a la GPU d'Apple mitjançant MLX en lloc de la CPU — processa un podcast xinès de 27 minuts en 13,83 segons en lloc de 3 minuts i 44 segons.
Per què hem substituït Qwen3-ASR
Qwen3-ASR era un model sòlid. Suportava 30 llengües més 22 dialectes xinesos, i la seva precisió per al xinès era propera a l'estat de l'art. Però tenia un problema que empitjorava com més llarg era l'àudio: la velocitat.
Qwen3 utilitzava una arquitectura autoregressiva — el mateix enfocament que Whisper, processant l'àudio fotograma a fotograma, sense saltar mai endavant. En un podcast xinès de 27 minuts trigava 224 segons. Utilitzable, però no l'experiència de resultat instantani que Parakeet V3 ofereix per a l'anglès.
El problema més profund era la nostra infraestructura. La nostra integració de Qwen3 utilitzava sherpa-onnx, una biblioteca en C amb un wrapper de Swift de 2.249 línies que ho dirigia tot a través dels nuclis de la CPU. La GPU restava ociosa mentre la CPU del teu Mac feia tota la feina.
SenseVoice va resoldre tots dos problemes. Arquitectura no autoregressiva per a la velocitat. Apple MLX per a l'acceleració per GPU. El resultat: una millora de velocitat de 16,2× amb el mateix maquinari, amb una base de codi reduïda de 2.249 línies a 288.
El benchmark
Els tres models executant-se al mateix Apple M4 Pro, els mateixos fitxers d'àudio, les mateixes condicions. Sense núvol. Sense internet. Només silici.
| Model | 5 min anglès | 27 min xinès | Velocitat (RTFx) |
|---|---|---|---|
| Parakeet V3 | 2,91s | Sense suport de xinès | 103× |
| SenseVoice Small | 5,8s | 13,83s | 52–118× |
| Whisper Large V3 Turbo | 20,92s | 2 min 4s | 13–14× |
| Qwen3-ASR (eliminat) | — | 224s | 7,2× |
En anglès, SenseVoice va aproximadament a la meitat de la velocitat de Parakeet — i tot i així és extraordinàriament ràpid. En xinès, Parakeet ni tan sols és una opció, i SenseVoice enllesteix un podcast de 27 minuts en menys de 14 segons. Prems transcriure, esperes un alè i el text ja hi és.
Compara-ho amb els 2 minuts i 4 segons de Whisper, o amb els 3 minuts i 44 segons de l'antic Qwen3. L'arquitectura importa més que el nombre de paràmetres.
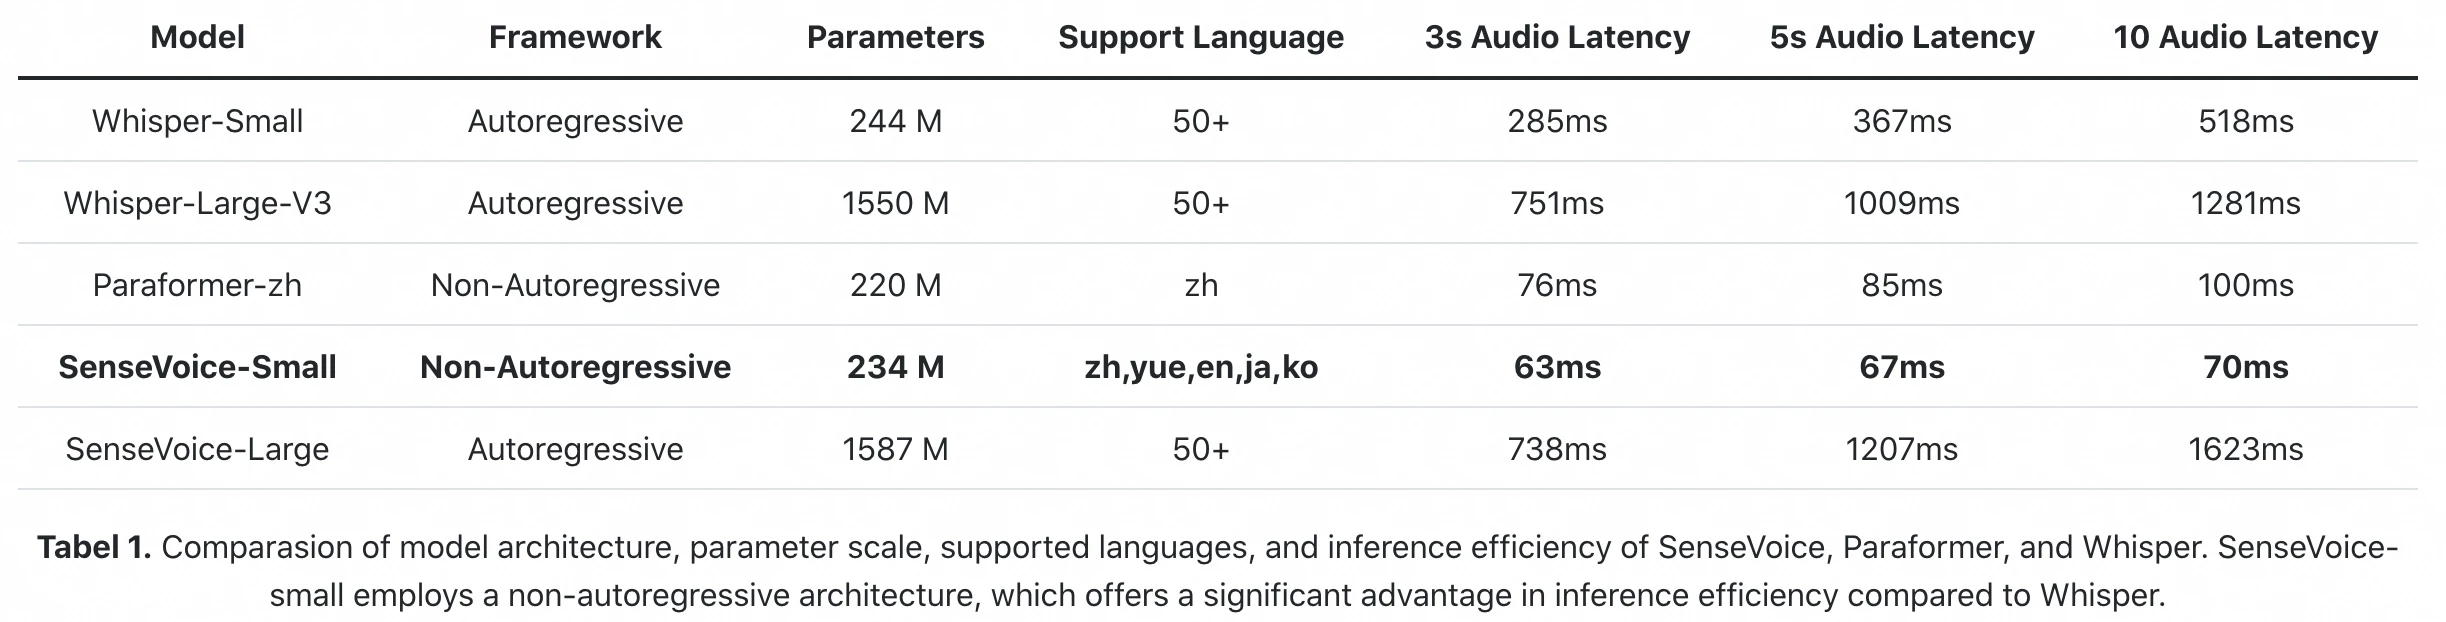
Benchmark oficial d'inferència de l'article FunAudioLLM: SenseVoice-Small processa 10s d'àudio en 70ms (GPU A800). Whisper-Large-V3 triga 1.281ms en el mateix maquinari. Tingues en compte que això és latència d'inferència en una GPU de centre de dades, no les xifres al dispositiu de més amunt.
| Model | Temps de càrrega | Mida de descàrrega |
|---|---|---|
| Parakeet V3 | 0,77s | 465 MB |
| SenseVoice Small | 0,81s | 827 MB |
| Whisper Small | 1,03s | 600 MB |
| Whisper Large V3 Turbo | 3,18s | ~1,6 GB |
* Temps de càrrega mesurat en un Apple M4 Pro, 32 GB.
SenseVoice es carrega en menys d'un segon. En un Mac de 8 GB funciona còmodament al costat de les teves altres aplicacions.
Per què SenseVoice és més ràpid: arquitectura + entorn d'execució
La diferència de velocitat entre Qwen3-ASR i SenseVoice prové de dos factors independents.
Factor 1: Arquitectura del model. Qwen3-ASR és autoregressiu — genera el text token a token, cadascun dependent de l'anterior. SenseVoice utilitza un codificador no autoregressiu (NAR) que processa tot l'àudio en paral·lel. Aquesta diferència arquitectònica per si sola fa que SenseVoice sigui fonamentalment més ràpid, independentment del maquinari on l'executis.
Factor 2: Entorn d'execució. La nostra integració de Qwen3-ASR utilitzava sherpa-onnx, que funcionava a la CPU. SenseVoice s'executa a través d'Apple MLX, dirigint els càlculs a la GPU. Podria Qwen3 executar-se també amb MLX? Sí — però continuaria sent més lent que SenseVoice, perquè el coll d'ampolla autoregressiu és a l'arquitectura, no a l'entorn d'execució.
| Qwen3-ASR (antic) | SenseVoice (nou) | |
|---|---|---|
| Arquitectura | Autoregressiva (token a token) | No autoregressiva (paral·lela) |
| Entorn d'execució | sherpa-onnx (CPU) | Apple MLX (GPU) |
| 27 min xinès | 224 segons | 13,83 segons |
| Acceleració combinada | referència | 16,2× més ràpid |
| Base de codi | Framework C de 168 MB + 2.249 línies de Swift | 288 línies de Swift Actor |
* Mateix podcast xinès de 27 minuts, Apple M4 Pro. L'acceleració de 16,2× combina millores tant arquitectòniques (NAR vs AR) com d'entorn d'execució (GPU vs CPU).
El codi també es va simplificar. La nova implementació de SenseVoice és un únic Swift Actor de 288 línies que es comunica directament amb MLX, substituint un framework C de 168 MB. Menys codi, menys errors, una app més petita.
Cinc llengües, ben fetes
SenseVoice no intenta fer-ho tot. Gestiona cinc llengües:
| Llengua | SenseVoice-Small | Whisper-Large-V3 | Guanyador |
|---|---|---|---|
| Xinès (zh-CN) | 10,78% CER | 12,55% CER | SenseVoice (-14%) |
| Cantonès (yue) | 7,09% CER | 10,41% CER | SenseVoice (-32%) |
| Japonès (ja) | 11,96% CER | 10,34% CER | Whisper (per poc) |
| Coreà (ko) | 8,28% CER | 5,59% CER | Whisper |
| Anglès (en) | 14,71% WER | 9,39% WER | Whisper (fes servir Parakeet) |
* Benchmark CommonVoice, CER = taxa d'error per caràcter, WER = taxa d'error per paraula. Com més baix, millor. Font: article FunAudioLLM (2024). Latència d'inferència de SenseVoice-Small: 70ms per cada 10s d'àudio en una GPU A800, davant dels 1.281ms de Whisper-Large-V3 en el mateix maquinari.
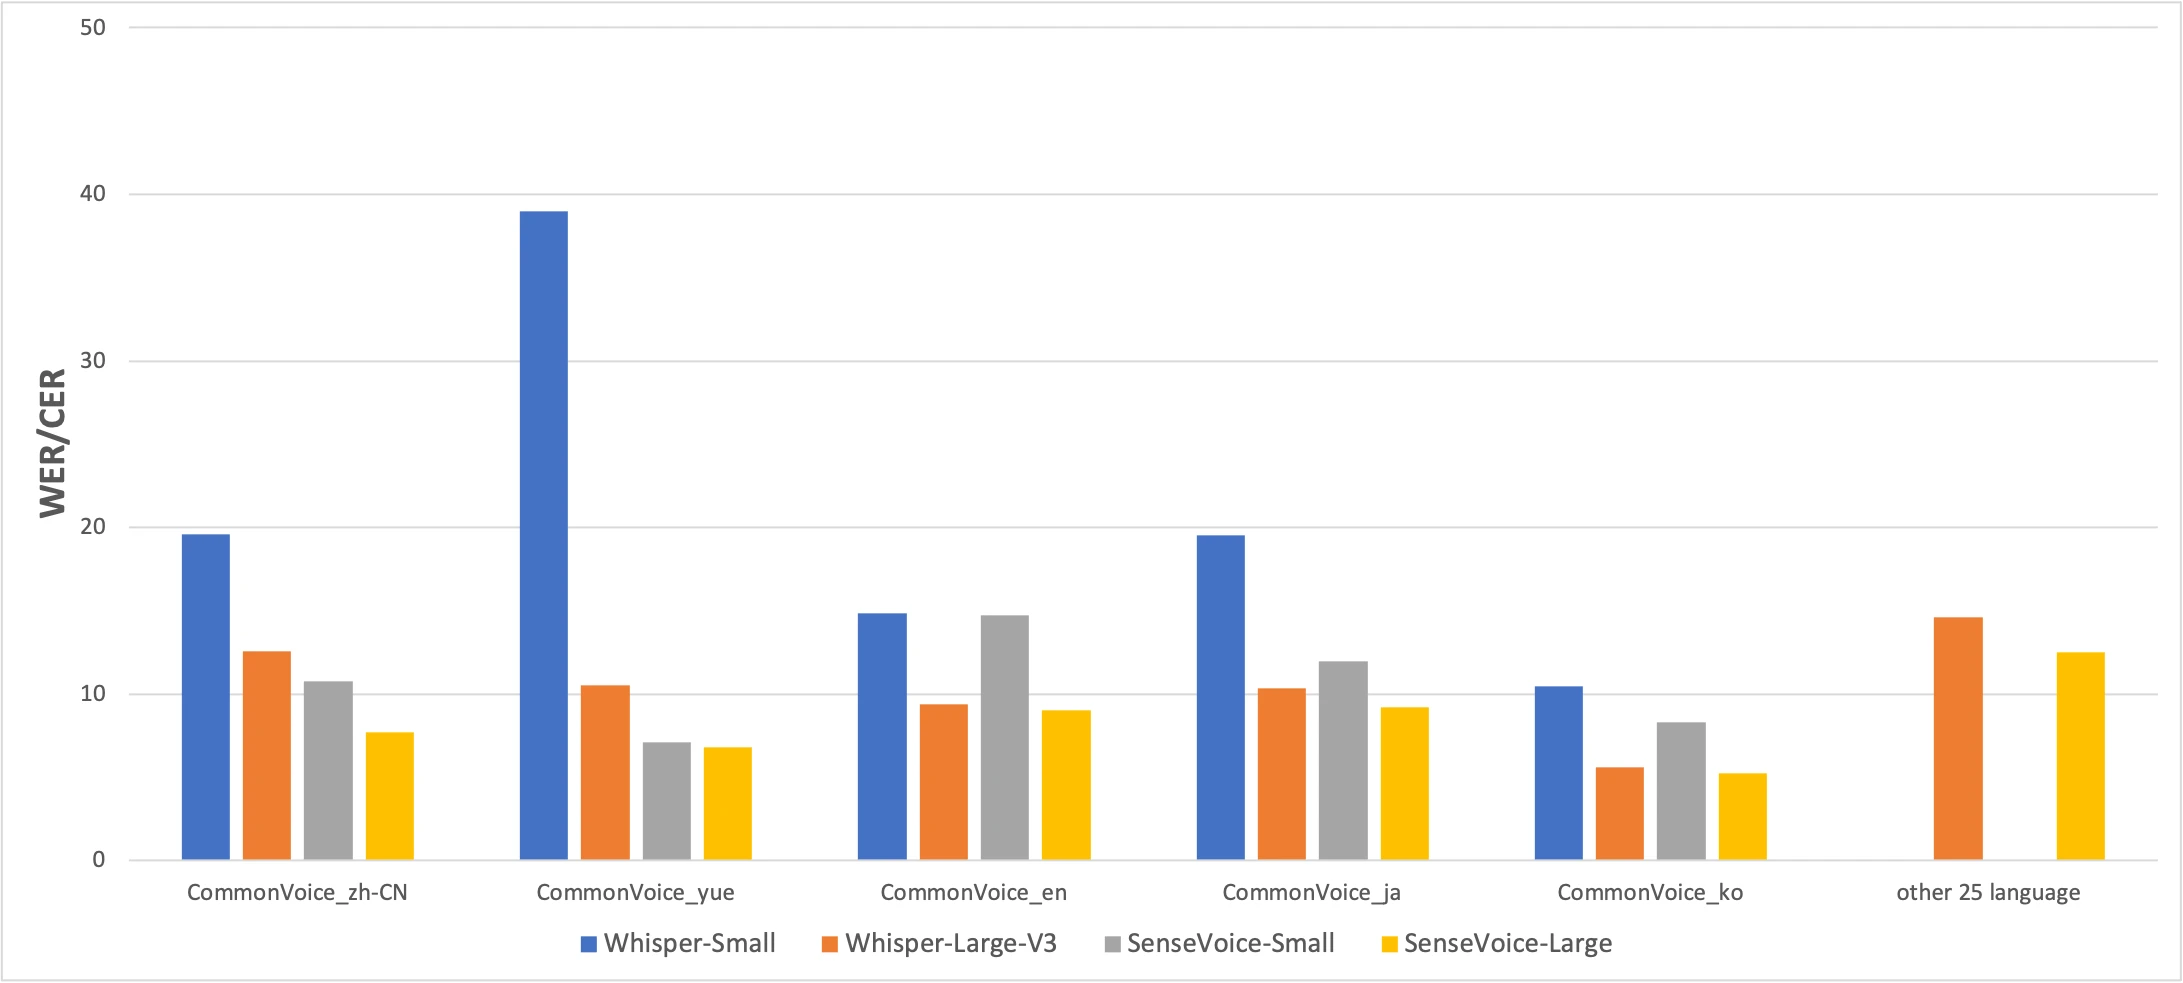
Benchmark CommonVoice: SenseVoice-Small (groc) vs Whisper-Small (blau) vs Whisper-Large-V3 (taronja). Com més baix, millor. Font: article FunAudioLLM
Els números expliquen una història honesta. SenseVoice supera Whisper en precisió per al xinès i el cantonès amb un marge significatiu, mentre que Whisper és més precís per al japonès, el coreà i l'anglès. Però SenseVoice funciona a 52× el temps real o més en Apple Silicon. Per a la majoria d'usos reals, la diferència de velocitat importa més que uns quants punts percentuals de precisió.
El resultat del cantonès mereix ser destacat a part. Whisper-Small obté un 38,97% de CER en cantonès — gairebé inutilitzable. Fins i tot Whisper-Large-V3 només arriba al 10,41%. SenseVoice assoleix el 7,09%. Abans de SenseVoice no hi havia cap bona manera de transcriure cantonès localment en un Mac. Si parles cantonès, aquest model existeix per a tu.
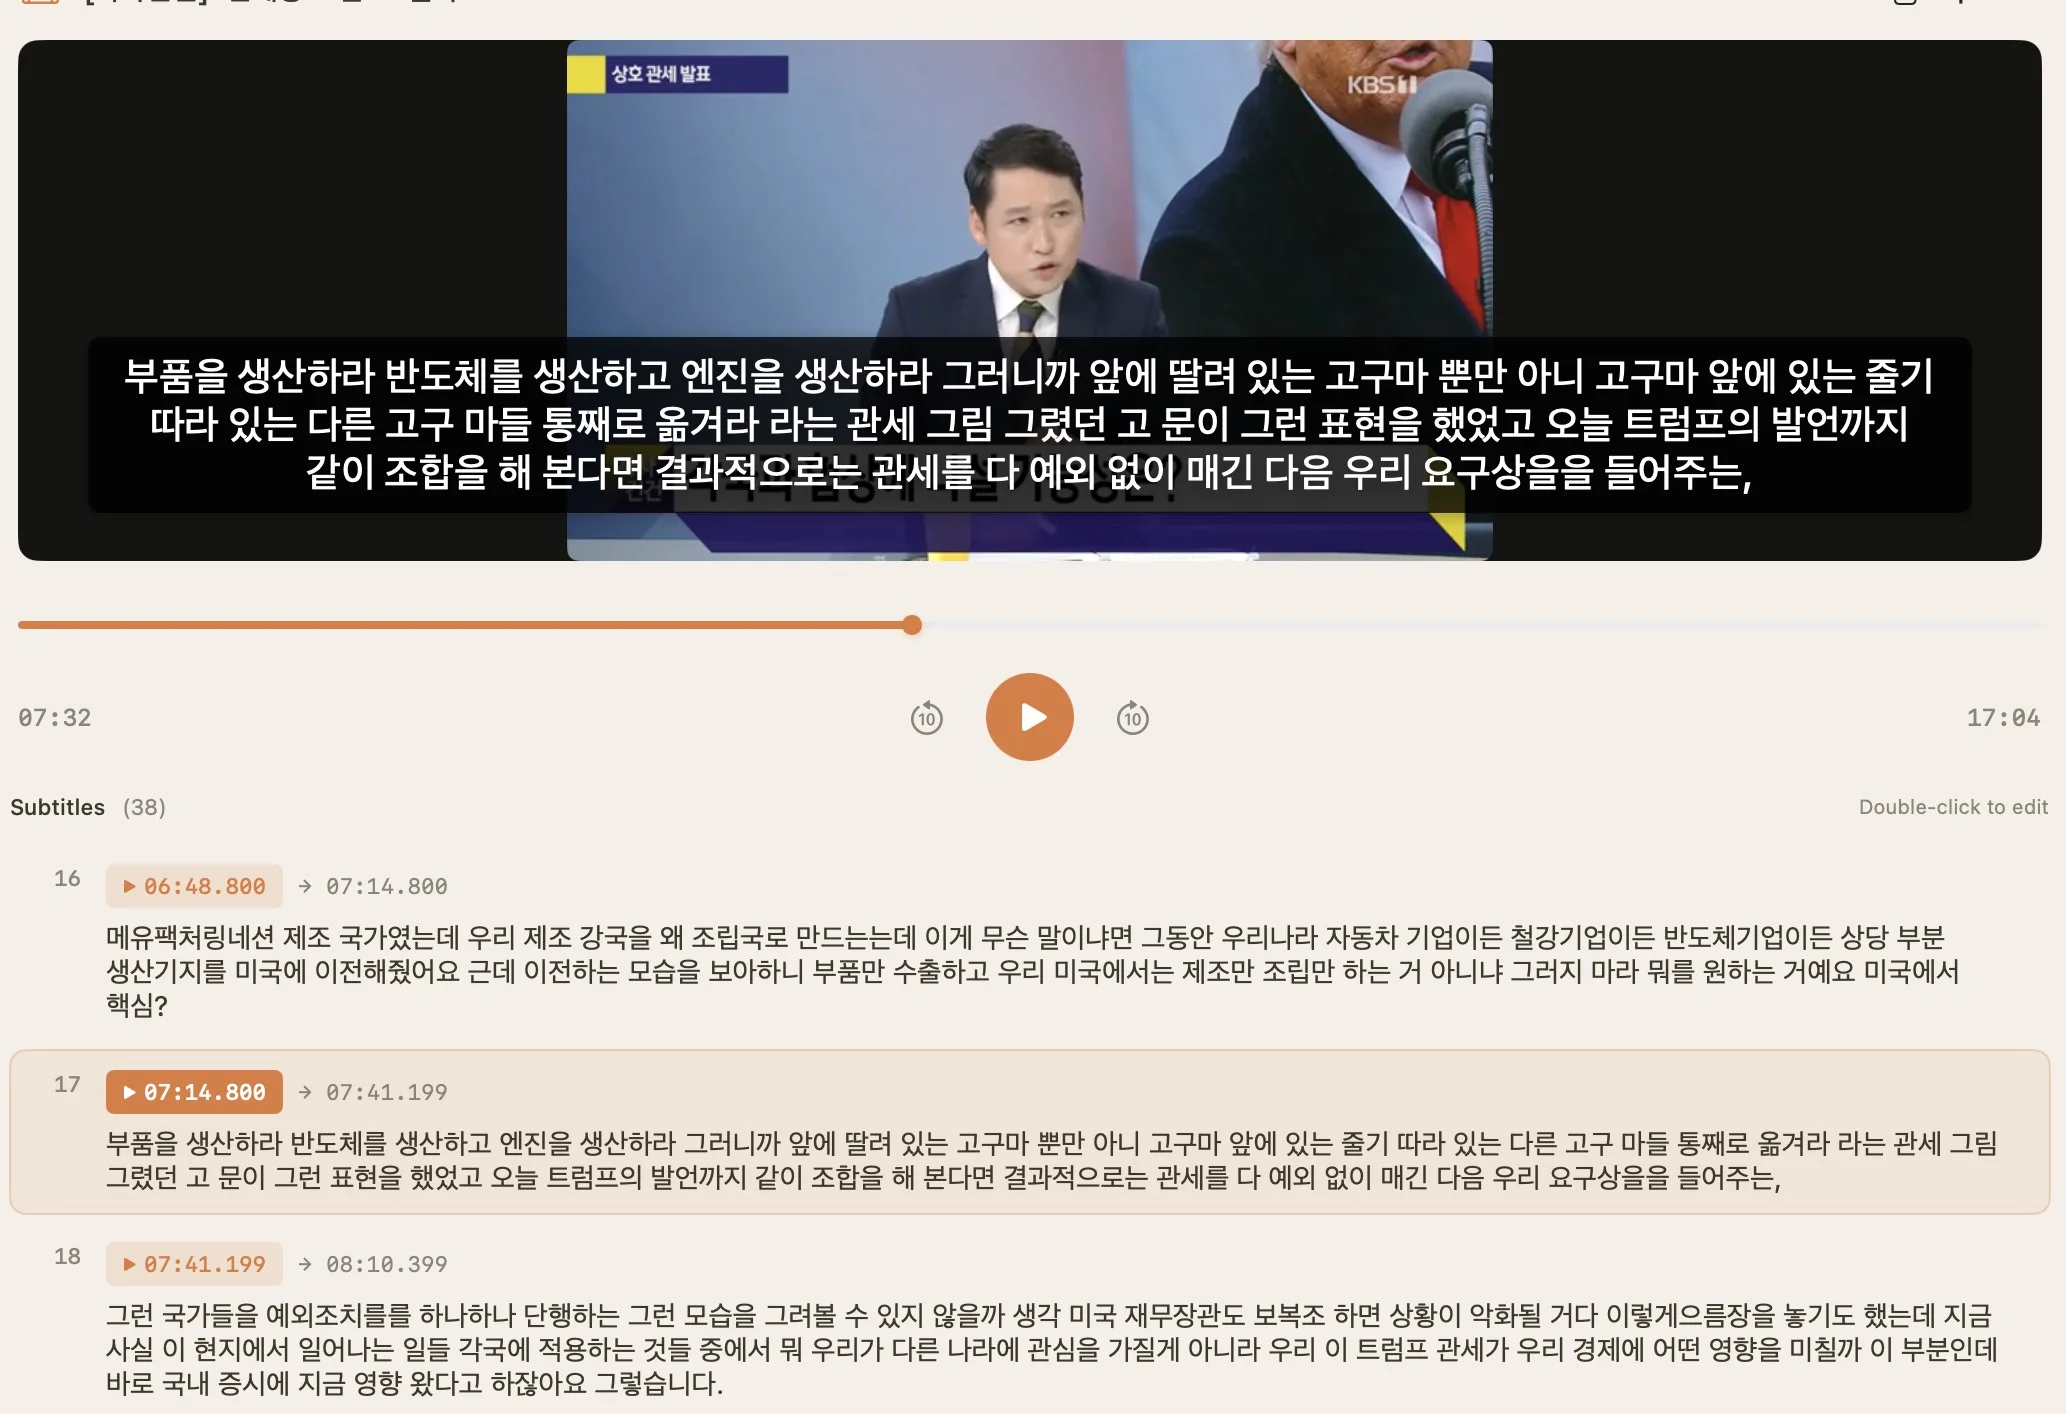
Transcripció de coreà amb SenseVoice: importació de vídeo amb subtítols amb marques de temps
Prova al món real: podcast xinès de 27 minuts
Vam transcriure un episodi de 27 minuts de Thirteen Invitations (十三邀), un podcast d'entrevistes xinès, amb SenseVoice i Whisper Large V3 Turbo al mateix M4 Pro. ElevenLabs Scribe (núvol) va servir de referència. Tots dos models al dispositiu cometen aproximadament el mateix nombre d'errors, però de tipus diferents:
| SenseVoice | Whisper Large V3 | |
|---|---|---|
| Temps | 13,83s | 2 min 4s |
| Errors (mostra de 5 min) | ~15–20 | ~12–15 |
| Pitjor error | 时差→食堂 (zona horària→menjador) | 西昌→西藏 (ciutat de Xichang→Tibet, 4.000 km de diferència) |
| Patró d'errors | Intercanvis d'homòfons | Errors geogràfics/factuals |
* Comparació manual contra ElevenLabs Scribe (referència al núvol, també imperfecta). Tots dos models al dispositiu van escriure correctament «根深蒂固» allà on Scribe es va equivocar.
Precisió comparable, i la transcripció hi és en 13,83 segons en lloc de dos minuts. Per a la transcripció de xinès al món real, SenseVoice et dona una transcripció utilitzable abans que Whisper acabi de carregar-se.
Quan utilitzar cada model
Whisper Notes per a Mac ara inclou quatre models de veu en totes dues versions per a Mac, i la descàrrega directa (DMG) n'afegeix un cinquè a partir de la versió 1.6.0: Qwen3-ASR 1.7B (Beta). Cadascun dels quatre de sota està optimitzat per a un escenari diferent:
| Necessites... | Utilitza aquest model | Per què |
|---|---|---|
| Anglès o llengües europees, velocitat màxima | Parakeet V3 | 103× el temps real, la taxa d'error més baixa. El model per defecte. |
| Xinès, japonès, coreà o cantonès | SenseVoice Small | 52–118× el temps real. L'únic model amb suport per a cantonès a l'iPhone i a la versió del Mac App Store. |
| Qualsevol de les 100+ llengües (àrab, tailandès, rus, etc.) | Whisper Large V3 Turbo | El suport de llengües més ampli. Més lent però universal. |
| Els 101 idiomes en un Mac antic | Whisper Small | 600 MB, el més lleuger dels models Whisper, i tot i així arriba a 101 idiomes. |
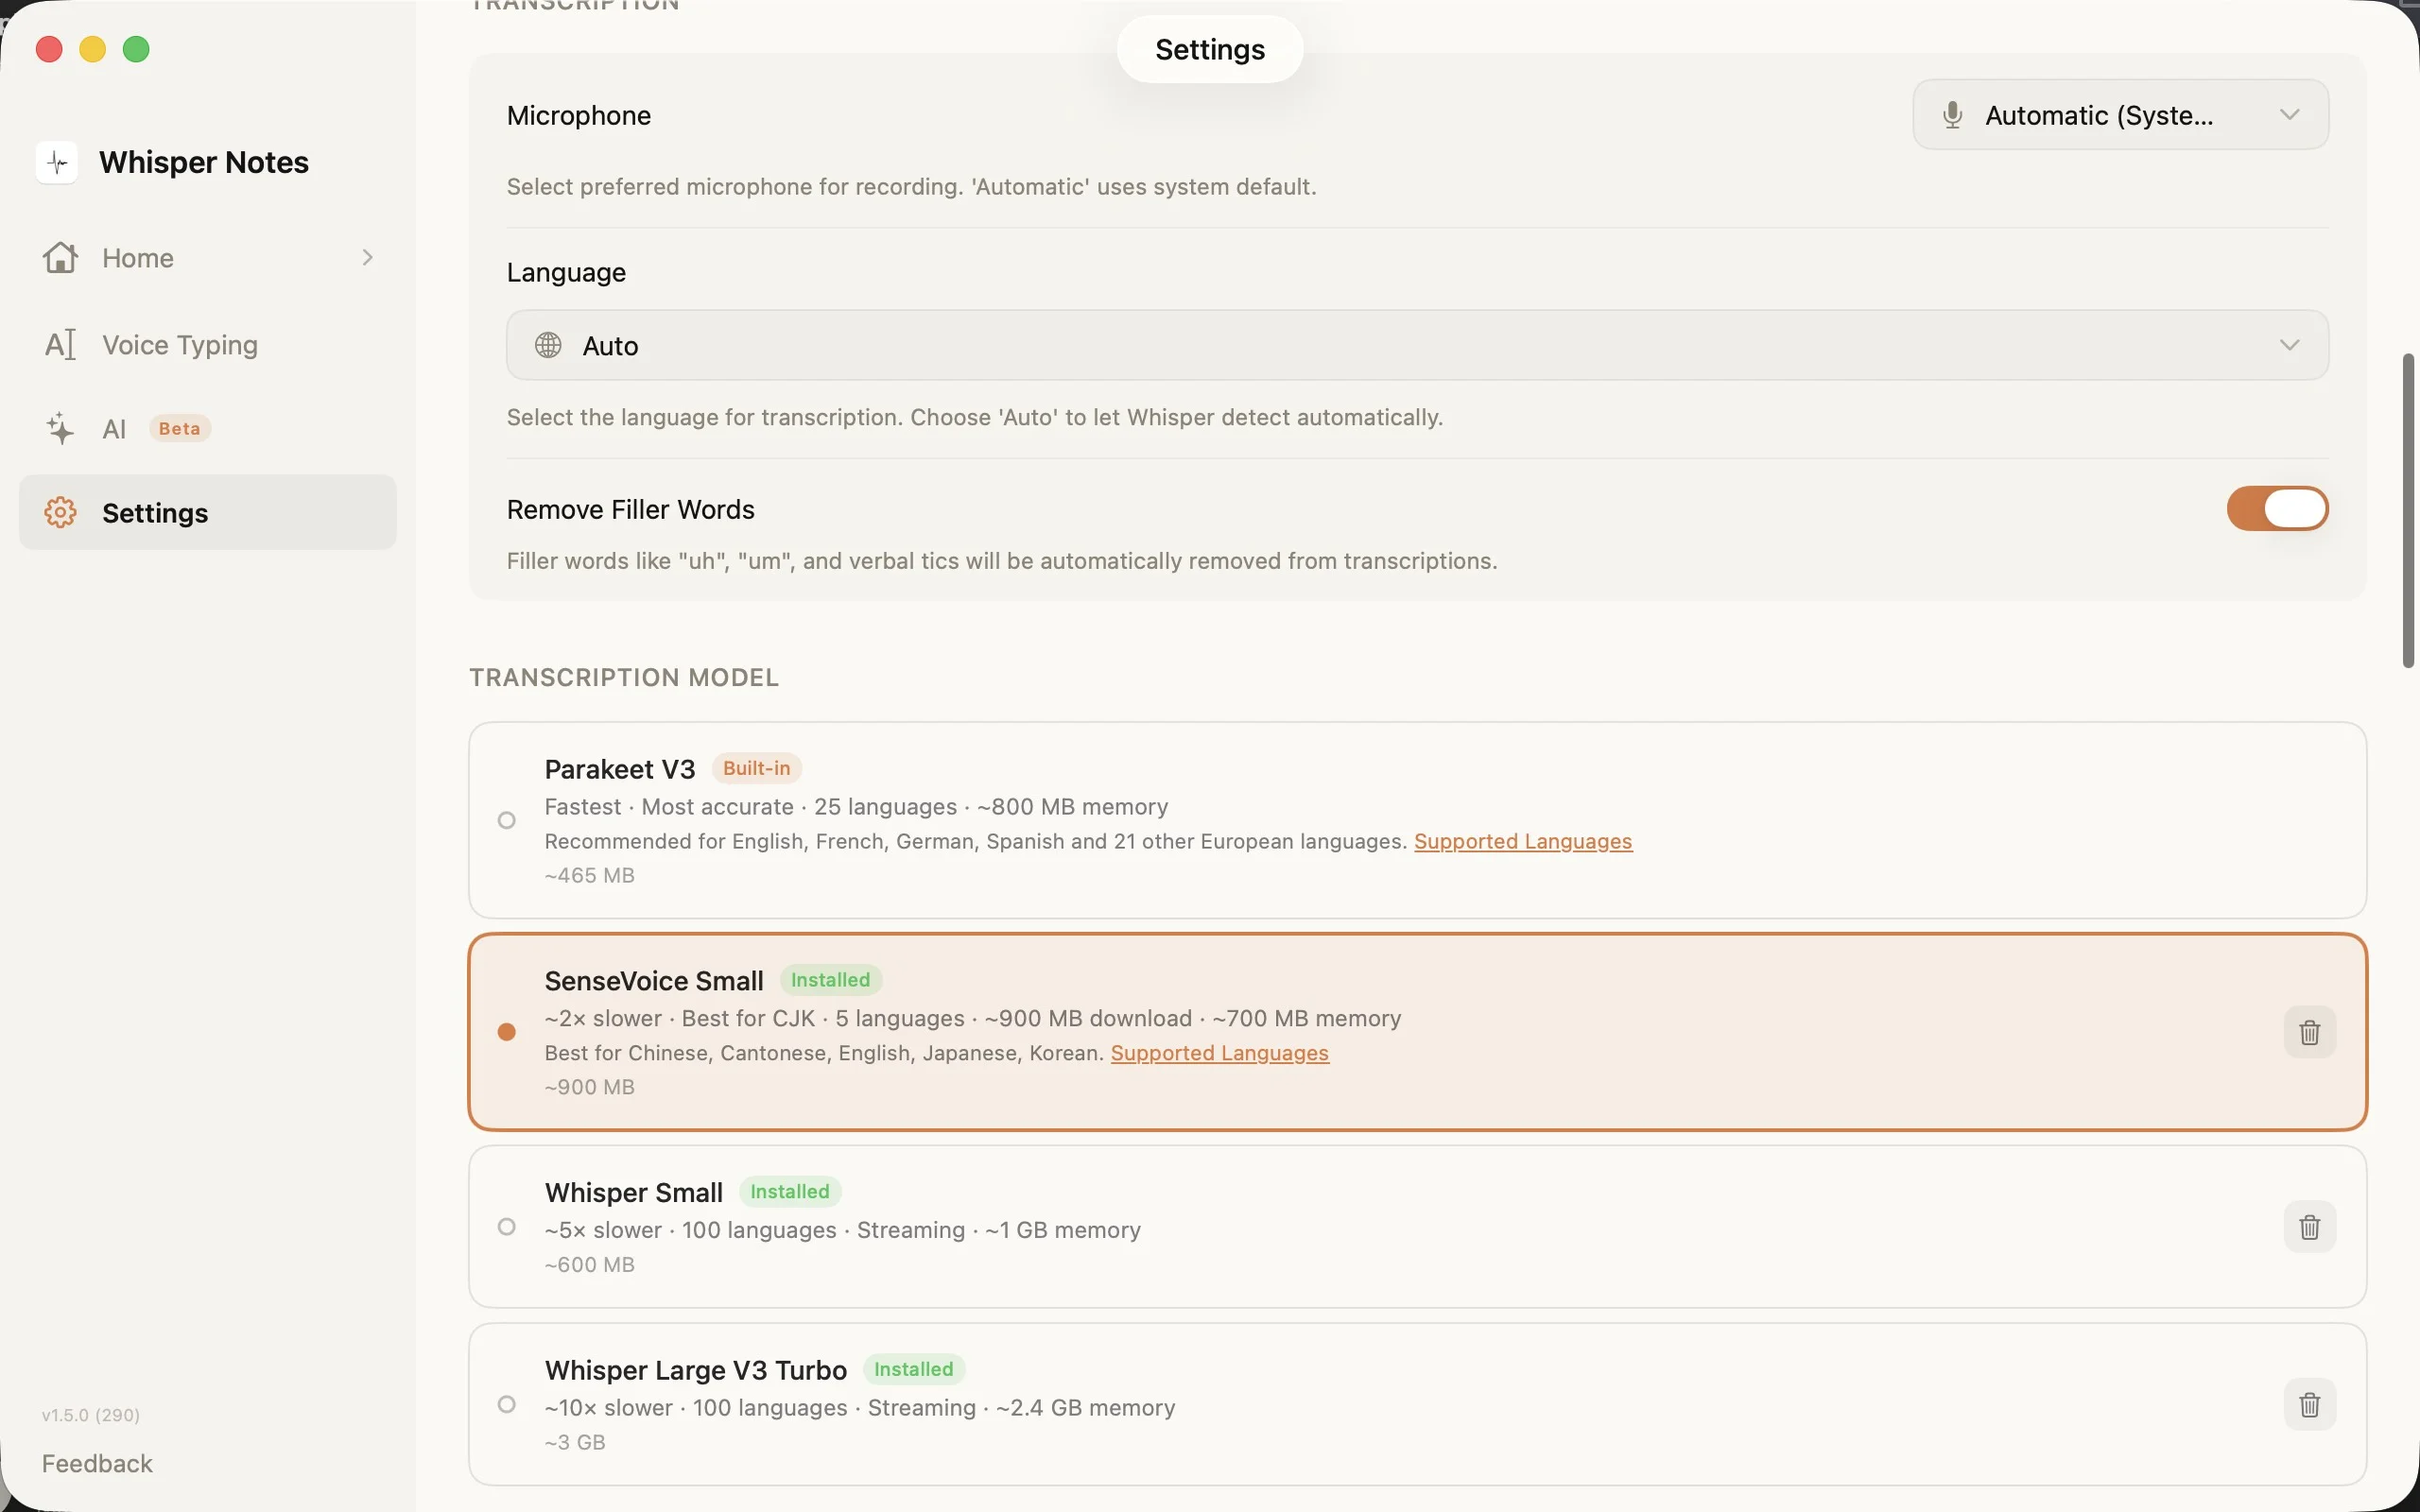
Configuració → Model de transcripció: tria el motor adequat per a la teva llengua
El selector de models a Configuració mostra tots els models que ofereix la teva versió, amb mides de descàrrega, nombre de llengües i requisits de memòria. SenseVoice es descarrega al primer ús (~827 MB) i es queda al teu dispositiu.
Les contrapartides
SenseVoice no és un model universal. Això és el que no pot fer:
• Només 5 llengües. Si necessites tailandès, rus, àrab, hindi o qualsevol altra llengua fora del focus CJK de SenseVoice, queda't amb Whisper.
• Actualització: SenseVoice es va llançar inicialment només per a Mac mitjançant Apple MLX, però ara també està disponible a l'iPhone — iOS suporta la mateixa gamma de models que el Mac: Parakeet V3, Whisper i SenseVoice.
• Peculiaritat amb àudio fluix. En segments molt curts o molt fluixos, SenseVoice de vegades pot recaure en sortida en xinès independentment de la llengua seleccionada. Establir la llengua manualment (en lloc d'«Auto») ho redueix.
• Sense streaming. A diferència del mode de streaming de Whisper, SenseVoice processa l'àudio complet després de la gravació. Amb fitxers llargs, segmenta automàticament als punts de silenci i mostra els resultats de manera progressiva.
Són restriccions arquitectòniques, no errors. Un model entrenat en 5 llengües fa aquestes 5 llengües extremadament bé. La cobertura de més de 100 llengües de Whisper té el preu d'una velocitat més lenta i una precisió desigual entre llengües.
Vols comparar totes les opcions locals? Tots els models de veu a text al dispositiu — les variants de Whisper, Parakeet V3, SenseVoice i Voxtral — es comparen costat per costat a la nostra pàgina de comparació de models Whisper. Encara no coneixes Whisper? Comença per la guia de transcripció amb Whisper — què és el model, totes les maneres d'executar-lo i quant costa.
Preguntes freqüents
Quina és l'alternativa a Whisper més ràpida per transcriure xinès, japonès i coreà?
SenseVoice Small està disponible a Whisper Notes tant al Mac com a l'iPhone. En el nostre test al Mac amb un M4 Pro, va transcriure un podcast xinès de 27 minuts en 13,83 segons (52–118× el temps real), mentre que Whisper Large V3 Turbo va trigar més de 2 minuts amb el mateix fitxer.
SenseVoice és millor que Whisper per al xinès?
Per al xinès i el cantonès, sí. Al benchmark CommonVoice, SenseVoice obté un CER del 10,78% en xinès contra el 12,55% de Whisper-Large-V3, i al nostre M4 Pro va processar un podcast de 27 minuts en 13,83 segons davant dels 2 minuts i 4 segons de Whisper. Whisper continua sent lleugerament més precís per al japonès i el coreà, així que si aquestes són les teves llengües principals, qualsevol dels dos motors és una tria raonable.
Puc transcriure cantonès localment en un Mac?
Sí. SenseVoice obté un CER del 7,09% en cantonès, davant del 10,41% de Whisper-Large-V3 i del 38,97%, gairebé inutilitzable, de Whisper-Small. Abans de SenseVoice no hi havia cap bona manera de transcriure cantonès localment en un Mac.
SenseVoice funciona a l'iPhone?
Sí. Whisper Notes a l'iPhone suporta la mateixa gamma de models que el Mac — Parakeet V3, Whisper i SenseVoice — així que també pots transcriure xinès, japonès, coreà i cantonès localment al teu iPhone.
Prova'l
SenseVoice està disponible a Whisper Notes per a Mac a partir de la v1.5.0 (Direct Download / DMG) i a l'app actual per a iPhone. Al Mac, descarrega'l des de Configuració → Model de transcripció → SenseVoice Small (~827 MB). La versió per a Mac requereix Apple Silicon (M1 o posterior).
Si fas servir Parakeet V3 i dictes principalment en anglès, no cal que canviïs. SenseVoice és per a quan necessites xinès, japonès, coreà o cantonès — i el vols ràpid.
 Descarrega per a Mac
Registre de canvis complet: whispernotes.app/changelog
Preguntes o comentaris: mac@whispernotes.app