Sejak macOS 26 dan iOS 26, Apple telah menyediakan generasi baru pengenalan ucapan di perangkat — SpeechAnalyzer dan SpeechTranscriber, yang selanjutnya disebut Apple Speech. Sistem ini jauh lebih akurat daripada mesin dikte lama. Kami ingin mengetahui perbandingannya dalam penggunaan nyata dengan model terbuka di perangkat yang diunduh orang — Whisper, Parakeet, Qwen3-ASR, dan SenseVoice: apakah pengenalan ucapan bawaan Apple kini cukup bagus sehingga Anda bisa sepenuhnya melewatkan aplikasi transkripsi?
Seberapa jauh peningkatannya dibandingkan dikte yang sudah Anda miliki?
Hingga kini, pengenalan ucapan di Mac menggunakan mesin dari era SFSpeechRecognizer, mesin yang masih digunakan oleh dikte sistem saat ini (DictationTranscriber). macOS 26 dan iOS 26 menambahkan API SpeechAnalyzer beserta modul SpeechTranscriber. Kami telah menjalankan keduanya pada bagian uji FLEURS, sekitar 150 kalimat dan 30 menit per bahasa, di Mac yang sama.
| Bahasa | Apple Dictation | Apple Speech |
|---|---|---|
| Korea | 7,11 | 4,31 |
| Italia | 6,93 | 4,39 |
| Spanyol (Amerika Latin) | 8,43 | 5,41 |
| Jerman | 12,69 | 6,26 |
| Jepang | 9,37 | 6,36 |
| Prancis | 17,10 | 7,61 |
| Mandarin | 10,28 | 7,97 |
| Kanton | 10,18 | 8,69 |
| Inggris | 13,83 | 8,80 |
| Portugis (Brasil) | 10,85 | 9,35 |
Semua bahasa yang telah diukur dengan baik oleh kedua mesin Apple, diurutkan menurut tingkat kesalahan Apple Speech; hijau menandai nilai yang lebih baik pada baris tersebut. Pengujian yang sama, klip yang sama, Mac yang sama. CER untuk bahasa Jepang, Korea, Mandarin, dan Kanton, WER untuk bahasa lainnya.
Apple Speech lebih akurat pada kesepuluh bahasa yang diukur dengan baik oleh kedua mesin. Bahasa Prancis dan Jerman kehilangan lebih dari separuh kesalahannya, bahasa median sekitar sepertiga, serta Portugis Brasil dan Kanton sekitar satu dari setiap tujuh kesalahan.
Dikte masih menjangkau lebih banyak bahasa. Dalam pengujian ini, Apple Speech telah memberikan hasil untuk 21 dari 83 konfigurasi bahasa, sedangkan dikte untuk 33, termasuk tiga bahasa yang tidak dimiliki mesin baru di sini: bahasa Belanda, Polandia, dan Rusia, pada 17,34, 13,50, dan 13,13. Tidak ada pula daftar tetap yang dapat dikutip. Aset bahasa dimiliki macOS, sehingga aplikasi menanyakan saat dijalankan apa yang tersedia pada mesin tertentu.
Jadi, bisakah Anda melewatkan model yang diunduh?
Enam mesin, klip yang sama, satu Mac. Kesepuluh bahasa di bawah termasuk bahasa yang paling banyak digunakan, dalam urutan tetap yang tidak terkait dengan skor.
| Bahasa | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Inggris | 8,80 | 4,49 | 5,49 | 7,04 | 6,89 | 8,46 |
| Jerman | 6,26 | 2,85 | 4,05 | 8,67 | 6,26 | — |
| Belanda | — | 7,36 | 5,69 | 16,75 | 8,58 | — |
| Rusia | — | 5,65 | 5,13 | 11,37 | 7,12 | — |
| Polandia | — | 12,59 | 5,45 | 15,81 | 8,30 | — |
| Jepang | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Korea | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Prancis | 7,61 | 4,57 | 5,97 | 13,24 | 5,83 | — |
| Mandarin | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Spanyol (Amerika Latin) | 5,41 | 3,38 | 3,62 | 6,22 | 4,86 | — |
Sepuluh dari bahasa-bahasa yang paling banyak digunakan, satu mesin per kolom. Setiap sel adalah tingkat kesalahan mesin tersebut, makin rendah makin baik; hijau menandai nilai terendah pada baris, putih nilai terendah kedua. CER untuk bahasa Jepang, Korea, dan Mandarin, WER untuk sisanya; keduanya tidak pernah digabungkan menjadi satu angka. Pengujian FLEURS oleh tim Whisper Notes, satu M5 MacBook Air, tuturan yang dibacakan.
Nama singkat: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet V3, SenseVoice = SenseVoice Small. Tanda pisah berarti mesin tidak memiliki model untuk bahasa tersebut.
Qwen3-ASR 1.7B telah mencatat tingkat kesalahan terendah pada enam dari sepuluh bahasa, Whisper Large V3 Turbo pada empat bahasa lainnya, dan Apple Speech tidak pada bahasa mana pun. Mesin ini paling dekat pada bahasa Korea, tertinggal 0,77 poin dari pemimpin baris, lalu bahasa Jepang dengan 1,06 dan bahasa Mandarin dengan 1,48, tempat mesin ini setara dengan Whisper Large V3 Turbo di 7,97. Jarak terbesarnya ada pada bahasa Inggris, 8,80 (Apple Speech) dibandingkan 4,49 (Qwen3-ASR 1.7B), dan tidak ada hasil Apple Speech sama sekali untuk bahasa Belanda, Polandia, atau Rusia.
Dibandingkan Whisper Small, Apple Speech telah lebih akurat pada delapan dari sepuluh bahasa yang diukur dengan baik oleh keduanya. Dua kekalahannya adalah bahasa Inggris, 8,80 (Apple Speech) dibandingkan 7,04 (Whisper Small), dan Portugis Brasil, 9,35 dibandingkan 8,61.
Sebuah pengujian yang diterbitkan pada bulan Juli telah mengukur Apple Speech pada bahasa Inggris melawan Whisper Small dan menempatkan Apple di depan. Versi Whisper yang dibandingkan sangat menentukan, begitu pula klipnya. Pengujian itu menggunakan LibriSpeech, yaitu narator buku audio yang membaca dengan lantang; pengujian kami menggunakan FLEURS, dengan banyak penutur berbeda yang membaca kalimat Wikipedia. Pengujian kami menunjukkan selisih pada bahasa Inggris, tetapi tidak dapat menentukan penyebabnya.
Dibandingkan Whisper Large V3 Turbo, urutannya terbalik. Apple Speech telah tertinggal pada delapan dari sepuluh bahasa tersebut, seri pada bahasa Mandarin di 7,97, dan hanya memimpin pada bahasa Kanton, 8,69 (Apple Speech) dibandingkan 36,75 (Whisper Large V3 Turbo) — lihat baris Kanton di bawah. Catatan rilis Turbo dari OpenAI menyebut Kanton sebagai salah satu bahasa tempat model paling banyak menurun, sehingga 36,75 adalah kelemahan Whisper yang sudah diketahui, bukan keanehan dalam pengujian kami.
Pada bahasa Korea, Apple Speech telah salah mengenali sekitar satu dari 23 karakter. Model paling akurat dalam pengujian ini, Qwen3-ASR 1.7B, telah salah mengenali sekitar satu dari 28: 4,31 (Apple Speech) dibandingkan 3,54 (Qwen3-ASR 1.7B).
Parakeet V3 merupakan unduhan 465 MB dan telah lebih akurat pada setiap bahasa Eropa yang didukung keduanya: 6,89 (Parakeet V3) dibandingkan 8,80 (Apple Speech) pada bahasa Inggris, 5,83 dibandingkan 7,61 pada bahasa Prancis, 4,86 dibandingkan 5,41 pada bahasa Spanyol, 3,43 dibandingkan 4,39 pada bahasa Italia, dan 6,49 dibandingkan 9,35 pada Portugis Brasil; keduanya seri pada bahasa Jerman di 6,26. Model ini tidak memiliki bahasa Jepang, Korea, Mandarin, atau Kanton; pada bahasa-bahasa itu Apple Speech adalah satu-satunya dari keduanya yang tersedia.
Keenam baris yang dipimpin Qwen3-ASR 1.7B mencakup bahasa Inggris, Jerman, Prancis, dan Spanyol.
SenseVoice Small adalah mesin tercepat di sini pada 162,3× realtime, dan pada bahasa Mandarin serta Inggris, mesin ini setara dengan Apple Speech: 7,69 (SenseVoice Small) dibandingkan 7,97 (Apple Speech) dan 8,46 dibandingkan 8,80. Pada bahasa Korea, mesin ini telah jauh tertinggal, 7,85 (SenseVoice Small) dibandingkan 4,31 (Apple Speech).
Ukuran dan kecepatan
| Mesin | Kecepatan | Memori puncak | Unduhan |
|---|---|---|---|
| SenseVoice Small | 162,3× realtime | 0,95 GiB | 827 MB |
| Parakeet V3 | 75,6× realtime | 0,09 GiB | 465 MB |
| Apple Speech | 30,8× realtime | tidak dilaporkan | <5 MB |
| Qwen3-ASR 1.7B | 11,1× realtime | 2,43 GiB | sekitar 2,5 GB |
| Whisper Small | 7,9× realtime | 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3,0× realtime | 1,87 GiB | sekitar 1,6 GB |
Kecepatan adalah median setiap mesin di seluruh tiga belas bahasa yang diukur dengan baik dalam artikel ini, hanya menghitung bahasa yang telah dijalankannya — throughput pemrosesan item terisolasi, sebuah diagnostik, bukan latensi produk. Memori puncak adalah puncak kelompok proses dalam pengujian ini. Apple Speech melakukan pengodean balik di dalam layanan macOS yang tidak dimiliki aplikasi pemanggil, sehingga angka apa pun di sana tidak akan memiliki arti yang sama seperti pada lima mesin lainnya.
Apple Speech telah berjalan pada 30,8× realtime, di belakang Parakeet V3 pada 75,6× dan SenseVoice Small pada 162,3×. Paket bahasanya diunduh sekali oleh macOS dan dipakai bersama oleh setiap aplikasi, sehingga tidak ada yang dialokasikan di dalam proses aplikasi sendiri. Layanan yang melakukan dekode tetap menggunakan memori, tetapi kami tidak dapat mengaitkannya secara tepat; karena itu, kami tidak melaporkan angka apa pun di sana alih-alih menulis nol.
Whisper Large V3 Turbo adalah mesin paling lambat di sini pada 3,0× realtime dan memiliki tingkat kesalahan terendah dalam empat dari sepuluh baris, dengan sekitar 1,6 GB pada disk. Qwen3-ASR 1.7B memimpin enam baris lainnya, dengan sekitar 2,5 GB pada disk dan puncak 2,43 GiB. Whisper Small dengan 600 MB adalah pembanding yang wajar untuk mesin bawaan.
Bahasa apa yang cocok untuk Apple Speech?
Bahasa per bahasa:
- Inggris: tidak cocok. Apple Speech telah mencatat 8,80; Qwen3-ASR 1.7B (4,49) atau Whisper Large V3 Turbo (5,49) jelas lebih akurat.
- Jerman: tidak cocok. Apple Speech telah mencatat 6,26; Qwen3-ASR 1.7B (2,85) atau Whisper Large V3 Turbo (4,05) jelas lebih akurat.
- Belanda, Rusia, dan Polandia: Apple Speech tidak memiliki model untuk ketiganya. Whisper Large V3 Turbo telah menjadi yang paling akurat pada masing-masing bahasa, dengan 5,69, 5,13, dan 5,45.
- Jepang: dapat digunakan. Apple Speech telah mencatat 6,36, di belakang Whisper Large V3 Turbo pada 5,30.
- Korea: dapat digunakan. Apple Speech telah mencatat 4,31, di belakang Qwen3-ASR 1.7B pada 3,54.
- Prancis: tidak cocok. Apple Speech telah mencatat 7,61; Qwen3-ASR 1.7B (4,57) atau Parakeet V3 (5,83) jelas lebih akurat.
- Mandarin: dapat digunakan. Apple Speech telah mencatat 7,97, setara dengan Whisper Large V3 Turbo; yang paling akurat adalah Qwen3-ASR 1.7B pada 6,49.
- Spanyol: tidak cocok. Apple Speech telah mencatat 5,41; Qwen3-ASR 1.7B (3,38) atau Whisper Large V3 Turbo (3,62) jelas lebih akurat.
Dalam pengujian ini, model yang diunduh tetap unggul dalam akurasi: setiap baris tabel utama dipimpin Qwen3-ASR 1.7B atau Whisper Large V3 Turbo. Apple Speech merupakan pilihan nyata untuk bahasa Korea, Jepang, dan Mandarin; untuk bahasa Eropa, Parakeet V3 adalah pilihan yang tepat.
Di Whisper Notes untuk Mac, Parakeet V3 tetap menjadi model bawaan. Di aplikasi Mac yang diunduh dari situs web kami, Apple Speech tersedia sebagai model opsional di macOS 26 atau lebih baru, dan aplikasi hanya menawarkan suatu bahasa ketika macOS melaporkan bahwa Mac Anda mendukungnya.
Apple Speech adalah singkatan dalam artikel ini untuk SpeechTranscriber dari Apple, API di perangkat yang dapat dipanggil aplikasi Mac mana pun pada macOS 26 atau lebih baru. Ini adalah mesin sistem, bukan model yang Anda unduh: Whisper Notes untuk Mac dapat memakainya pada versi yang diunduh dari situs web kami, dengan paket bahasa yang disediakan macOS. Model yang diunduh sendiri oleh aplikasi tetap Whisper, Parakeet V3, SenseVoice, dan Qwen3-ASR pada versi tersebut, serta Whisper, Parakeet V3, dan SenseVoice pada iPhone dan versi Mac App Store. Tabel per mesin ada di daftar bahasa yang didukung Whisper, Parakeet V3, dan SenseVoice.
Di luar sepuluh bahasa
| Bahasa | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Italia | 4,39 | 2,58 | 2,58 | 7,64 | 3,43 | — |
| Kanton | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Portugis (Brasil) | 9,35 | 5,17 | 5,44 | 8,61 | 6,49 | — |
| Hindi | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Empat bahasa lain dari pengujian yang sama. Kolom, warna, dan nama singkat yang sama seperti di atas; CER untuk Kanton, WER untuk bahasa lainnya.
Hasil bahasa Hindi dari Apple Speech tidak disertakan dalam peringkat baris tersebut karena alasan di bawah. Tingkat kesalahan dapat melebihi 100% karena sisipan juga dihitung dalam pembilang.
Bahasa Italia di 4,39 (Apple Speech) berada di belakang hasil seri 2,58 antara Qwen3-ASR 1.7B dan Whisper Large V3 Turbo. Kanton adalah satu-satunya bahasa tempat Apple Speech unggul atas Whisper Large V3 Turbo, 8,69 (Apple Speech) dibandingkan 36,75 (Whisper Large V3 Turbo), dengan Qwen3-ASR 1.7B di urutan pertama pada 6,44. Portugis Brasil berada di 9,35 (Apple Speech), salah satu dari dua baris tempat Whisper Small, pada 8,61, berada di depan.
Bahasa Hindi adalah jenis hasil yang berbeda. Apple Speech telah menulis bahasa Hindi dengan huruf bahasa Inggris, bukan dengan cara penulisan bahasa Hindi sendiri, sehingga hampir setiap kata dihitung salah dan tingkatnya melebihi 100%. Telugu, Urdu, Punjabi, Bengali, Nepali, Malayalam, Marathi, Kannada, Gujarati, dan Tamil telah kembali dengan cara yang sama, semuanya di atas 100%, sehingga tidak disertakan dalam tabel.
Cara kerja SpeechAnalyzer
SpeechAnalyzer menggantikan API pengenalan ucapan yang telah dimiliki Apple sejak iOS 10, pada setiap platform Apple kecuali watchOS. Aplikasi membuat SpeechAnalyzer, memberinya modul, lalu memasukkan audio sebagai urutan asinkron yang diisi sendiri oleh aplikasi; SpeechTranscriber adalah modul yang mengubah ucapan menjadi teks. Hasilnya kembali sebagai urutan kedua, biasanya pada tugas lain, dan setiap buffer serta hasil diberi kode waktu terhadap linimasa audio sendiri.
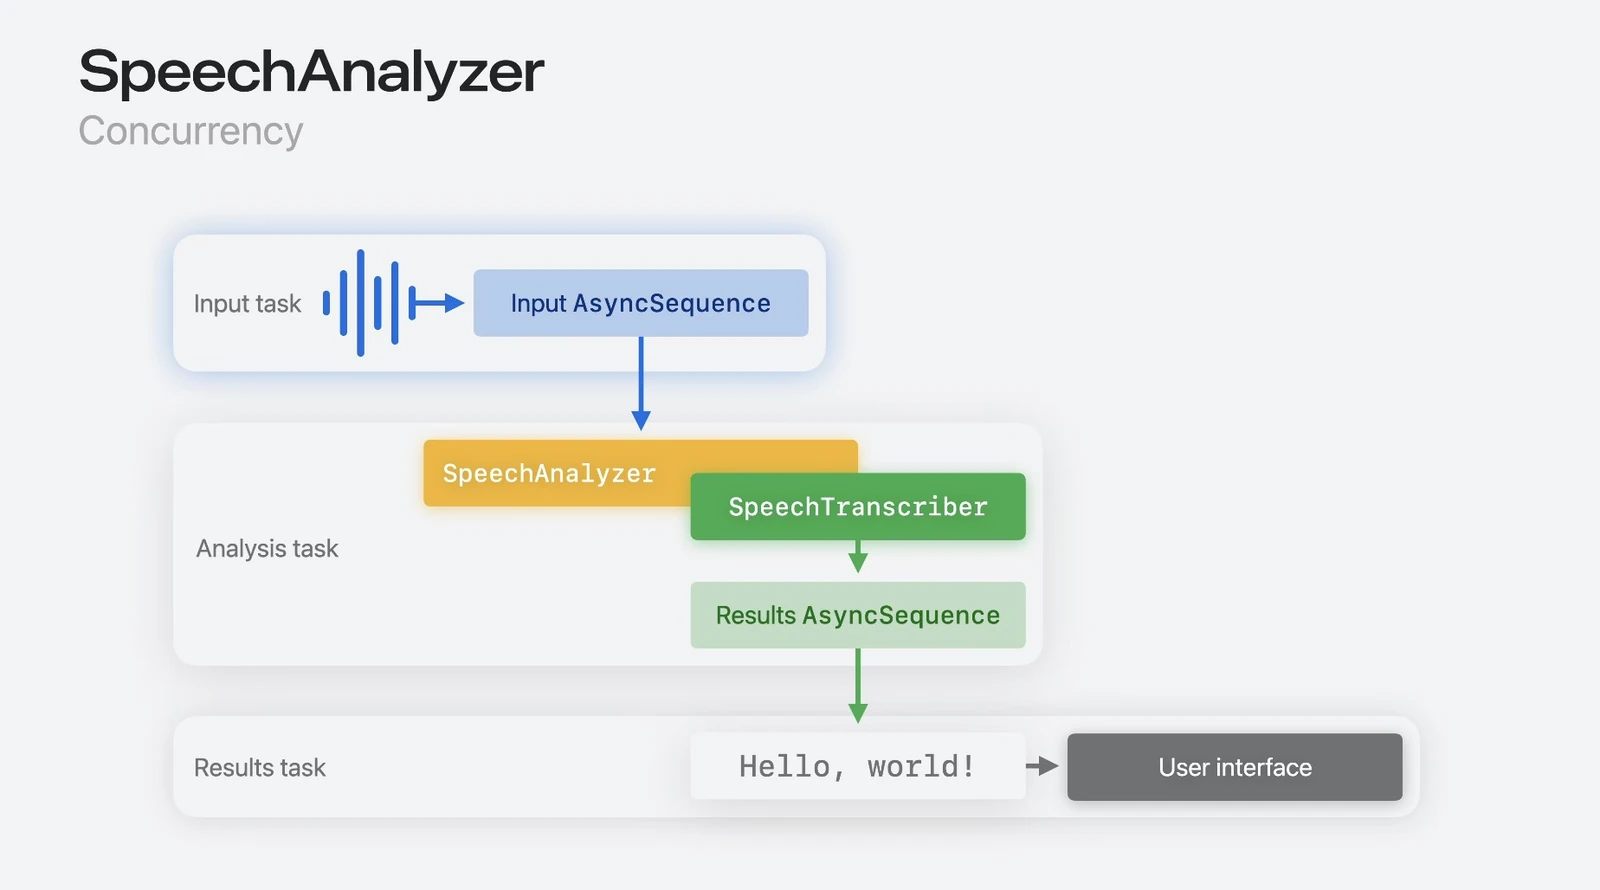
Satu sesi, tiga tugas: audio masuk sebagai AsyncSequence, SpeechAnalyzer dan SpeechTranscriber menganalisisnya, lalu hasil kembali sebagai AsyncSequence kedua untuk dibaca antarmuka. Sumber: Apple, sesi 277 WWDC25.
Hasil tiba dua kali. Apa pun di dalam rentang yang disebut Apple sebagai rentang volatil masih dapat diganti oleh hasil yang lebih baik; apa pun di luarnya bersifat final. Dengan cara ini, aplikasi menampilkan transkrip kasar saat Anda masih berbicara lalu memperbaikinya setelah itu. Apple menyatakan lima sasaran desain untuk model SpeechTranscriber: audio panjang, ucapan percakapan, pembicara yang jauh, latensi rendah, dan privasi, yang berarti model berjalan di perangkat. Catatan, Memo Suara, Jurnal, dan peringkasan panggilan dibangun di atasnya.
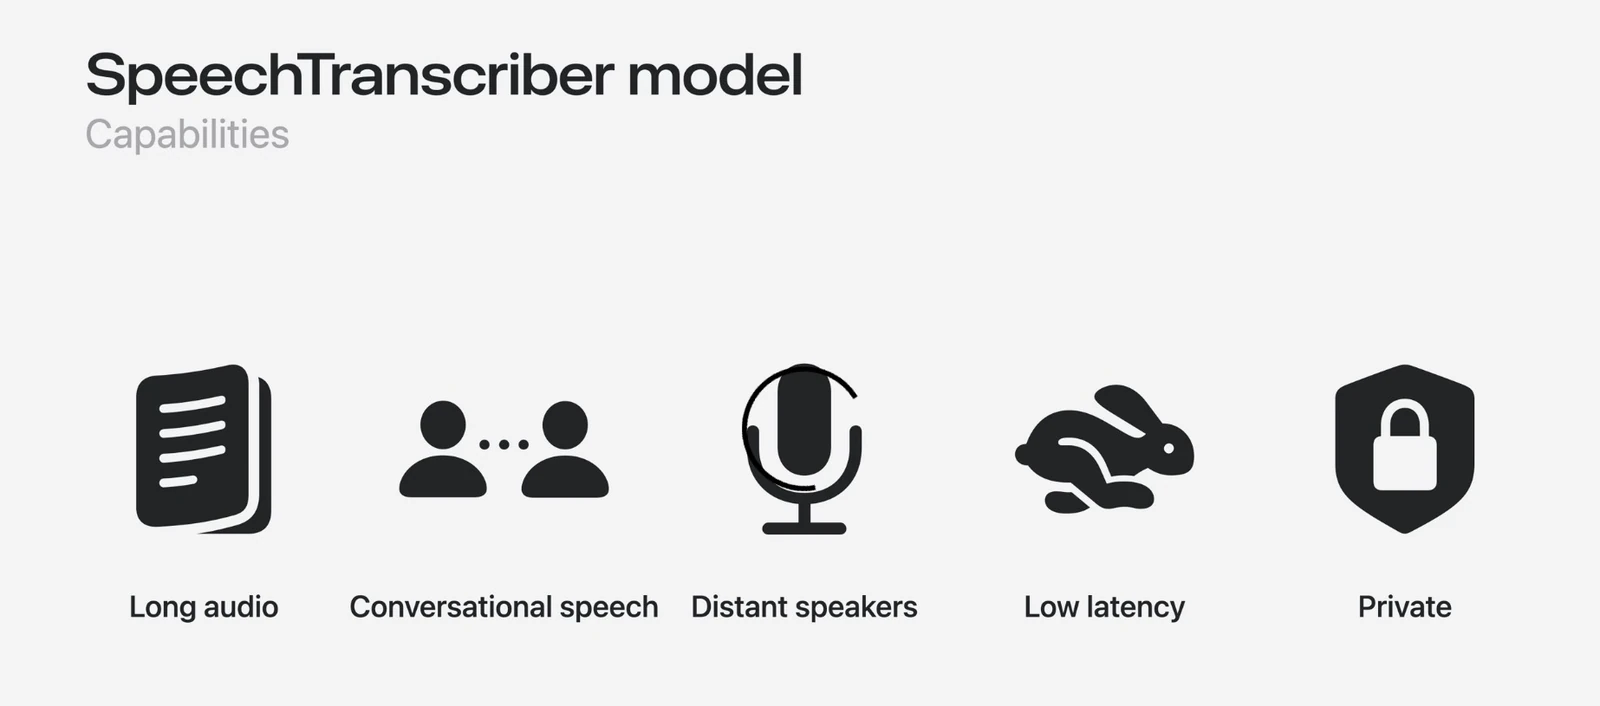
Lima sasaran desain yang dinyatakan Apple untuk model SpeechTranscriber. Sumber: Apple, sesi 277 WWDC25.
Model tidak menjadi bagian dari aplikasi apa pun. Model diunduh dari server Apple melalui AssetInventory, disimpan dan diperbarui oleh sistem, serta digunakan bersama antar-aplikasi. Model tidak menambah ukuran unduhan aplikasi, dan dekode berlangsung di luar proses pemanggil. Jika SpeechTranscriber tidak memiliki model untuk suatu bahasa atau perangkat, DictationTranscriber mengambil alih dengan model yang sama seperti dikte sistem.
Metode dan keterbatasan
Lima dari enam mesin dalam tabel ini adalah model yang diunduh Whisper Notes. Setiap mesin telah mentranskripsikan klip yang sama, dalam urutan yang sama, satu per satu, pada M5 MacBook Air (32 GB, macOS 27.0). Audionya berasal dari bagian uji Google FLEURS pada revisi 70bb2e84, sekitar 150 kalimat dan 30 menit per bahasa. Hash tetap dari ID setiap item dalam set data telah menyusun item secara berurutan, dan kami mengambil rangkaian item utuh terpendek yang melewati tiga puluh menit; tidak ada keluaran model yang berperan dalam pilihan itu. Setiap sel telah dibuat ulang dari bukti masing-masing dan diperiksa lagi, dan seluruh 285 sel telah lulus. Skor merupakan tingkat kesalahan kata ketika kata dipisahkan oleh spasi, dan tingkat kesalahan karakter untuk bahasa Jepang, Korea, Mandarin, dan Kanton; keduanya tidak pernah digabungkan menjadi satu angka.
Anda dapat memeriksa kolom Whisper terhadap angka milik OpenAI. Pada dua belas bahasa tempat OpenAI menerbitkan hasil FLEURS untuk Whisper Large V3 Turbo, angka kami berada dalam selisih rata-rata 0,7 poin dari angkanya, dan sepuluh dari dua belas berada dalam interval 95% pengujian kami; pada sebelas bahasa di luar baris bahasa India, angka Whisper Small kami berada dalam selisih rata-rata 1,0 poin dari tabel per bahasa dalam makalah Whisper. Kolom Apple Speech telah dihasilkan dari klip yang sama, penilai yang sama, dan penormal yang sama.
FLEURS adalah tuturan bersih yang dibacakan. Tidak ada yang menyatakan bagaimana mesin ini berperilaku di ruangan bising atau sepanjang rapat dua jam, dan kami tidak mengukur selisihnya dalam keadaan tersebut. Semuanya telah berjalan di satu mesin. Dengan sekitar 150 kalimat per bahasa, dua mesin yang terpaut kurang dari sekitar satu poin dianggap seri; tabel telah menandai seri persis seperti itu, misalnya pada bahasa Italia, tempat Qwen3-ASR 1.7B dan Whisper Large V3 Turbo sama-sama telah mencatat 2,58.
Pertanyaan yang Sering Diajukan
Apple Speech atau Whisper Small: mana yang lebih akurat?
Apple Speech, pada delapan dari sepuluh bahasa yang diukur dengan baik oleh keduanya. Kekalahannya adalah bahasa Inggris, 8,80 (Apple Speech) dibandingkan 7,04 (Whisper Small), dan Portugis Brasil, 9,35 dibandingkan 8,61. Jarak terlebarnya ada pada bahasa Mandarin, 7,97 (Apple Speech) dibandingkan 20,50 (Whisper Small); bahasa Prancis, 7,61 dibandingkan 13,24; bahasa Jepang, 6,36 dibandingkan 11,37; dan Kanton, 8,69 dibandingkan 119,01. Whisper Small merupakan unduhan 600 MB dan berjalan pada 7,9× realtime, dibandingkan 30,8× untuk Apple Speech.
Apple Speech atau Parakeet V3: mana yang lebih akurat?
Parakeet V3, pada setiap bahasa Eropa yang didukung keduanya: 6,89 (Parakeet V3) dibandingkan 8,80 (Apple Speech) pada bahasa Inggris, 5,83 dibandingkan 7,61 pada bahasa Prancis, 4,86 dibandingkan 5,41 pada bahasa Spanyol, 3,43 dibandingkan 4,39 pada bahasa Italia, dan 6,49 dibandingkan 9,35 pada Portugis Brasil; keduanya seri pada bahasa Jerman di 6,26. Parakeet V3 tidak memiliki bahasa Jepang, Korea, Mandarin, atau Kanton, sehingga di sana Apple Speech adalah satu-satunya dari keduanya yang tersedia. Parakeet V3 merupakan unduhan 465 MB dan berjalan pada 75,6× realtime, Apple Speech pada 30,8×.
Apple Speech atau Whisper Large V3 Turbo: mana yang lebih akurat?
Whisper Large V3 Turbo, pada delapan dari sepuluh bahasa yang diukur dengan baik oleh keduanya: bahasa Inggris 5,49 (Whisper Large V3 Turbo) dibandingkan 8,80 (Apple Speech), bahasa Jerman 4,05 dibandingkan 6,26, bahasa Jepang 5,30 dibandingkan 6,36, bahasa Korea 4,25 dibandingkan 4,31, bahasa Prancis 5,97 dibandingkan 7,61, bahasa Spanyol 3,62 dibandingkan 5,41, bahasa Italia 2,58 dibandingkan 4,39, Portugis Brasil 5,44 dibandingkan 9,35. Keduanya seri pada bahasa Mandarin di 7,97; Apple Speech hanya memimpin pada Kanton, 8,69 (Apple Speech) dibandingkan 36,75 (Whisper Large V3 Turbo). Turbo juga mencakup bahasa Belanda, Rusia, dan Polandia, pada 5,69, 5,13, dan 5,45. Ukurannya sekitar 1,6 GB dan ia mesin paling lambat di sini pada 3,0× realtime.
Bahasa apa saja yang didukung Apple Speech?
Dalam pengujian kami, Apple Speech memberikan hasil pada 21 dari 83 konfigurasi: bahasa Inggris, Jerman, Prancis, Spanyol, Italia, Portugis (Brasil), Jepang, Korea, Mandarin, Kanton, dan sebelas bahasa Asia Selatan — Hindi, Telugu, Urdu, Punjabi, Bengali, Nepali, Malayalam, Marathi, Kannada, Gujarati, dan Tamil — yang dijawabnya dengan huruf bahasa Inggris, bukan cara penulisannya sendiri. Tidak ada bahasa Belanda, Polandia, atau Rusia; macOS menentukan daftarnya per mesin. Mesin ini paling dekat dengan para pemimpin pada bahasa Korea, Jepang, dan Mandarin, tertinggal 0,77, 1,06, dan 1,48; terjauh pada bahasa Inggris, 8,80 (Apple Speech) dibandingkan 4,49 (Qwen3-ASR 1.7B); dan unggul atas dikte lama pada kesepuluh bahasa yang diukur keduanya. Whisper dalam Whisper Notes mencakup seluruh daftar bahasa aplikasi di setiap kanal.
Apa itu SpeechAnalyzer, dan apakah sama dengan Apple Dictation?
SpeechAnalyzer adalah API yang diperkenalkan Apple pada WWDC 2025 dan disertakan dalam macOS 26 serta iOS 26. SpeechTranscriber adalah mesin transkripsi di dalamnya, yang disebut artikel ini sebagai Apple Speech; dikte adalah mesin kompatibilitas yang lebih lama. Kami telah menjalankan keduanya, dan Apple Speech telah lebih akurat pada kesepuluh bahasa yang diukur dengan baik oleh keduanya. Dikte menjangkau lebih banyak bahasa, 33 konfigurasi dibandingkan 21, termasuk bahasa Belanda, Polandia, dan Rusia pada 17,34%, 13,50%, dan 13,13% WER (dikte), dibandingkan 5,69%, 5,45%, dan 5,13% (Whisper Large V3 Turbo).
Apakah audio meninggalkan Mac saya saat menggunakan Apple Speech?
Apple mendokumentasikan SpeechTranscriber sebagai pengenalan ucapan di perangkat: macOS mengunduh aset bahasa sekali, lalu pengenalan berjalan secara lokal. Kami telah mengukur akurasi dan kecepatan, bukan perilaku jaringan, jadi kami menjelaskan bagian itu sebagaimana Apple menjelaskannya. Mesin yang diunduh sendiri oleh Whisper Notes — Whisper, Parakeet V3, SenseVoice, dan Qwen3-ASR — berjalan pada GPU atau Neural Engine Mac Anda sendiri tanpa akun dan tanpa API key, serta transkripsi bekerja saat jaringan mati pada setiap kanal. Apple Speech tersedia di aplikasi Mac yang diunduh dari situs web kami, di macOS 26 atau lebih baru: mesin sistem di Mac Anda, dengan paket bahasanya diunduh oleh macOS.
Mengapa angka ini tidak sama dengan akurasi pada rekaman saya?
Karena FLEURS adalah tuturan pendek, bersih, dan dibacakan, sedangkan rekaman Anda tidak demikian. Pengujian kami merupakan kalibrasi pada set data publik: sekitar 150 kalimat dan 30 menit per bahasa, satu M5 MacBook Air, dan klip yang sama untuk setiap mesin. Hasilnya menunjukkan apakah sebuah mesin masuk akal untuk bahasa Anda, bukan apa yang akan Anda dapatkan dalam rapat, pada audio bising, atau pada berkas dua jam.
Coba Sekarang
Kelima model yang dapat diunduh di sini — Whisper Small, Whisper Large V3 Turbo, Parakeet V3, SenseVoice Small, dan Qwen3-ASR 1.7B — semuanya tersedia di aplikasi Whisper Notes untuk Mac yang diunduh dari situs web kami, pada Pengaturan, lalu Model Transkripsi. Di macOS 26 atau lebih baru, Apple Speech muncul dalam daftar yang sama; kalau aplikasinya sudah terpasang, perbarui ke versi terbaru.
Jika angka kami tidak sesuai dengan pengalaman Anda dalam suatu bahasa, kirim email ke mac@whispernotes.app. Catatan rilis lengkap: whispernotes.app/changelog.
Sumber: pengujian kami pada bagian uji Google FLEURS di revisi 70bb2e84, dokumentasi SpeechAnalyzer dari Apple, dan pengujian Qwen3-ASR tiga puluh bahasa sebelumnya.
 Unduh untuk macOS