
Починаючи з macOS 26 та iOS 26, Apple постачає нове покоління розпізнавання мовлення на пристрої — SpeechAnalyzer і SpeechTranscriber, далі скорочено Apple Speech. Воно помітно точніше за старий рушій диктування. Ми хотіли з’ясувати, як на практиці воно виглядає на тлі відкритих моделей, які люди завантажують на пристрій, — Whisper, Parakeet, Qwen3-ASR і SenseVoice: чи достатньо добре тепер працює вбудоване розпізнавання мовлення Apple, щоб можна було цілком обійтися без застосунку для транскрипції?
Наскільки він кращий за диктування, яке у вас уже було?
Дотепер за розпізнавання мовлення на Mac відповідав рушій часів SFSpeechRecognizer — той самий, який і нині використовує системне диктування (DictationTranscriber). У macOS 26 та iOS 26 з’явилися API SpeechAnalyzer і його модуль SpeechTranscriber. Ми запустили обидва рушії на тестовій частині FLEURS — приблизно 150 речень і 30 хвилин на кожну мову — на тому самому Mac.
| Мова | Диктування Apple | Apple Speech |
|---|---|---|
| Корейська | 7,11 | 4,31 |
| Італійська | 6,93 | 4,39 |
| Іспанська (Латинська Америка) | 8,43 | 5,41 |
| Німецька | 12,69 | 6,26 |
| Японська | 9,37 | 6,36 |
| Французька | 17,10 | 7,61 |
| Китайська | 10,28 | 7,97 |
| Кантонська | 10,18 | 8,69 |
| Англійська | 13,83 | 8,80 |
| Португальська (Бразилія) | 10,85 | 9,35 |
Усі мови, які обидва рушії Apple виміряли без спотворень, у порядку зростання частки помилок Apple Speech; зеленим позначено краще значення в рядку. Той самий прогін, ті самі фрагменти, той самий Mac. CER для японської, корейської, китайської та кантонської, WER для решти.
Apple Speech точніший в усіх десяти мовах, які обидва рушії виміряли без спотворень. У французькій і німецькій кількість помилок скоротилася більш ніж удвічі, для медіанної мови — приблизно на третину, а в бразильській португальській і кантонській — приблизно на одну помилку із семи.
Диктування й далі охоплює більше мов. У цьому запуску Apple Speech повернув результати для 21 із 83 мовних конфігурацій, а диктування — для 33, зокрема для трьох мов, яких тут немає в нового рушія: нідерландської, польської та російської з результатами 17,34, 13,50 і 13,13. Єдиного сталого списку також немає. Мовні ресурси належать macOS, тому під час роботи застосунок запитує систему, що доступне на конкретному Mac.
То чи можна обійтися без завантажуваних моделей?
Шість рушіїв, ті самі записи, один Mac. Нижче наведено десять із найуживаніших мов у фіксованому порядку, який ніяк не пов’язаний із результатами.
| Мова | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Англійська | 8,80 | 4,49 | 5,49 | 7,04 | 5,89 | 8,46 |
| Німецька | 6,26 | 2,85 | 4,05 | 8,67 | 5,19 | — |
| Нідерландська | — | 7,36 | 5,69 | 16,75 | 7,89 | — |
| Російська | — | 5,65 | 5,13 | 11,37 | 6,17 | — |
| Польська | — | 12,59 | 5,45 | 15,81 | 6,59 | — |
| Японська | 6,36 | 5,74 | 5,30 | 11,37 | — | 6,78 |
| Корейська | 4,31 | 3,54 | 4,25 | 7,30 | — | 7,85 |
| Французька | 7,61 | 4,57 | 5,97 | 13,24 | 5,19 | — |
| Китайська | 7,97 | 6,49 | 7,97 | 20,50 | — | 7,69 |
| Іспанська (Латинська Америка) | 5,41 | 3,38 | 3,62 | 6,22 | 3,95 | — |
Десять із найуживаніших мов, по одному рушію в кожному стовпці. У кожній клітинці — частка помилок рушія: що нижче, то краще; зеленим позначено найнижче значення в рядку, білим — друге. CER для японської, корейської та китайської, WER для решти; ми ніколи не зводимо їх до одного числа. Наш власний прогін FLEURS, виконаний командою Whisper Notes, на одному M5 MacBook Air, начитане мовлення.
Короткі назви: Qwen3-ASR = Qwen3-ASR 1.7B, Whisper Large = Whisper Large V3 Turbo, Parakeet = Parakeet Ultra, вбудована модель Parakeet, SenseVoice = SenseVoice Small. Риска означає, що рушій не має моделі для цієї мови. Стовпець Parakeet виміряно пізніше на тих самих записах і, як і для всіх рушіїв тут, із заданою мовою; у статті Parakeet Ultra vs Parakeet V3 модель виміряно так, як вона працює в застосунку, — з автоматичним визначенням мови.
Qwen3-ASR 1.7B має найнижчу частоту помилок у шести з десяти мов, Whisper Large V3 Turbo — у решті чотирьох, а Apple Speech — у жодній. Найближче він до лідера в корейській, де відстає на 0,77 пункту, далі в японській на 1,06 і китайській на 1,48; у китайській він зрівнявся з Whisper Large V3 Turbo на позначці 7,97. Найбільший розрив — в англійській: 8,80 (Apple Speech) проти 4,49 (Qwen3-ASR 1.7B). Для нідерландської, польської та російської результату Apple Speech немає взагалі.
Порівняно з Whisper Small Apple Speech був точнішим у восьми з десяти мов, які обидва рушії виміряли без спотворень. Він поступився у двох: англійській — 8,80 (Apple Speech) проти 7,04 (Whisper Small) — і бразильській португальській — 9,35 проти 8,61.
Опублікований у липні бенчмарк порівнював Apple Speech із Whisper Small в англійській і показав перевагу Apple. Важливо і те, яка версія Whisper бере участь у порівнянні, і те, які записи використано. У тому тесті був LibriSpeech — диктори аудіокнижок, які читають уголос; у нас FLEURS — багато різних людей, які читають речення з Вікіпедії. Наш запуск показує розрив в англійській, але не дає змоги назвати його причину.
У порівнянні з Whisper Large V3 Turbo порядок змінюється. Apple Speech поступається у восьми з цих десяти мов, ділить результат 7,97 у китайській і випереджає Turbo лише в кантонській: 8,69 (Apple Speech) проти 36,75 (Whisper Large V3 Turbo) — дивіться рядок кантонської нижче. У примітках до випуску Turbo OpenAI називає кантонську однією з мов, на яких модель погіршилася найбільше, тому 36,75 — відома слабкість Whisper, а не особливість нашого запуску.
У корейській Apple Speech помиляється приблизно в одному символі з 23. Найточніша модель у цьому запуску, Qwen3-ASR 1.7B, помиляється приблизно в одному з 28: 4,31 (Apple Speech) проти 3,54 (Qwen3-ASR 1.7B).
Parakeet Ultra точніший у кожній європейській мові, яку підтримують обидва рушії: в англійській 5,89 (Parakeet Ultra) проти 8,80 (Apple Speech), у німецькій 5,19 проти 6,26, у французькій 5,19 проти 7,61, в іспанській 3,95 проти 5,41, в італійській 2,62 проти 4,39 і в бразильській португальській 5,81 проти 9,35. Parakeet не підтримує японську, корейську, китайську та кантонську — із цієї пари там доступний лише Apple Speech.
Серед шести рядків, у яких лідирує Qwen3-ASR 1.7B, є англійська, німецька, французька та іспанська.
SenseVoice Small тут найшвидший — 162,3× реального часу. У китайській та англійській його результати близькі до Apple Speech: 7,69 (SenseVoice Small) проти 7,97 (Apple Speech) і 8,46 проти 8,80. У корейській він далеко позаду: 7,85 (SenseVoice Small) проти 4,31 (Apple Speech).
Розмір і швидкість
| Рушій | Швидкість | Пікова пам'ять | Завантаження |
|---|---|---|---|
| SenseVoice Small | 162,3× реального часу | 0,95 GiB | близько 450 MB |
| Parakeet V3 | 75,6× реального часу | 0,09 GiB | 465 MB |
| Apple Speech | 30,8× реального часу | не вказано | <5 MB |
| Qwen3-ASR 1.7B | 11,1× реального часу | 2,43 GiB | близько 2,5 GB |
| Whisper Small | 7,9× реального часу | 0,87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3,0× реального часу | 1,87 GiB | близько 2 GB |
Швидкість — медіана кожного рушія за тринадцятьма мовами, які ця стаття вимірює без спотворень, з урахуванням лише виконаних ним прогонів: пропускна здатність обробки окремих елементів, діагностичний показник, а не затримка продукту. Пікова пам'ять — максимум для групи процесів у цьому прогоні. Apple Speech декодує у службі macOS, якою застосунок-викликач не володіє, тому жодне число там не було б зіставним з іншими п'ятьма. Ці медіани отримано на коротких фрагментах FLEURS; картка моделі SenseVoice у застосунку показує 115–131× за окремим тестом повсякденного використання.
Apple Speech працював зі швидкістю 30,8× реального часу, поступаючись Parakeet V3 із 75,6× (Parakeet Ultra працює з тією самою швидкістю) і SenseVoice Small із 162,3×. Його мовний пакет macOS завантажує один раз, і він спільний для всіх застосунків, тому у власному процесі застосунку під нього нічого не виділяється. Служба декодування все одно використовує пам’ять, але точно віднести це споживання до неї ми не можемо, тому замість нуля не вказуємо жодного значення.
Whisper Large V3 Turbo тут найповільніший — 3,0× реального часу — і має найнижчу частоту помилок у чотирьох із десяти рядків, займаючи на диску близько 2 GB. Qwen3-ASR 1.7B виграє в інших шести, займає близько 2,5 GB на диску, а пікове споживання пам’яті становить 2,43 GiB. Whisper Small розміром 600 MB — справедливе порівняння для вбудованого рушія.
Для яких мов добре підходить Apple Speech?
Мова за мовою:
- Англійська: не найкращий вибір. Apple Speech показав 8,80; Qwen3-ASR 1.7B (4,49) або Whisper Large V3 Turbo (5,49) явно точніший.
- Німецька: не найкращий вибір. Apple Speech показав 6,26; Qwen3-ASR 1.7B (2,85) або Whisper Large V3 Turbo (4,05) явно точніший.
- Нідерландська, російська та польська: Apple Speech не має моделі для цих трьох мов. Whisper Large V3 Turbo був найточнішим для кожної: 5,69, 5,13 та 5,45.
- Японська: можна використовувати. Apple Speech показав 6,36, поступившись Whisper Large V3 Turbo із результатом 5,30.
- Корейська: можна використовувати. Apple Speech показав 4,31, поступившись Qwen3-ASR 1.7B із результатом 3,54.
- Французька: не найкращий вибір. Apple Speech показав 7,61; Qwen3-ASR 1.7B (4,57) або Parakeet Ultra (5,19) явно точніший.
- Китайська: можна використовувати. Apple Speech показав 7,97, стільки ж, скільки Whisper Large V3 Turbo; найточнішим був Qwen3-ASR 1.7B із результатом 6,49.
- Іспанська: не найкращий вибір. Apple Speech показав 5,41; Qwen3-ASR 1.7B (3,38) або Whisper Large V3 Turbo (3,62) явно точніший.
Завантажувані моделі й далі виграють за точністю: кожен рядок основної таблиці очолює Qwen3-ASR 1.7B або Whisper Large V3 Turbo. Apple Speech — реальний варіант для корейської, японської та китайської; для європейських мов варто вибрати Parakeet Ultra. Як часто помиляється кожна модель у кожній із 42 мов, видно в порівнянні Parakeet, Whisper, Qwen3-ASR і SenseVoice.
У Whisper Notes для Mac вбудована модель Parakeet і далі використовується за замовчуванням; тепер це Parakeet Ultra від Moondream — модель зі стовпця Parakeet, донавчена на основі NVIDIA Parakeet V3. На macOS 26 або новішій Apple Speech доступний як додаткова модель в обох версіях для Mac — і у версії з Mac App Store, і в застосунку з нашого сайту, а мова з’являється в застосунку лише тоді, коли macOS повідомляє, що ваш Mac її підтримує.
Apple Speech — уживана в цій статті коротка назва SpeechTranscriber від Apple, API на пристрої, який може викликати будь-який застосунок для Mac на macOS 26 або новішій. Це системний рушій, а не модель, яку ви завантажуєте: Whisper Notes для Mac може використовувати його в обох версіях для Mac, з мовним пакетом від macOS, а застосунок для iPhone — в iOS 26, з мовним пакетом від iOS. Моделі, які застосунок завантажує сам, — це Whisper, Parakeet, SenseVoice та Qwen3-ASR на Mac і Whisper, Parakeet та SenseVoice на iPhone. Таблиця за рушіями — наш список мов, які підтримують Whisper, Parakeet і SenseVoice.
За межами цих десяти мов
| Мова | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| Італійська | 4,39 | 2,58 | 2,58 | 7,64 | 2,62 | — |
| Кантонська | 8,69 | 6,44 | 36,75 | 119,01 | — | 37,23 |
| Португальська (Бразилія) | 9,35 | 5,17 | 5,44 | 8,61 | 5,81 | — |
| Гінді | 101,50 | 13,19 | 29,64 | 61,26 | — | — |
Ще чотири мови з того самого запуску. Ті самі стовпці, кольори й короткі назви, що й вище; CER для кантонської, WER для решти.
Результат Apple Speech для гінді не бере участі в рейтингу цього рядка з описаної нижче причини. Частота помилок може перевищувати 100 %, оскільки вставки також враховуються в чисельнику.
Результат 4,39 (Apple Speech) ставить італійську позаду нічиєї 2,58 між Qwen3-ASR 1.7B і Whisper Large V3 Turbo. Кантонська — єдина мова, де Apple Speech випередив Whisper Large V3 Turbo: 8,69 (Apple Speech) проти 36,75 (Whisper Large V3 Turbo); першим став Qwen3-ASR 1.7B із 6,44. У бразильській португальській 9,35 (Apple Speech) — це один із двох рядків, де попереду Whisper Small із 8,61.
Із гінді вийшов результат іншого типу. Apple Speech записав мовлення гінді англійськими літерами, а не знаками, якими зазвичай пишуть гінді, тому майже кожне слово вважається помилковим і показник перевищує 100 %. Так само виглядали результати для телугу, урду, панджабі, бенгальської, непальської, малаялам, маратхі, каннада, гуджараті й тамільської — усі вище 100 %, тому до таблиці вони не потрапили.
Як працює SpeechAnalyzer
SpeechAnalyzer замінює API розпізнавання мовлення, який Apple пропонує від часів iOS 10, на всіх платформах Apple, крім watchOS. Застосунок створює SpeechAnalyzer, додає модулі й передає йому звук як асинхронну послідовність, яку наповнює сам; SpeechTranscriber — модуль, що перетворює мовлення на текст. Результати повертаються другою послідовністю, зазвичай в іншому завданні, а кожен буфер і кожен результат має часову мітку відносно власної шкали часу аудіо.
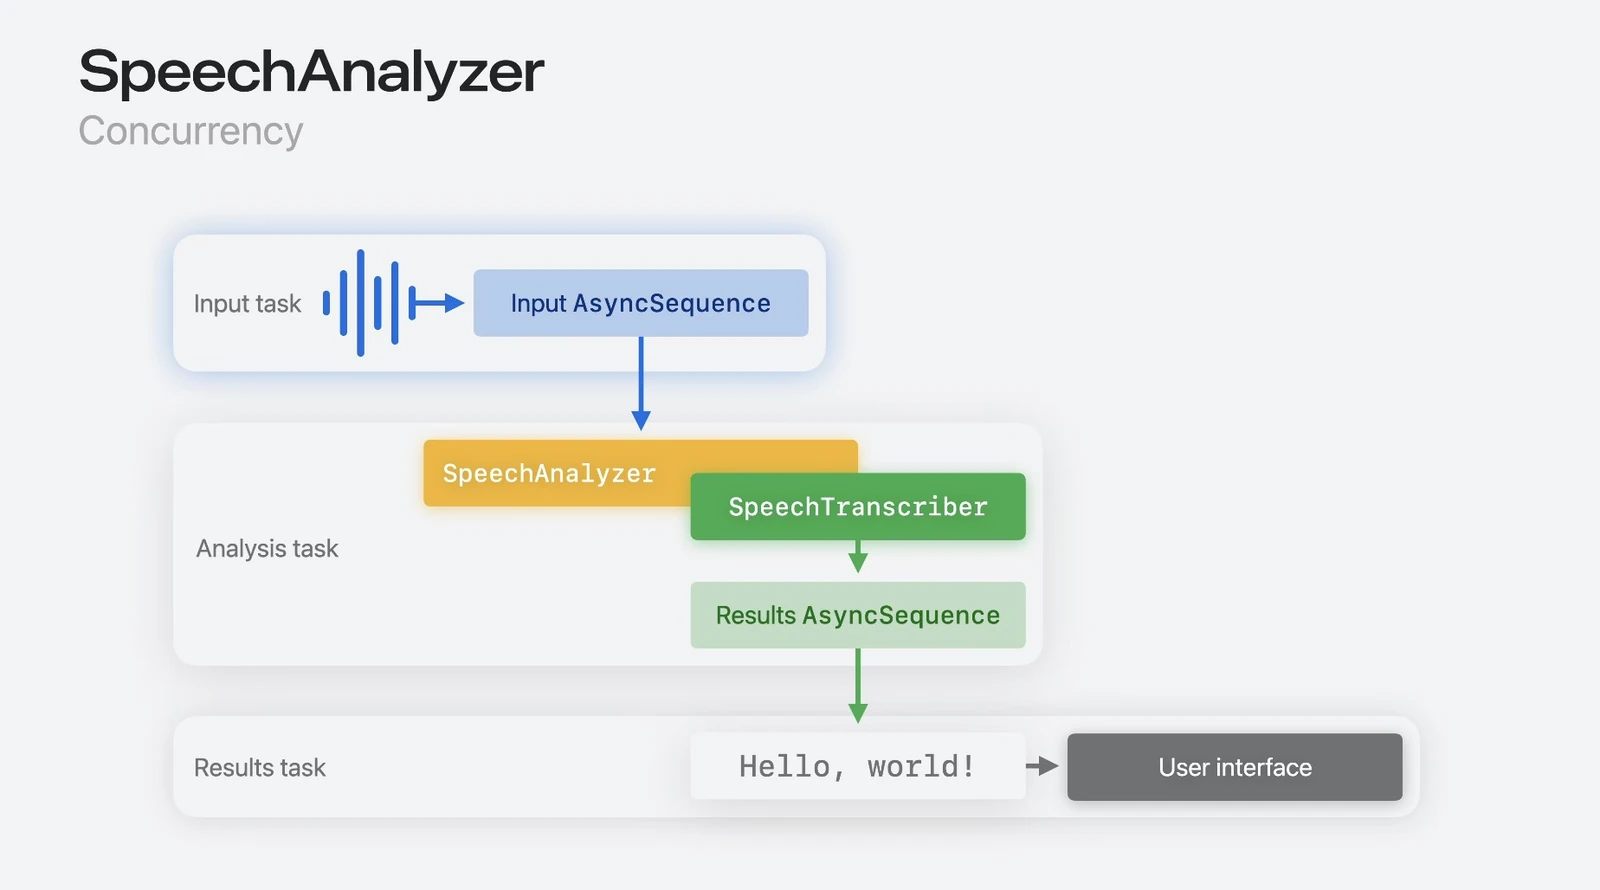
Один сеанс, три завдання: аудіо надходить як AsyncSequence, SpeechAnalyzer і SpeechTranscriber аналізують його, а результати повертаються другою AsyncSequence, яку читає інтерфейс. Джерело: Apple, сесія 277 на WWDC25.
Результати надходять двічі. Усе всередині діапазону, який Apple називає мінливим, ще може бути замінено кращим результатом; усе поза ним остаточне. Так застосунок показує чорнову транскрипцію, поки ви ще говорите, а потім виправляє її. Apple називає п'ять цілей проєктування моделі SpeechTranscriber: довге аудіо, розмовне мовлення, віддалені мовці, низька затримка та конфіденційність, тобто робота на пристрої. На ній побудовані Нотатки, Диктофон, Щоденник і підсумки дзвінків.
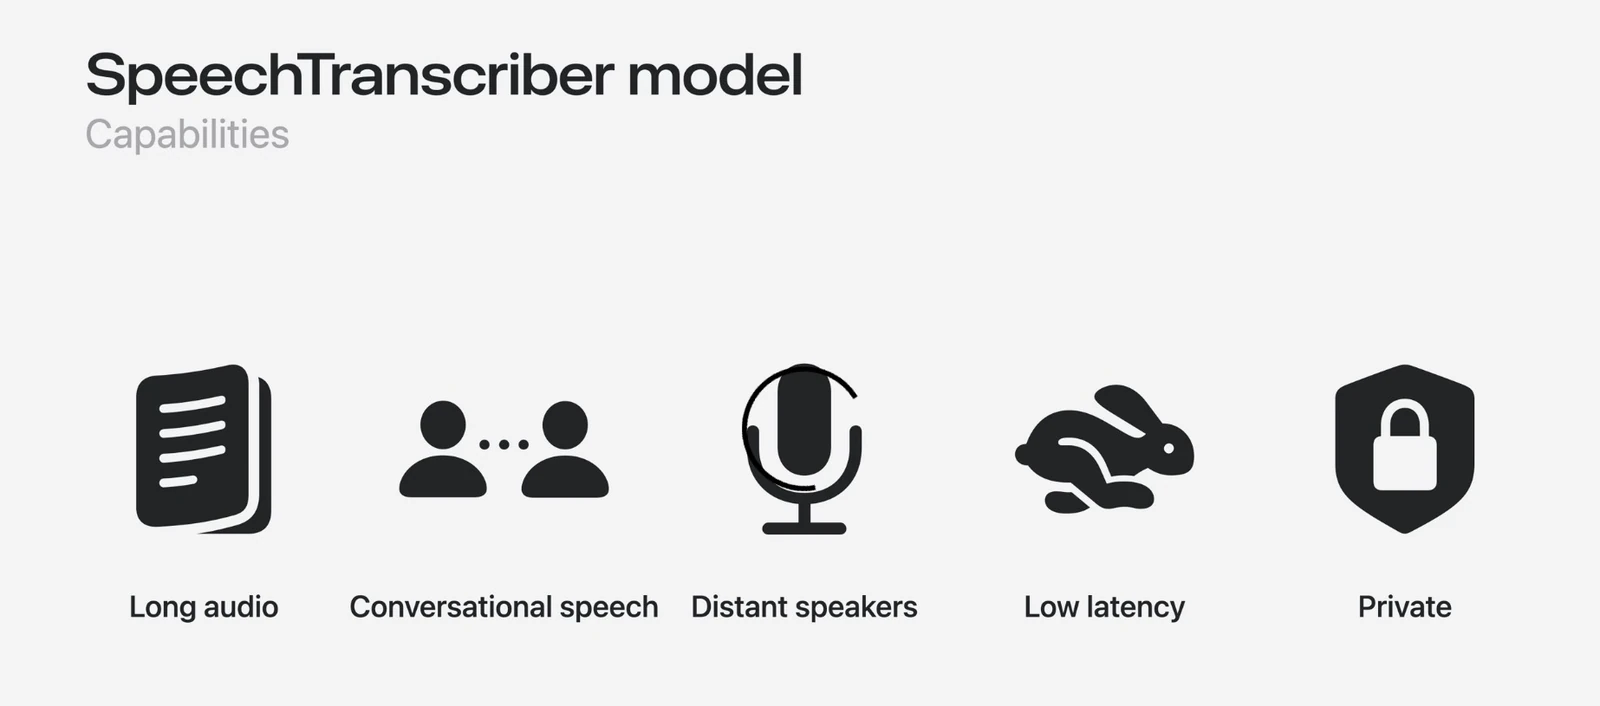
П'ять заявлених Apple цілей проєктування моделі SpeechTranscriber. Джерело: Apple, сесія 277 на WWDC25.
Моделі не входять до складу жодного застосунку. Система завантажує їх із серверів Apple через AssetInventory, зберігає, оновлює та спільно використовує між застосунками. Вони не збільшують розмір завантаження застосунку, а декодування відбувається поза процесом, який їх викликав. Якщо SpeechTranscriber не має моделі для мови чи пристрою, роботу перебирає DictationTranscriber із тими самими моделями, що й системне диктування.
Методика й обмеження
П’ять із шести рушіїв у цих таблицях — власні моделі Whisper Notes. Кожен рушій транскрибував ті самі записи, у тому самому порядку, по одному, на одному M5 MacBook Air (32 GB, macOS 27.0). Аудіо взято з тестової частини Google FLEURS у ревізії 70bb2e84 — приблизно 150 речень і 30 хвилин на мову. Сталий хеш власних ідентифікаторів елементів набору задає їхній порядок; ми беремо найкоротшу послідовність цілих елементів, яка перевищує тридцять хвилин. Результати моделей ніяк не впливали на цей вибір. Кожну клітинку заново зібрали за її власним протоколом і ще раз перевірили; усі 285 пройшли перевірку. Результати подано як частоту помилок у словах там, де слова розділено пробілами, і як частоту помилок у символах для японської, корейської, китайської та кантонської; ми ніколи не об’єднуємо їх в одне число.
Стовпці Whisper можна звірити з власними результатами OpenAI. Для дванадцяти мов, для яких OpenAI публікує результат FLEURS для Whisper Large V3 Turbo, наші значення відрізняються в середньому на 0,7 пункту, а десять із дванадцяти потрапляють у 95-відсотковий інтервал нашого запуску; для одинадцяти мов поза рядками індійських мов результати Whisper Small відрізняються в середньому на 1,0 пункту від таблиці для окремих мов у статті про Whisper. Стовпець Apple Speech отримано на тих самих записах, із тим самим оцінюванням і тією самою нормалізацією.
FLEURS — це чисте начитане мовлення. Ці результати нічого не кажуть про поведінку рушіїв у шумній кімнаті чи під час двогодинної зустрічі; відмінності в таких умовах ми не вимірювали. Усі тести виконано на одному комп’ютері. Коли на мову припадає приблизно 150 речень, рушії з різницею менш як приблизно один пункт слід вважати рівними; точні нічиї вже позначено в таблицях, як в італійській, де Qwen3-ASR 1.7B і Whisper Large V3 Turbo отримали по 2,58.
Поширені запитання
Apple Speech чи Whisper Small: що точніше?
Apple Speech — у восьми з десяти мов, які обидва рушії виміряли без спотворень. Він поступається в англійській: 8,80 (Apple Speech) проти 7,04 (Whisper Small), і в бразильській португальській: 9,35 проти 8,61. Найбільший відрив у нього в китайській: 7,97 (Apple Speech) проти 20,50 (Whisper Small); у французькій 7,61 проти 13,24; у японській 6,36 проти 11,37; у кантонській 8,69 проти 119,01. Whisper Small — це завантаження 600 MB, і він працював зі швидкістю 7,9× реального часу проти 30,8× в Apple Speech.
Apple Speech чи Parakeet: що точніше?
Parakeet Ultra, вбудована модель Parakeet, — у кожній європейській мові, яку підтримують обидва рушії: в англійській 5,89 (Parakeet Ultra) проти 8,80 (Apple Speech), у німецькій 5,19 проти 6,26, у французькій 5,19 проти 7,61, в іспанській 3,95 проти 5,41, в італійській 2,62 проти 4,39 і в бразильській португальській 5,81 проти 9,35. Parakeet не підтримує японську, корейську, китайську та кантонську — із цієї пари там доступний лише Apple Speech. У цьому прогоні Parakeet V3 працював зі швидкістю 75,6× реального часу, а Apple Speech — 30,8×; Parakeet Ultra працює з тією самою швидкістю, що й V3.
Apple Speech чи Whisper Large V3 Turbo: що точніше?
Whisper Large V3 Turbo — у восьми з десяти мов, які обидва рушії виміряли без спотворень: в англійській 5,49 (Whisper Large V3 Turbo) проти 8,80 (Apple Speech), у німецькій 4,05 проти 6,26, у японській 5,30 проти 6,36, у корейській 4,25 проти 4,31, у французькій 5,97 проти 7,61, в іспанській 3,62 проти 5,41, в італійській 2,58 проти 4,39, у бразильській португальській 5,44 проти 9,35. У китайській вони мають однаковий результат 7,97; Apple Speech випереджає лише в кантонській: 8,69 (Apple Speech) проти 36,75 (Whisper Large V3 Turbo). Turbo охоплює ще нідерландську, російську та польську — 5,69, 5,13 і 5,45. Він займає близько 2 GB і тут найповільніший рушій — 3,0× реального часу.
Які мови підтримує Apple Speech?
У нашому запуску Apple Speech повернув результати у 21 із 83 конфігурацій: англійська, німецька, французька, іспанська, італійська, португальська (Бразилія), японська, корейська, китайська, кантонська та одинадцять мов Південної Азії — гінді, телугу, урду, панджабі, бенгальська, непальська, малаялам, маратхі, каннада, гуджараті й тамільська, — у яких він відповідав англійськими літерами, а не знаками, якими зазвичай пишуть ці мови. Нідерландської, польської та російської немає; список визначає macOS для кожного комп’ютера. Найближче він до лідерів у корейській, японській і китайській — відставання 0,77, 1,06 і 1,48, — а найдалі в англійській: 8,80 (Apple Speech) проти 4,49 (Qwen3-ASR 1.7B). У всіх десяти мовах, які виміряли обидва, він точніший за старе диктування. Whisper у Whisper Notes охоплює весь список мов застосунку на кожному каналі.
Що таке SpeechAnalyzer і чи це те саме, що диктування Apple?
SpeechAnalyzer — API, який Apple представила на WWDC 2025 і випустила в macOS 26 та iOS 26. SpeechTranscriber — рушій транскрипції всередині нього, який у цій статті ми називаємо Apple Speech; диктування — старіший рушій сумісності. Ми запустили обидва, і Apple Speech був точнішим у всіх десяти мовах, для яких обидва повернули коректні результати. Диктування охоплює більше мов — 33 конфігурації проти 21, зокрема нідерландську, польську та російську з 17,34 %, 13,50 % і 13,13 % WER (диктування) проти 5,69 %, 5,45 % і 5,13 % (Whisper Large V3 Turbo).
Чи залишає аудіо мій Mac, коли я використовую Apple Speech?
Apple описує SpeechTranscriber як розпізнавання мовлення на пристрої: macOS один раз завантажує мовні ресурси, після чого розпізнавання працює локально. Ми вимірювали точність і швидкість, а не поведінку мережі, тому цю частину передаємо за описом Apple. Рушії, які завантажує сам Whisper Notes, — Whisper, Parakeet, SenseVoice і Qwen3-ASR — працюють на GPU або Neural Engine вашого Mac без облікового запису й API key, а транскрипція доступна без мережі на кожному каналі. Apple Speech доступний в обох версіях для Mac на macOS 26 або новішій: це системний рушій на вашому Mac, мовний пакет для якого завантажує macOS.
Чому ці цифри не збігаються з точністю на моїх записах?
Тому що FLEURS — це коротке, чисте, начитане мовлення, а ваші записи — ні. Наш запуск — це калібрування на відкритому наборі даних: приблизно 150 речень і 30 хвилин на мову, один M5 MacBook Air та однакові записи для кожного рушія. Він показує, чи підходить рушій для вашої мови, але не те, який результат ви отримаєте на зустрічі, у шумному аудіо чи у двогодинному файлі.
Спробуйте
Усі п’ять моделей із цього порівняння — Whisper Small, Whisper Large V3 Turbo, SenseVoice Small, Qwen3-ASR 1.7B і Parakeet Ultra, яка в списку називається «Parakeet», — є в обох версіях Whisper Notes для Mac — з Mac App Store і з нашого сайту — за шляхом Налаштування → Модель транскрипції. На macOS 26 або новішій Apple Speech з’являється в тому самому списку, а на iPhone з iOS 26 — і в списку моделей у застосунку; якщо застосунок уже встановлено, оновіть його до останньої версії.
Якщо наші цифри не збігаються з вашим досвідом для якоїсь мови, напишіть на mac@whispernotes.app. Повні примітки до випусків: whispernotes.app/changelog.
Джерела: наш прогін на тестовому спліті Google FLEURS ревізії 70bb2e84, документація Apple щодо SpeechAnalyzer і попередній прогін Qwen3-ASR на тридцяти мовах.
 Завантажити для macOS