从 macOS 26 和 iOS 26 开始,苹果有了新一代设备端语音识别——SpeechAnalyzer 和 SpeechTranscriber,下文简称 Apple Speech。和旧的听写引擎相比,它的准确率明显提高了。我们想知道的是,放到实际使用里,它和大家会去下载的设备端开源模型——Whisper、Parakeet、Qwen3-ASR、SenseVoice——比起来如何:苹果自带的本地语音识别,现在够用到可以不再装任何转写应用了吗?
Apple Speech 比以前的听写好多少?
在此之前,Mac 上的语音识别是 SFSpeechRecognizer 那一代引擎,也就是今天系统听写仍在用的那个(DictationTranscriber)。macOS 26 和 iOS 26 新增的是 SpeechAnalyzer 这套 API 和它的 SpeechTranscriber 模块。两个我们都在 FLEURS 测试集上跑了一遍,每种语言约 150 句、约 30 分钟,同一台 Mac。
| 语言 | Apple Dictation | Apple Speech |
|---|---|---|
| 韩语 | 7.11 | 4.31 |
| 意大利语 | 6.93 | 4.39 |
| 西班牙语(拉美) | 8.43 | 5.41 |
| 德语 | 12.69 | 6.26 |
| 日语 | 9.37 | 6.36 |
| 法语 | 17.10 | 7.61 |
| 中文 | 10.28 | 7.97 |
| 粤语 | 10.18 | 8.69 |
| 英语 | 13.83 | 8.80 |
| 葡萄牙语(巴西) | 10.85 | 9.35 |
两个苹果引擎都干净测到的全部语言,按 Apple Speech 的错误率排序;标绿的是该行更好的那个。同一轮测试,同一批片段,同一台 Mac。日语、韩语、中文和粤语为字错率,其余为词错率。
两个引擎都干净测到的十种语言,Apple Speech 全部更准。法语和德语少掉一半以上的错误,中位的那种语言少掉大约三分之一,巴西葡萄牙语和粤语大约每七个错误少掉一个。
听写覆盖的语言反而更多。这一轮里 Apple Speech 在 83 个语言配置中的 21 个上返回了结果,听写是 33 个,里面就有新引擎在这里缺的那三种:荷兰语、波兰语和俄语,成绩是 17.34、13.50 和 13.13。也没有一份固定的清单可以引用。语言资源属于 macOS,app 只能在运行时问这台机器上装了哪些。
既然这么强,能不能不装模型了?
六个引擎,同一批片段,同一台 Mac。下面这十种语言是最常用的十种,顺序是固定的,和成绩无关。
| 语言 | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| 英语 | 8.80 | 4.49 | 5.49 | 7.04 | 6.89 | 8.46 |
| 德语 | 6.26 | 2.85 | 4.05 | 8.67 | 6.26 | — |
| 荷兰语 | — | 7.36 | 5.69 | 16.75 | 8.58 | — |
| 俄语 | — | 5.65 | 5.13 | 11.37 | 7.12 | — |
| 波兰语 | — | 12.59 | 5.45 | 15.81 | 8.30 | — |
| 日语 | 6.36 | 5.74 | 5.30 | 11.37 | — | 6.78 |
| 韩语 | 4.31 | 3.54 | 4.25 | 7.30 | — | 7.85 |
| 法语 | 7.61 | 4.57 | 5.97 | 13.24 | 5.83 | — |
| 中文 | 7.97 | 6.49 | 7.97 | 20.50 | — | 7.69 |
| 西班牙语(拉美) | 5.41 | 3.38 | 3.62 | 6.22 | 4.86 | — |
十种最常用的语言,一个引擎一列。每一格是该引擎的错误率,越低越好;标绿的是该行最低,标白的是次低。日语、韩语和中文为字错率,其余为词错率,两者不合并成一个总分。Whisper Notes 团队自己跑的 FLEURS 测试,一台 M5 MacBook Air,朗读语音。
表头简称:Qwen3-ASR = Qwen3-ASR 1.7B,Whisper Large = Whisper Large V3 Turbo,Parakeet = Parakeet V3,SenseVoice = SenseVoice Small。破折号表示该引擎没有这种语言的模型。
十种语言里,Qwen3-ASR 1.7B 在六种上错误率最低,Whisper Large V3 Turbo 在另外四种上最低,Apple Speech 一种都没有。它离该行第一最近的是韩语,差 0.77 分,然后是日语的 1.06 分和中文的 1.48 分,中文上它和 Whisper Large V3 Turbo 打平,都是 7.97。差得最多的是英语,8.80(Apple Speech)对 4.49(Qwen3-ASR 1.7B);荷兰语、波兰语和俄语则完全没有 Apple Speech 的成绩。
跟 Whisper Small 比,双方都干净测到的十种语言里 Apple Speech 有八种更准。输掉的两种是英语,8.80(Apple Speech)对 7.04(Whisper Small);以及巴西葡萄牙语,9.35 对 8.61。
七月的一篇评测用英语把 Apple Speech 和 Whisper Small 放在一起比,结论是苹果更准。拿哪个 Whisper 来比重要,拿哪批音频来比同样重要。那一轮用的是 LibriSpeech,有声书朗读者念稿;我们用的是 FLEURS,很多不同的人朗读维基百科句子。我们这一轮只能显示英语上的这个差距,说不出它的成因。
换成 Whisper Large V3 Turbo,顺序就反过来了。这十种语言里 Apple Speech 输八种,中文以 7.97 打平,只在粤语上领先,8.69(Apple Speech)对 36.75(Whisper Large V3 Turbo)——粤语那一行在下面的表里。OpenAI 给 Turbo 写的发布说明里,粤语正是它退化最明显的语言之一,所以 36.75 是 Whisper 已知的短板,不是我们这一轮的偶然。
韩语上,Apple Speech 大约每 23 个字错一个。这一轮里最准的模型 Qwen3-ASR 1.7B 大约每 28 个字错一个:4.31(Apple Speech)对 3.54(Qwen3-ASR 1.7B)。
Parakeet V3 的下载体积是 465 MB,两者都覆盖的欧洲语言上它全都更准:英语 6.89(Parakeet V3)对 8.80(Apple Speech),法语 5.83 对 7.61,西班牙语 4.86 对 5.41,意大利语 3.43 对 4.39,巴西葡萄牙语 6.49 对 9.35,德语两者打平,都是 6.26。它没有日语、韩语、中文和粤语,而这几种正是两者之间只有 Apple Speech 有结果的语言。
Qwen3-ASR 1.7B 拿下的那六行里,包括英语、德语、法语和西班牙语。
SenseVoice Small 是这次最快的引擎,162.3 倍实时;中文和英语上它和 Apple Speech 打平,7.69(SenseVoice Small)对 7.97(Apple Speech)、8.46 对 8.80。韩语上它差得远,7.85(SenseVoice Small)对 4.31(Apple Speech)。
体积与速度
| 引擎 | 速度 | 峰值内存 | 下载体积 |
|---|---|---|---|
| SenseVoice Small | 162.3 倍实时 | 0.95 GiB | 827 MB |
| Parakeet V3 | 75.6 倍实时 | 0.09 GiB | 465 MB |
| Apple Speech | 30.8 倍实时 | 不报 | <5 MB |
| Qwen3-ASR 1.7B | 11.1 倍实时 | 2.43 GiB | 约 2.5 GB |
| Whisper Small | 7.9 倍实时 | 0.87 GiB | 600 MB |
| Whisper Large V3 Turbo | 3.0 倍实时 | 1.87 GiB | 约 1.6 GB |
速度取中位数,范围是本文干净测到的十三种语言里该引擎实际跑过的那些——单条隔离测量的处理吞吐,是诊断值,不是产品延迟。峰值内存是这一轮的进程组峰值。Apple Speech 的解码发生在调用方 app 管不着的 macOS 系统服务里,那一格填什么数字都和另外五个不是一回事。
Apple Speech 是 30.8 倍实时,慢于 Parakeet V3 的 75.6 倍和 SenseVoice Small 的 162.3 倍。它的语言包由 macOS 下载一次、各 app 共享,所以 app 自己的进程里不分配内存。负责解码的那个服务照样要用内存,我们没法把它精确归给谁,所以那一格不报数字,而不是报零。
Whisper Large V3 Turbo 是这次最慢的引擎,3.0 倍实时,同时在十行里拿下四个第一,磁盘上约 1.6 GB。Qwen3-ASR 1.7B 拿下另外六个,约 2.5 GB 下载、2.43 GiB 内存峰值。跟系统自带的引擎最有可比性的是 600 MB 的 Whisper Small。
Apple Speech 适用于哪些语言?
按语言来看:
- 英语:不适合。Apple Speech 的错误率是 8.80,对比之下 Qwen3-ASR 1.7B(4.49)或 Whisper Large V3 Turbo(5.49)明显更准。
- 德语:不适合。Apple Speech 的错误率是 6.26,对比之下 Qwen3-ASR 1.7B(2.85)或 Whisper Large V3 Turbo(4.05)明显更准。
- 荷兰语、俄语、波兰语:Apple Speech 没有这三种语言的模型。三种上最准的都是 Whisper Large V3 Turbo,分别是 5.69、5.13 和 5.45。
- 日语:可以用。Apple Speech 的错误率是 6.36,第一是 Whisper Large V3 Turbo 的 5.30。
- 韩语:可以用。Apple Speech 的错误率是 4.31,第一是 Qwen3-ASR 1.7B 的 3.54。
- 法语:不适合。Apple Speech 的错误率是 7.61,对比之下 Qwen3-ASR 1.7B(4.57)或 Parakeet V3(5.83)明显更准。
- 中文:可以用。Apple Speech 的错误率是 7.97,和 Whisper Large V3 Turbo 打平;最准的是 Qwen3-ASR 1.7B 的 6.49。
- 西班牙语:不适合。Apple Speech 的错误率是 5.41,对比之下 Qwen3-ASR 1.7B(3.38)或 Whisper Large V3 Turbo(3.62)明显更准。
准确率上赢的仍然是需要下载的模型:主表每一行的第一都是 Qwen3-ASR 1.7B 或 Whisper Large V3 Turbo。韩语、日语和中文上,Apple Speech 是一个实打实的选项;欧洲语言上该拿的是 Parakeet V3。
Mac 版 Whisper Notes 里,Parakeet V3 仍是默认。在从官网下载的 Mac 版里,macOS 26 及以上可以把 Apple Speech 选作模型,某种语言只有在 macOS 报告你这台 Mac 支持它时才会出现。
Apple Speech 是本文对苹果 SpeechTranscriber 的简称,任何 Mac app 都能调用的设备端 API,要求 macOS 26 及以上。它是系统的引擎,不是你要下载的模型:Mac 版 Whisper Notes 在从官网下载的版本里可以用它,语言包由 macOS 提供。app 自己下载的模型仍然是:这个版本是 Whisper、Parakeet V3、SenseVoice 和 Qwen3-ASR,iPhone 版和 Mac App Store 版是 Whisper、Parakeet V3 和 SenseVoice。分引擎的语言表见Whisper、Parakeet V3 和 SenseVoice 支持的语言列表。
十种之外的其他语言
| 语言 | Apple Speech | Qwen3-ASR | Whisper Large | Whisper Small | Parakeet | SenseVoice |
|---|---|---|---|---|---|---|
| 意大利语 | 4.39 | 2.58 | 2.58 | 7.64 | 3.43 | — |
| 粤语 | 8.69 | 6.44 | 36.75 | 119.01 | — | 37.23 |
| 葡萄牙语(巴西) | 9.35 | 5.17 | 5.44 | 8.61 | 6.49 | — |
| 印地语 | 101.50 | 13.19 | 29.64 | 61.26 | — | — |
同一轮里另外四种语言。引擎列、配色和简称同上;粤语为字错率,其余为词错率。
Apple Speech 的印地语成绩不参与该行排名,原因见下。错误率可以超过 100%,因为多出来的插入也算进分子。
意大利语 4.39(Apple Speech),排在 Qwen3-ASR 1.7B 和 Whisper Large V3 Turbo 那两个 2.58 的后面。粤语是 Apple Speech 唯一一个排在 Whisper Large V3 Turbo 前面的语言,8.69(Apple Speech)对 36.75(Whisper Large V3 Turbo),第一是 6.44 的 Qwen3-ASR 1.7B。巴西葡萄牙语 9.35(Apple Speech),是 Whisper Small(8.61)领先的两行之一。
印地语是另一类结果。Apple Speech 把印地语用英文字母拼了出来,而不是用印地语自己的文字写,所以几乎每个词都算错,错误率超过 100%。泰卢固语、乌尔都语、旁遮普语、孟加拉语、尼泊尔语、马拉雅拉姆语、马拉地语、卡纳达语、古吉拉特语和泰米尔语也是一样,错误率全部超过 100%,所以没有列进表里。
SpeechAnalyzer 是怎么工作的
SpeechAnalyzer 接替了苹果从 iOS 10 起就有的语音识别 API,除 watchOS 外的所有苹果平台都能用。app 创建一个 SpeechAnalyzer,给它挂上模块,再把音频以一个自己填充的异步序列送进去;把语音变成文字的那个模块叫 SpeechTranscriber。结果以另一个异步序列送回来,通常跑在另一个任务上,每一段缓冲和每一条结果都带着音频自身时间轴上的时间码。
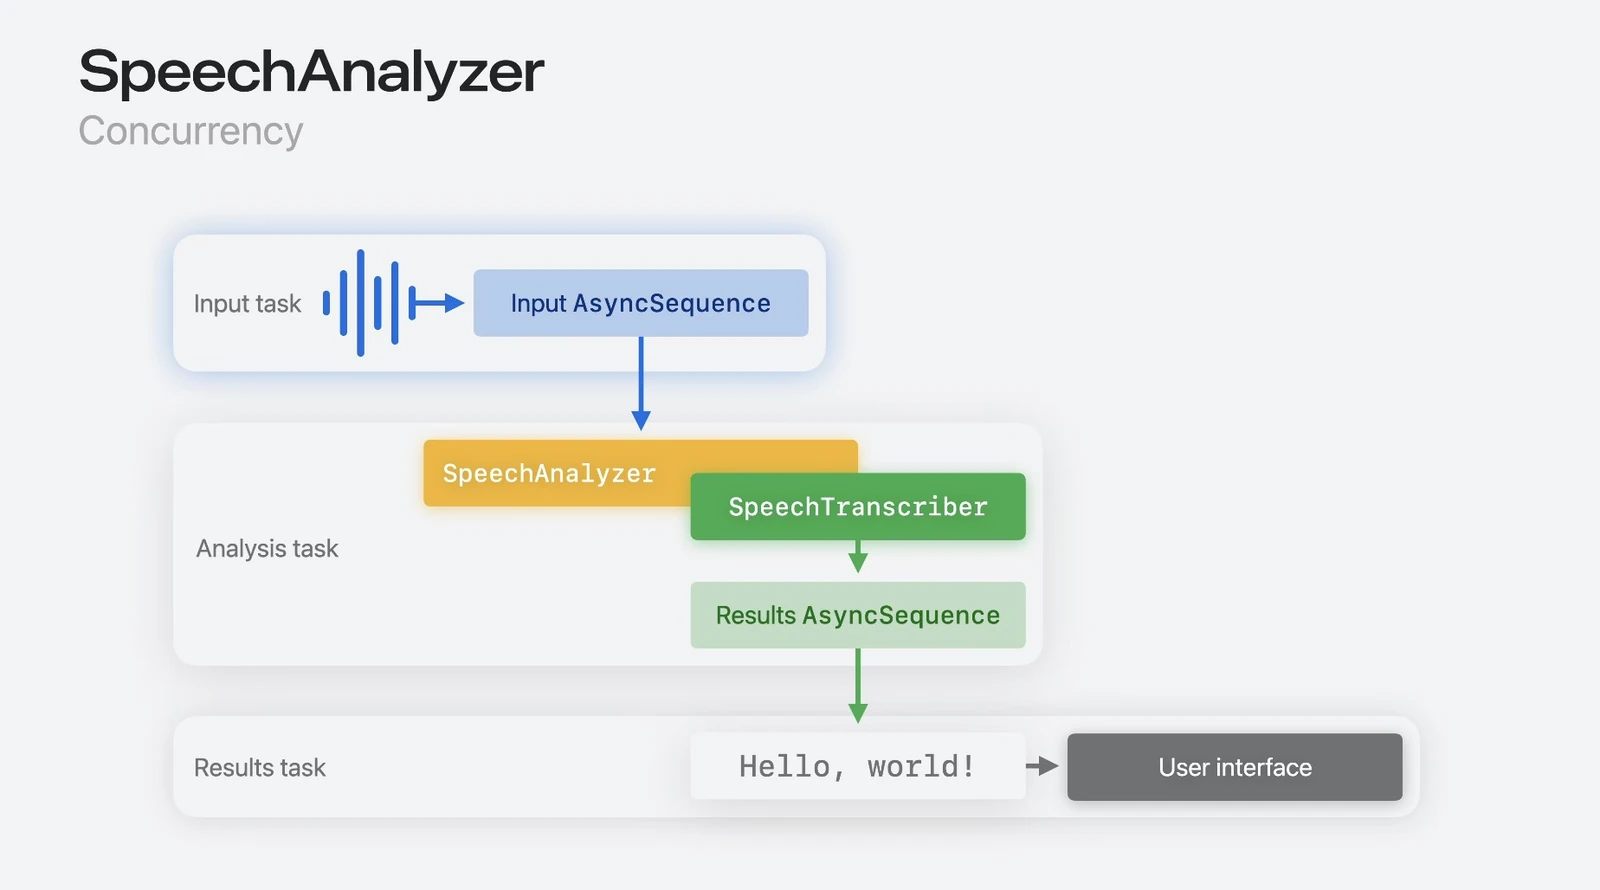
一次会话,三个任务:音频以 AsyncSequence 送入,SpeechAnalyzer 和 SpeechTranscriber 完成分析,结果以另一个 AsyncSequence 返回给界面。来源:Apple,WWDC25 第 277 场。
结果会到达两次。落在苹果所说的易变区间(volatile range)之内的内容还可能被更好的结果替换,落在区间之外的就是最终结果。app 因此可以在你还在说话时先给出一份粗糙的转写稿,之后再改正它。苹果为 SpeechTranscriber 模型列出了五个设计目标:长音频、对话式语音、远距离说话人、低延迟,以及隐私,也就是在设备上运行。备忘录、语音备忘录、日记和通话摘要都建立在它之上。
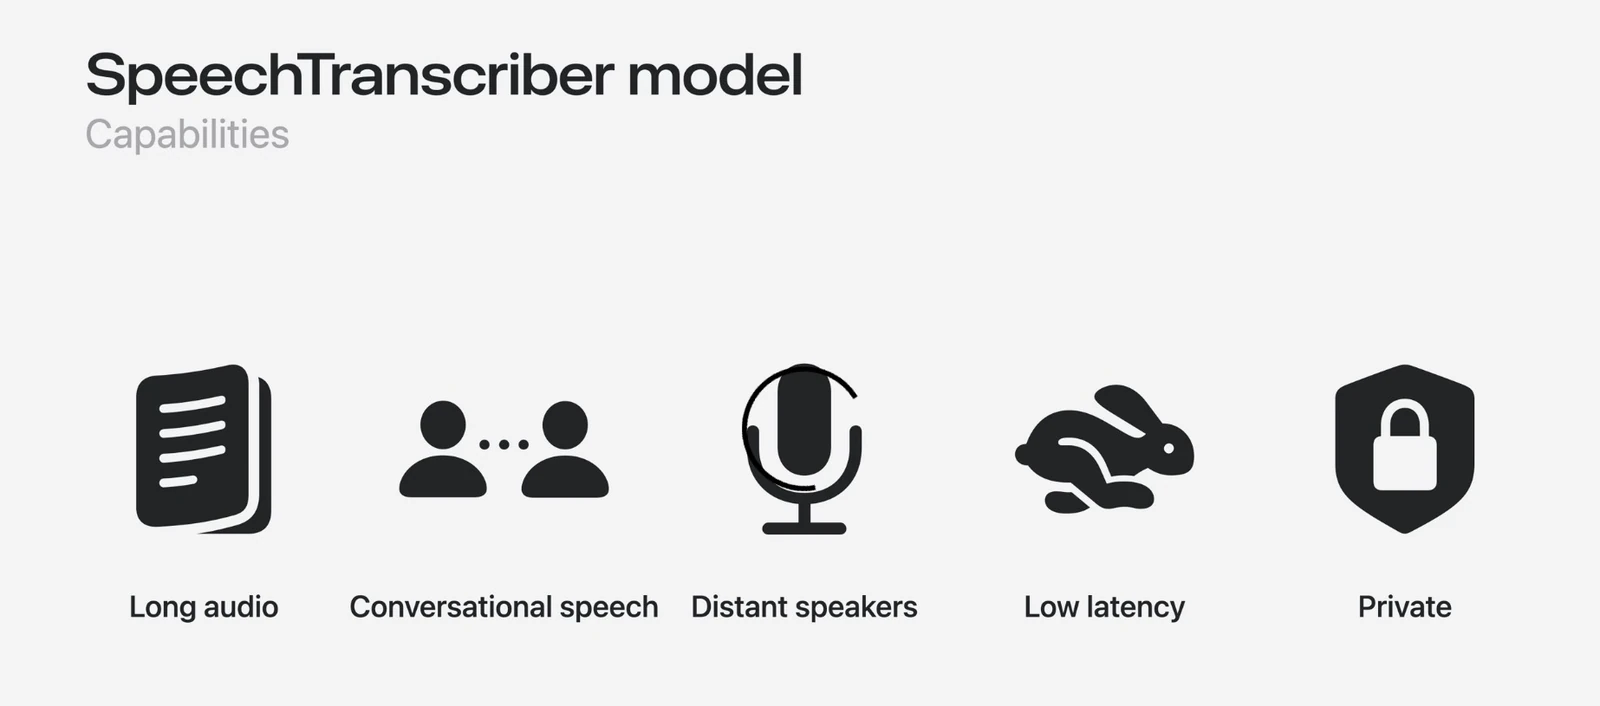
苹果为 SpeechTranscriber 模型列出的五个设计目标。来源:Apple,WWDC25 第 277 场。
模型不属于任何一个 app。它们通过 AssetInventory 从苹果的服务器下载,由系统存放和更新,并在各个 app 之间共享。它们不增加 app 的下载体积,解码也发生在调用方进程之外。当 SpeechTranscriber 在某个语言或某台设备上没有模型时,改由 DictationTranscriber 接手,用的是和系统听写相同的模型。
测试方法与局限
这些表里的六个引擎,有五个是 Whisper Notes 自己下载的模型。每个引擎听的是同一批片段、同样的顺序,一次只跑一条,机器是一台 M5 MacBook Air(32 GB,macOS 27.0)。音频是 Google FLEURS 测试集 70bb2e84 版,每种语言约 150 句、约 30 分钟。句子按数据集自带的条目 ID 做一次固定哈希排序,取刚好越过三十分钟的最短整条前缀,模型输出不参与这个选择。每一格都从它自己的收据重算并复核过,285 格全部通过。用空格分词的语言算词错率,日语、韩语、中文和粤语算字错率,两者不合并成一个总分。
Whisper 那两列可以拿 OpenAI 自己的数字核对。OpenAI 公布过 Whisper Large V3 Turbo 的 FLEURS 结果,那十二种语言上我们的数字和他们平均只差 0.7 分,其中十种落在我们这一轮测量的 95% 区间内;不算印度次大陆的那些语言,其余十一种语言里,Whisper Small 那列与 Whisper 论文里的逐语言表平均差 1.0 分。Apple Speech 那列出自同一批音频、同一套评分、同一套归一化。
FLEURS 是干净的朗读语音。这里的数字说不了这些引擎在嘈杂的房间里、在两小时的会议上会怎么样,它们在那种音频上怎么拉开差距,我们没有测。所有测试都在同一台机器上跑。每种语言约 150 句,两个引擎相差不到大约一分就该看作打平;表里对完全相同的分数就是这么标的,比如意大利语,Qwen3-ASR 1.7B 和 Whisper Large V3 Turbo 都是 2.58。
常见问题
Apple Speech 和 Whisper Small 谁更准?
双方都干净测到的十种语言里,Apple Speech 赢八种。输掉的是英语,8.80(Apple Speech)对 7.04(Whisper Small);以及巴西葡萄牙语,9.35 对 8.61。领先最多的是中文,7.97(Apple Speech)对 20.50(Whisper Small);法语,7.61 对 13.24;日语,6.36 对 11.37;粤语,8.69 对 119.01。Whisper Small 是 600 MB 的下载,速度 7.9 倍实时,Apple Speech 是 30.8 倍。
Apple Speech 和 Parakeet V3 谁更准?
两者都覆盖的欧洲语言上都是 Parakeet V3:英语 6.89(Parakeet V3)对 8.80(Apple Speech),法语 5.83 对 7.61,西班牙语 4.86 对 5.41,意大利语 3.43 对 4.39,巴西葡萄牙语 6.49 对 9.35,德语打平,都是 6.26。Parakeet V3 没有日语、韩语、中文和粤语,这几种里两者之间只有 Apple Speech 有结果。Parakeet V3 是 465 MB 的下载,速度 75.6 倍实时,Apple Speech 是 30.8 倍。
Apple Speech 和 Whisper Large V3 Turbo 谁更准?
双方都干净测到的十种语言里,Whisper Large V3 Turbo 赢八种:英语 5.49(Whisper Large V3 Turbo)对 8.80(Apple Speech),德语 4.05 对 6.26,日语 5.30 对 6.36,韩语 4.25 对 4.31,法语 5.97 对 7.61,西班牙语 3.62 对 5.41,意大利语 2.58 对 4.39,巴西葡萄牙语 5.44 对 9.35。中文打平,都是 7.97;Apple Speech 只在粤语领先,8.69(Apple Speech)对 36.75(Whisper Large V3 Turbo)。Turbo 还覆盖荷兰语、俄语和波兰语,分别是 5.69、5.13 和 5.45。它约 1.6 GB,也是这次最慢的引擎,3.0 倍实时。
Apple Speech 支持哪些语言?
这一轮在 83 个配置里有 21 个返回了结果:英语、德语、法语、西班牙语、意大利语、葡萄牙语(巴西)、日语、韩语、中文、粤语,以及十一种印度次大陆的语言——印地语、泰卢固语、乌尔都语、旁遮普语、孟加拉语、尼泊尔语、马拉雅拉姆语、马拉地语、卡纳达语、古吉拉特语和泰米尔语——这十一种回来的是用英文字母拼出来的,不是各自的文字。没有荷兰语、波兰语和俄语,清单由 macOS 按机器决定。它离第一最近的是韩语、日语和中文,分别差 0.77、1.06 和 1.48 分,差得最多的是英语,8.80(Apple Speech)对 4.49(Qwen3-ASR 1.7B);两个引擎都测到的十种语言上它都比旧的听写准。Whisper Notes 里的 Whisper 覆盖 app 语言表里的全部语言,每个渠道都有。
SpeechAnalyzer 是什么?它和苹果的听写是一回事吗?
SpeechAnalyzer 是苹果在 WWDC 2025 发布、随 macOS 26 和 iOS 26 交付的 API。SpeechTranscriber 是它里面的转录引擎,也就是本文说的 Apple Speech;听写是更旧的兼容引擎。两个我们都跑了,双方都干净测到的十种语言,Apple Speech 全部更准。听写覆盖的语言更多,33 个配置对 21 个,包括荷兰语、波兰语和俄语,词错率分别是 17.34%、13.50% 和 13.13%(听写),同一批片段上是 5.69%、5.45% 和 5.13%(Whisper Large V3 Turbo)。
用 Apple Speech 时音频会离开我的 Mac 吗?
苹果把 SpeechTranscriber 写成设备端语音识别:语言资源由 macOS 下载一次,识别本身在本地跑。我们这篇测的是准确率和速度,不是网络行为,所以这部分按苹果自己的说法转述。Whisper Notes 自己下载的那几个引擎——Whisper、Parakeet V3、SenseVoice 和 Qwen3-ASR——跑在你自己 Mac 的 GPU 或 Neural Engine 上,不需要账号,不需要 API key,断网也能转写,每个渠道都是如此。Apple Speech 在从官网下载的 Mac 版里、macOS 26 及以上可用:它是系统的引擎,跑在你自己的 Mac 上,语言包由 macOS 下载。
为什么这些数字和我在自己的录音上得到的准确率对不上?
因为 FLEURS 是短句、干净的朗读语音,而你的录音不是。我们这一轮是在公开数据集上做的校准:每种语言约 150 句、约 30 分钟,一台 M5 MacBook Air,所有引擎听同样的片段。它能判断某个引擎在你的语言上值不值得一试,但不能预测你在会议、噪声环境或两小时长文件上的准确率。
去试试
这次对比里需要下载的五个模型——Whisper Small、Whisper Large V3 Turbo、Parakeet V3、SenseVoice Small 和 Qwen3-ASR 1.7B——在从官网下载的 Mac 版 Whisper Notes 里都有,位置是设置 → 转录模型。macOS 26 及以上,Apple Speech 也在同一个列表里;已经装了 app 的话,更新到最新版即可。
某种语言上我们的数字和你的实际体验对不上,写信到 mac@whispernotes.app 告诉我们。完整更新说明:whispernotes.app/changelog。
数据来源:我们在 Google FLEURS 测试集 70bb2e84 版本上的测试、苹果的 SpeechAnalyzer 文档,以及在此之前那次三十种语言的 Qwen3-ASR 测试。
 下载 Mac 版