
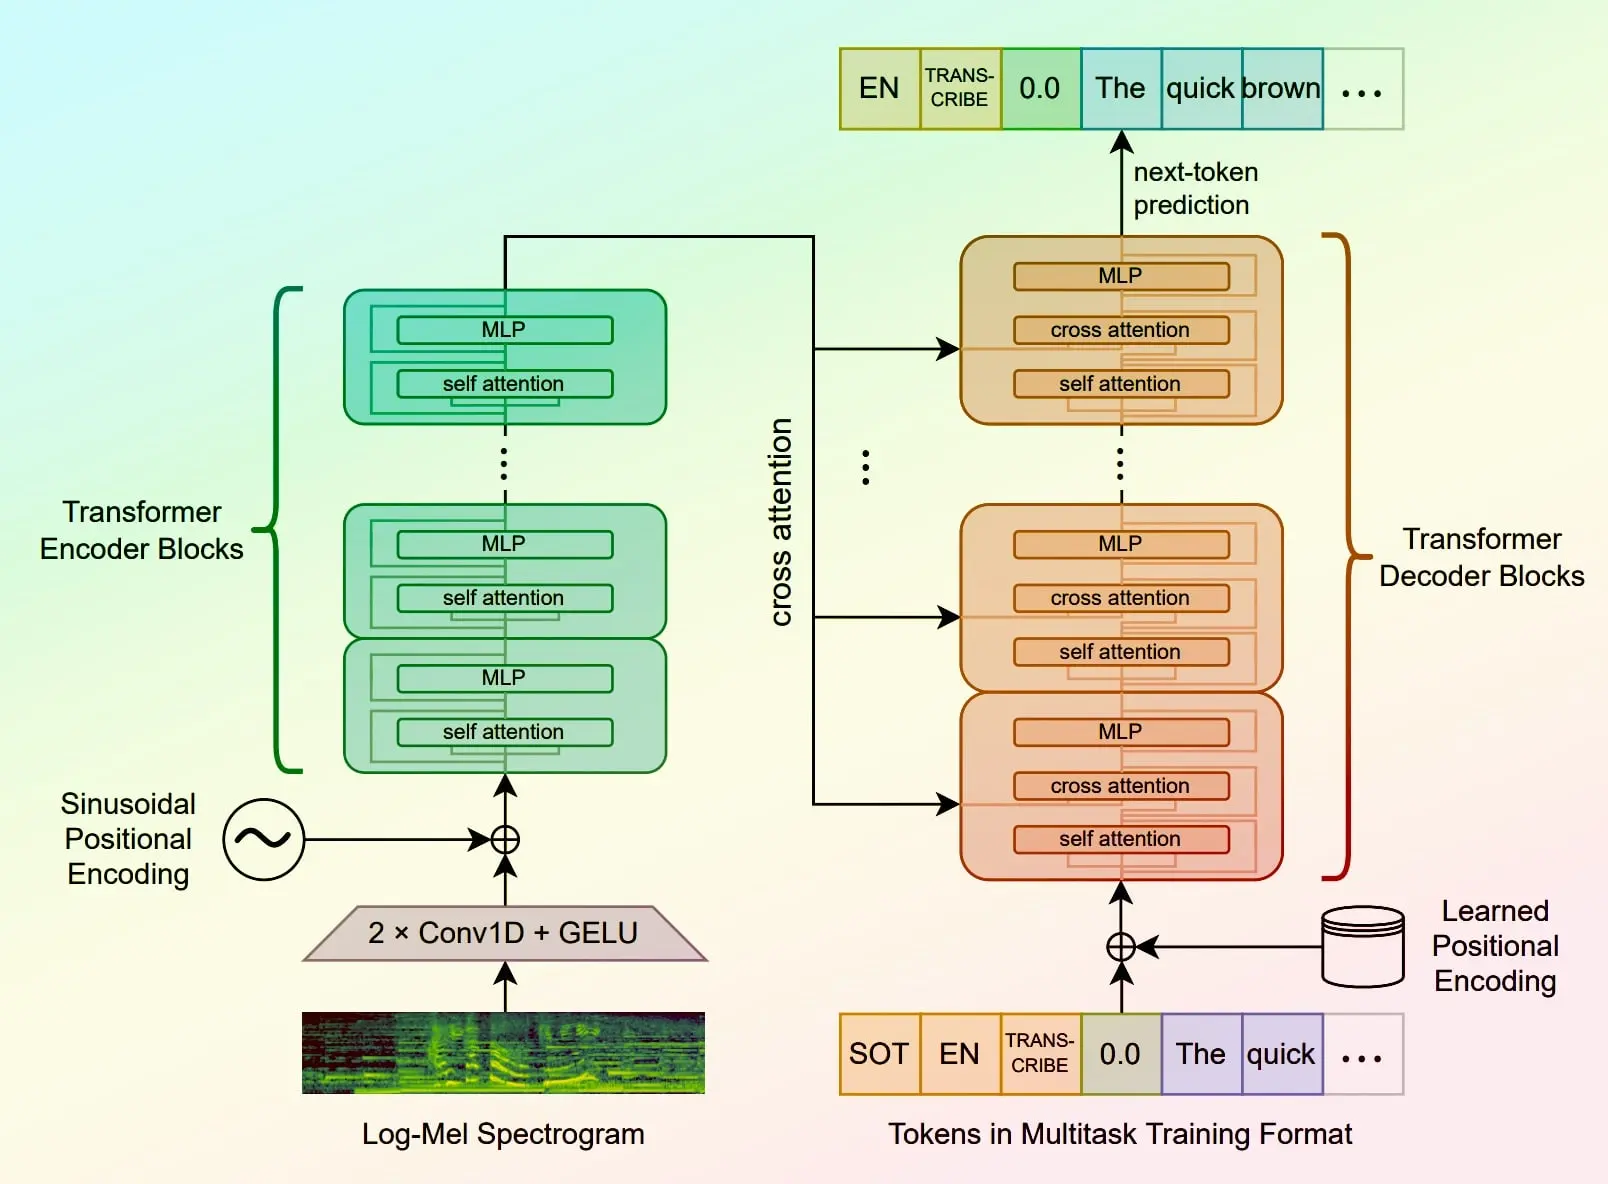
Le Whisper Large-v3 Turbo d'OpenAI (souvent appelé simplement Whisper Turbo) réduit le décodeur de 32 couches à 4, faisant passer les paramètres de 1,55B à 809M. Dans nos tests sur Apple Silicon, il a transcrit le même audio environ 5× plus vite avec une précision quasi identique. Whisper Notes l'intègre dans ses deux versions Mac, celle du Mac App Store comme l'app Mac de notre site, et le laisse volontairement de côté sur iPhone, où des modèles plus légers conviennent mieux.
V3 Turbo vs V3 : ce qui a changé
Turbo n'est pas une nouvelle architecture. C'est exactement le même modèle Whisper Large-v3 avec le décodeur élagué de 32 couches à 4, puis affiné (fine-tuned) pour récupérer la précision. L'encodeur reste inchangé.
| Large-v3 Turbo | Large-v3 | |
|---|---|---|
| Paramètres | 809M | 1,550M |
| Couches du décodeur | 4 | 32 |
| Langues | 100+ | 100+ |
| Tâche de traduction | Non supportée | Supportée |
| Licence | MIT | Apache 2.0 |
Méthode : le même fichier audio de 10 minutes a été transcrit dans la même version de Whisper Notes sur chaque appareil nommé. Les temps sont des secondes réelles, du lancement de la transcription au texte final ; seul le modèle a changé entre V3 et Turbo.
La tâche de traduction a été explicitement exclue des données d'entraînement de Turbo. Le modèle complet Large-v3 la supporte, mais Whisper Notes n'intègre que Turbo — dans l'app Mac de notre site, l'assistant IA peut traduire une transcription avec le modèle local Gemma.
Le modèle de base : qu'est-ce que Whisper Large-v3 ?
Whisper Large-v3 est le modèle phare de reconnaissance vocale open source d'OpenAI, publié en novembre 2023. Il compte 1,55B de paramètres, utilise une entrée spectrogramme à 128 bandes mel, a été entraîné sur 5 millions d'heures d'audio (1M faiblement étiquetées + 4M pseudo-étiquetées) et prend en charge plus de 100 langues. Sur le Hugging Face Open ASR Leaderboard, il obtient en moyenne ~7,4 % de taux d'erreur de mots — le plafond de précision auquel Turbo est comparé tout au long de cet article. Pour comparer Whisper Large V3 Turbo aux autres modèles de Whisper Notes, langue par langue, consultez notre comparaison des modèles Whisper.
Benchmark de vitesse : Whisper Notes sur Apple Silicon
Dans Whisper Notes pour Mac, Turbo fonctionne sur le Mac lui-même, principalement sur le GPU. Traitement de 10 minutes d'audio :
| Appareil | Whisper V3 | V3 Turbo | Accélération |
|---|---|---|---|
| iPhone 15 Pro | 425 s | 82 s | 5,2× |
| iPad Pro M2 | 380 s | 71 s | 5,4× |
| MacBook Pro M2 | 316 s | 63 s | 5,0× |
L'accélération de 5× est spécifique à Whisper Notes sur Apple Silicon. Sur GPU NVIDIA avec des frameworks comme faster-whisper, l'écart se réduit à ~2,7× (voir les benchmarks communautaires ci-dessous).
Une précision sur les lignes iPhone et iPad : ce sont des mesures du modèle sur ce matériel, pas la liste des modèles de l'app iPhone. Whisper Notes pour iPhone ne propose pas Large V3 Turbo, et c'est un choix délibéré, expliqué dans le tableau par appareil plus bas.
Précision : comparaison du WER
Le Hugging Face Open ASR Leaderboard teste les deux modèles sur les mêmes datasets en anglais. Le taux d'erreur de mots (WER) de Turbo reste à moins d'un demi-point de V3 sur chaque benchmark :
| Dataset | Whisper Large-v3 Turbo WER | Whisper Large-v3 WER |
|---|---|---|
| LibriSpeech Clean | 2.10% | 2.01% |
| LibriSpeech Other | 4.24% | 3.91% |
| GigaSpeech | 10.14% | 10.02% |
| Earnings22 | 11.63% | 11.29% |
| AMI | 16.13% | 15.95% |
| WER moyen | 7.83% | 7.44% |
V3 est légèrement plus précis sur chaque dataset, mais l'écart est faible — 0,39 point de pourcentage en moyenne. Pour la plupart des transcriptions réelles, vous n'entendrez pas la différence.
Sur l'évaluation longue durée YouTube-commons (l'un des plus grands benchmarks ASR open source), Turbo obtient 13,40 % de WER contre 13,20 % pour V3 — tout en fonctionnant à un facteur temps réel de 129,5× contre 55,3×. C'est 2,3× plus rapide avec une précision quasi identique sur de l'audio réel.
Quelle est la précision de Turbo en français, en coréen, en russe et dans d'autres langues ?
Les benchmarks ci-dessus concernent l'anglais. Selon la fiche de modèle d'OpenAI, le décodeur élagué à 4 couches de Turbo coûte un peu plus de précision dans les langues autres que l'anglais, avec la plus forte dégradation sur les langues à faibles ressources. Pour le français, le benchmark communautaire sur GPU présenté plus bas a justement été mené sur de l'audio en français : 7,7 % de WER pour Turbo contre 7,9 % pour Large-v3, en traitement par lots. Pour le russe et la plupart des langues européennes, Turbo reste proche du Large-v3 complet — et si vous utilisez Whisper Notes, le modèle Parakeet intégré (Parakeet Ultra de Moondream, post-entraîné à partir de NVIDIA Parakeet V3) couvre le russe et 24 autres langues européennes ; Parakeet V3 a tourné à environ 60× le temps réel sur Apple Silicon.
Pour le chinois, le japonais, le coréen et le cantonais, SenseVoice est bien plus rapide, à 115–131× le temps réel. Le modèle qui fait le moins d'erreurs dépend de la langue : sur notre série FLEURS, c'est Turbo en japonais, devant Qwen3-ASR 1.7B (Beta) et SenseVoice. En chinois, en coréen et en cantonais, c'est Qwen3-ASR 1.7B (Beta) sur Mac, et en coréen Turbo arrive deuxième, toujours devant SenseVoice. Whisper Notes propose SenseVoice sur iPhone comme sur Mac, où il côtoie Turbo, pour que vous puissiez choisir le bon modèle par langue au lieu de tout faire passer par un seul.
Turbo, Parakeet ou SenseVoice : quel modèle local choisir ?
Large-v3 Turbo est le modèle Whisper qui couvre le plus de langues parmi ceux qu'on peut faire tourner en local. Ce n'est pas pour autant le meilleur pour la plupart des usages : sur Apple Silicon, il a face à lui deux spécialistes qui le battent dans leurs propres langues. Dans Whisper Notes, la gamme sur Mac compte cinq modèles, identiques dans la version Mac App Store et dans l'app Mac de notre site : Parakeet, SenseVoice Small, Whisper Small, Whisper Large V3 Turbo et Qwen3-ASR 1.7B (Beta). Le choix dépend presque entièrement de la langue que vous parlez et de votre matériel, pas des classements.
Vous transcrivez de l'anglais, et seulement de l'anglais
Prenez Parakeet. Parakeet V3, le modèle dont il est issu, est à la fois plus précis et bien plus rapide : 6,32 % de WER moyen en anglais contre 7,83 % sur le Hugging Face Open ASR Leaderboard, et 103× le temps réel sur un M4 Pro, là où Turbo plafonne à 14,3× sur le même Mac. Pour de l'anglais seul, Turbo n'est jamais le meilleur choix.
Vous transcrivez du français ou une autre langue européenne
Toujours Parakeet, si votre langue fait partie de ses 25 : allemand, anglais, bulgare, croate, danois, espagnol, estonien, finnois, français, grec, hongrois, italien, letton, lituanien, maltais, néerlandais, polonais, portugais, roumain, russe, slovaque, slovène, suédois, tchèque et ukrainien. Sur ces 25 langues, Parakeet V3 obtient en moyenne 12,0 % de WER sur FLEURS, pratiquement au niveau du Whisper Large V3 complet (12,6 %), tout en tournant à environ 60× le temps réel sur Apple Silicon. Pour le français, notre comparatif des modèles langue par langue va dans le même sens : Parakeet y fait moins d'erreurs que Turbo, et sur Mac, Qwen3-ASR 1.7B (Beta) en fait encore un peu moins. Si votre langue européenne n'est pas dans la liste (le norvégien, l'islandais, le serbe et le catalan n'y sont pas), prenez Turbo.
Vous transcrivez du chinois, du japonais, du coréen ou du cantonais
Pour la vitesse, prenez SenseVoice Small. Il couvre l'anglais, le chinois simplifié et traditionnel, le cantonais, le japonais et le coréen, et sur ce type d'audio l'écart de vitesse saute aux yeux : un podcast chinois de 27 minutes a été transcrit en 13,83 secondes sur un M4 Pro, quand Turbo a mis plus de deux minutes sur le même fichier. Pour faire le moins d'erreurs possible sur Mac, prenez Whisper Large V3 Turbo en japonais et Qwen3-ASR 1.7B (Beta) en chinois, en coréen et en cantonais ; en coréen, Turbo arrive deuxième, toujours devant SenseVoice. Parakeet ne prend pas du tout ces langues en charge.
Vous avez besoin du plus grand nombre de langues
Prenez Whisper Large V3 Turbo. Il couvre 100 langues — arabe, hindi, thaï, hébreu, vietnamien, indonésien et toute la longue traîne qu'aucun des deux spécialistes ne couvre. En anglais, il reste à moins d'un demi-point du Large-v3 complet ; sur les langues à faibles ressources, l'écart est plus grand mais reste exploitable. C'est son rôle dans cette gamme : la solution de repli qui couvre toujours votre langue. Le détail par moteur se trouve dans notre tableau des langues prises en charge par Whisper.
Votre Mac est ancien ou manque de mémoire
Prenez Whisper Small. Il couvre les mêmes 100 langues pour un téléchargement d'environ 400 Mo, contre environ 2 Go pour Turbo. Sur un Mac de 8 Go où tourne aussi un navigateur, la différence se sent. Le prix à payer, c'est la précision, et il n'est pas mince : sur les 25 langues européennes de FLEURS, Whisper Small affiche 29,8 % de WER en moyenne, contre 12,0 % pour Parakeet V3. Choisissez-le quand la mémoire est la vraie contrainte, pas quand la précision compte.
Vous transcrivez de longs enregistrements — cours, audiences, entretiens de plusieurs heures
Prenez le modèle le plus rapide qui couvre votre langue, car le temps de transcription augmente avec la durée de l'audio. Un écart de vitesse invisible sur un mémo vocal de deux minutes devient, sur un enregistrement de trois heures, la différence entre une pause café et un après-midi. Réservez donc Turbo aux longs fichiers dont la langue l'exige vraiment, et comptez en minutes plutôt qu'en secondes. La durée accroît aussi l'autre risque de Whisper : plus le fichier est long, plus il contient de silences où un décodeur autorégressif peut inventer des mots. C'est pourquoi Whisper Notes repère les passages où quelqu'un parle avant de transcrire.
Les modèles côte à côte. Chaque chiffre de ce tableau vient de nos propres tests sur Apple Silicon ou des benchmarks publiés cités en dessous :
| Modèle | Langues | WER en anglais | Vitesse dans nos tests | Vitesse par rapport à Whisper Large V3 Turbo | Mémoire nécessaire | Téléchargement |
|---|---|---|---|---|---|---|
| Parakeet V3 | 25 européennes | 6,32 % | 103× le temps réel (M4 Pro) ; ~60× (M5 Air) | 7,2× plus rapide (103× contre 14,3×, M4 Pro) | 0,09 Gio en pic | 465 Mo |
| SenseVoice Small | anglais, chinois (simplifié et traditionnel), cantonais, japonais, coréen | Absent de cette série | Podcast chinois de 27 min en 13,83 s (M4 Pro) | 9,0× plus rapide (118× contre 13,1×, M4 Pro) | 0,95 Gio en pic | ~450 Mo |
| Whisper Small | 100 | Absent de cette série | ~4× le Large-v3 complet | Non mesuré sur le même audio | 0,87 Gio en pic | ~400 Mo |
| Whisper Large V3 Turbo | 100 | 7,83 % | 14,3× le temps réel (M4 Pro) ; ~5× le Large-v3 complet | Référence | 2,4 Go | ~2 Go |
Le WER en anglais est la moyenne sur les datasets anglais du Hugging Face Open ASR Leaderboard ; le vert marque le meilleur résultat de la colonne. SenseVoice Small et Whisper Small ne faisaient pas partie de cette série en anglais : nous laissons ces cases vides plutôt que de deviner. Sur la moyenne FLEURS des 25 langues européennes, les chiffres sont de 12,0 % pour Parakeet V3, 12,6 % pour le Whisper Large V3 complet et 29,8 % pour Whisper Small ; Turbo n'a pas été mesuré séparément sur ce jeu multilingue. Les vitesses sont des facteurs temps réel issus de nos propres mesures sur Apple Silicon, sauf les deux multiplicateurs exprimés par rapport au Large-v3 complet. Les tailles de téléchargement sont mesurées dans la version Mac de Whisper Notes. La mémoire est l'empreinte maximale du processus de chaque moteur dans notre série FLEURS sur un MacBook Air M5 ; Parakeet V3, SenseVoice Small et Whisper Small ont été mesurés ainsi. Les 2,4 Go de Whisper Large V3 Turbo correspondent à la mémoire de travail indiquée par l'app, pas à un pic que nous avons mesuré. Les deux rapports de vitesse sont calculés à partir de facteurs temps réel mesurés sur le même audio sur un M4 Pro : Parakeet V3 sur un fichier anglais de 5 minutes, SenseVoice Small sur un podcast chinois de 27 minutes ; Whisper Small n'a été chronométré sur aucun des deux. Le test du podcast a été fait sur une version antérieure de l'app ; la vitesse actuelle de SenseVoice Small indiquée sur sa fiche de modèle, 115–131×, est à peu près la même.
Tous ces modèles tournent entièrement sur l'appareil dans Whisper Notes, et vous choisissez le moteur dans les Réglages : l'app iPhone propose Parakeet, Whisper Small et SenseVoice Small ; les deux versions Mac y ajoutent Whisper Large V3 Turbo et Qwen3-ASR 1.7B (Beta).
La même gamme, dimensionnée pour chaque appareil
Ce que vous pouvez réellement charger dépend de l'appareil. Les deux versions Mac, celle du Mac App Store et l'app Mac de notre site, ont les mêmes modèles ; l'app iPhone en a moins :
| Modèle | App iPhone | Mac, les deux versions |
|---|---|---|
| Parakeet | Intégré | Inclus (par défaut) |
| SenseVoice Small | Téléchargement facultatif | Téléchargement facultatif |
| Whisper Small | Téléchargement facultatif | Téléchargement facultatif |
| Qwen3-ASR 1.7B (Beta) | Non proposé | Téléchargement facultatif (~2,5 Go ; macOS 15 ou ultérieur) |
| Apple Speech | Moteur système sous iOS 26 ; iOS télécharge le pack linguistique | Moteur système sous macOS 26 ou ultérieur ; macOS télécharge le pack linguistique |
| Whisper Large V3 Turbo | Non proposé, volontairement | Téléchargement facultatif (~2 Go) |
Cette dernière ligne est un choix produit, pas un oubli. Turbo pèse environ 2 Go au téléchargement et demande à peu près 2,4 Go de mémoire pendant qu'il tourne. C'est raisonnable sur un Mac Apple Silicon, beaucoup moins sur la plupart des iPhone, où le même stockage et la même mémoire permettent une gamme de modèles plus rapide et, dans ses propres langues, plus précise. L'app iPhone intègre donc Parakeet et propose Whisper Small et SenseVoice Small en téléchargement facultatif. Parakeet couvre les 25 langues européennes (6,32 % de WER en anglais), SenseVoice le chinois, le japonais, le coréen et le cantonais, et Whisper Small sert de solution de repli en 100 langues, qui tient sans peine dans la mémoire d'un téléphone. Des modèles adaptés à chaque appareil, plutôt que le même fichier de 2 Go partout où il tient techniquement.
Chaque modèle ci-dessus a aussi un point faible à connaître avant de l'adopter : voyez Ce que chaque modèle fait mal, plus bas. Pour tous les modèles côte à côte, avec les taux d'erreur dans 42 langues, consultez notre comparaison des modèles Whisper.
Benchmarks communautaires : GPU et CPU
Des benchmarks indépendants des communautés faster-whisper et whisper.cpp montrent des résultats cohérents sur différents matériels. Transcription de 13 minutes d'audio avec faster-whisper sur GPU :
| Modèle | Précision numérique | Temps | Mémoire GPU | WER |
|---|---|---|---|---|
| Large-v3 Turbo | fp16 | 19.2 s | 2,537 MB | 1.92% |
| Large-v3 | fp16 | 52.0 s | 4,521 MB | 2.88% |
| Large-v3 Turbo | int8 | 19.6 s | 1,545 MB | 1.92% |
| Distil-Large-v3 | fp16 | 26.1 s | 2,409 MB | 2.39% |
Source : benchmark faster-whisper sur GPU NVIDIA, split de validation propre de LibriSpeech. Turbo int8 n'utilise que 1,5 Go de VRAM — il tient dans un GPU de 2 Go.
L'inférence par lots sur une RTX 3060 Laptop (6 Go VRAM, précision int8) amplifie encore l'avantage :
| Modèle | Séquentiel | Par lots (10) | WER par lots |
|---|---|---|---|
| Large-v3 Turbo | 46.1 s | 18.7 s | 7.7% |
| Large-v3 | 230.8 s | 43.0 s | 7.9% |
| Large-v2 | 178.3 s | 43.2 s | 8.8% |
| Medium | 113.3 s | 26.3 s | 8.9% |
Source : benchmark NilaierMusic, Intel i7-12650H + RTX 3060 Laptop 6 Go, audio en français, précision int8.
Avec le traitement par lots, Turbo obtient le meilleur WER de tous les modèles testés (7,7 %) tout en étant le plus rapide. C'est le point d'équilibre évident pour une utilisation en production.
Turbo vs Medium vs toutes les tailles de modèle Whisper
Avant Turbo, Medium était le compromis habituel : une précision acceptable à une vitesse tolérable. Turbo rend cet arbitrage obsolète — avec 809M de paramètres, il est à peine plus gros que Medium (769M), tout en offrant une précision de classe large à plusieurs fois sa vitesse. Voici toute la famille de modèles côte à côte :
| Modèle | Paramètres | Taille sur disque | Vitesse relative | Niveau de précision |
|---|---|---|---|---|
| tiny | 39M | ~75 MB | ~10× | Le plus bas |
| base | 74M | ~142 MB | ~7× | Bas |
| small | 244M | ~466 MB | ~4× | Modéré |
| medium | 769M | ~1.5 GB | ~2× | Élevé |
| large-v3 | 1,550M | ~2.9 GB | 1× (référence) | Le plus élevé |
| large-v3-turbo | 809M | ~1.6 GB (fichier du modèle ; environ 2 Go à télécharger dans Whisper Notes) | ~5× sur Apple Silicon | Quasi maximal |
Publié le 30 septembre 2024, Turbo compte 809M de paramètres. Si vous choisissiez Medium pour économiser de l'espace disque ou gagner en vitesse, Turbo le bat désormais à la fois en précision et en vitesse pour une empreinte à peu près équivalente.
Whisper Notes ne propose que deux lignes de ce tableau : Whisper Small et Whisper Large V3 Turbo. Tiny, base et medium sont écartés volontairement, car sur Apple Silicon chacun est surpassé par un autre modèle de la gamme. Tout ce pour quoi vous auriez lancé tiny ou base, Parakeet le fait plus vite et bien plus précisément ; tout ce pour quoi vous auriez pris medium, Turbo le fait mieux pour une taille comparable. Whisper Small reste parce que c'est le plus petit modèle qui couvre les 100 langues.
Limitations connues (et comment Whisper Notes les gère)
Pas de traduction intégrée
Turbo a été entraîné sans données de traduction. Il ne transcrit que dans la langue source — contrairement à Large-v3, qui supporte la traduction audio vers anglais.
Whisper Notes — dans l'app Mac de notre site, activez les fonctions d'IA et le modèle local Gemma traduit une transcription dans la langue de votre choix, quel que soit le modèle de reconnaissance vocale qui l'a produite.
Plus d'hallucinations sur l'audio bruité
Les retours de la communauté indiquent que Turbo hallucine davantage sur les clips très courts ou les enregistrements bruités par rapport à V3. Prévisible vu le décodeur réduit (4 couches vs 32).
Whisper Notes — avant que Whisper ne transcrive, Silero VAD repère les segments de parole et saute les silences, pour que le modèle ne traite que de la voix réelle.
Ce que chaque modèle fait mal
Chaque modèle de cette gamme a un vrai point faible. Whisper, Small comme Large V3 Turbo, hallucine sur les silences. Son décodeur est autorégressif : il prédit le token suivant, qu'il reste ou non quelque chose à entendre. Un passage silencieux peut donc ressortir sous forme de phrase répétée, de mention de sous-titrage égarée ou de phrase fluide que personne n'a prononcée. Avec ses 4 couches, le décodeur de Turbo y est un peu plus sujet que le Large-v3 complet sur les clips très courts ou bruités. La détection d'activité vocale élimine l'essentiel du problème en n'envoyant jamais le silence au modèle, et Parakeet V3 a inventé beaucoup moins de mots dans nos tests sur le silence. Mais aucun modèle de reconnaissance vocale ne mérite un « jamais » : relisez toujours une transcription avant de vous y fier.
Parakeet a un plafond strict de 25 langues, toutes européennes. Pas de chinois, de japonais, de coréen, de cantonais, d'arabe, de hindi, de thaï ni d'hébreu. Si l'audio sort de ce périmètre, il ne vous prévient pas : il produit simplement un texte sans queue ni tête, avec aplomb. SenseVoice Small est encore plus restreint : anglais, chinois simplifié et traditionnel, cantonais, japonais et coréen, rien d'autre. C'est le modèle le plus rapide de la gamme sur l'audio pour lequel il a été conçu, et le mauvais outil pour tout le reste. Whisper Small est le moins gourmand et le moins précis : 29,8 % de WER en moyenne sur les 25 langues européennes de FLEURS, contre 12,0 % pour Parakeet V3. Cela se voit d'abord sur les noms propres, le vocabulaire technique et les accents.
Et tous demandent du stockage et du matériel. Ce sont de vrais fichiers sur votre disque, pas un appel d'API : Turbo représente un téléchargement d'environ 2 Go et occupe à peu près 2,4 Go de mémoire pendant la transcription, SenseVoice Small environ 450 Mo, Whisper Small environ 400 Mo, et Parakeet est intégré à l'app. La gamme est conçue pour Apple Silicon : macOS 14 ou ultérieur sur M1 et plus récent, iOS 18 ou ultérieur sur iPhone ; la version Mac App Store s'installe aussi sur les Mac Intel, sans SenseVoice, Qwen3-ASR, Apple Speech ni la transcription en direct rapide. Il n'existe pas de version Windows ni Android, et Whisper Notes n'est pas un outil de sous-titrage en direct : la transcription complète arrive une fois l'enregistrement arrêté. Pendant que vous enregistrez sur iPhone, ou que vous enregistrez une réunion sur Mac, une transcription en direct affiche les mots en quelques secondes dans les 25 langues européennes de Parakeet ; sur Mac, dans les autres langues, le texte se met à jour toutes les 30 secondes environ.
Quel modèle devriez-vous utiliser ?
| Anglais / Européen | Parakeet V3 — environ 60× le temps réel sur Apple Silicon, et 6.32% de WER en anglais contre 7.83% pour Turbo |
| Chinois / Japonais / Coréen | SenseVoice pour la vitesse, 115–131× le temps réel ; pour le moins d'erreurs sur Mac, Whisper Large V3 Turbo en japonais et Qwen3-ASR 1.7B (Beta) en chinois et en coréen |
| Autres langues | Whisper Large V3 Turbo — plus de 100 langues, haute précision, plus lent |
| Mac ancien / peu de mémoire | Whisper Small — 100 langues pour un téléchargement d'environ 400 Mo, au prix d'une vraie perte de précision |
| Sur iPhone | Parakeet intégré, Whisper Small et SenseVoice en téléchargement facultatif ; Turbo est réservé au Mac, volontairement |
FAQ Whisper Large-v3 Turbo
Quel modèle local de reconnaissance vocale choisir ?
Cela dépend de votre langue, pas des classements. Pour l'anglais, Parakeet V3 est à la fois plus rapide et plus précis que Whisper Large V3 Turbo (6,32 % contre 7,83 % de WER moyen en anglais sur le Hugging Face Open ASR Leaderboard ; 103× contre 14,3× le temps réel sur le même M4 Pro). Pour le français et les autres langues européennes de Parakeet, il reste le choix par défaut : il est bien plus rapide et, en français, il fait moins d'erreurs que Turbo. Pour le chinois, le japonais, le coréen ou le cantonais, SenseVoice Small est l'option rapide (un podcast chinois de 27 minutes en 13,83 secondes). Pour faire le moins d'erreurs sur Mac, prenez Whisper Large V3 Turbo en japonais et Qwen3-ASR 1.7B (Beta) en chinois, en coréen et en cantonais. Pour les autres langues parmi les 100 de Whisper, comme l'arabe, le hindi ou le thaï, Whisper Large V3 Turbo est le bon choix. Sur une machine ancienne ou à court de mémoire, Whisper Small couvre les mêmes 100 langues pour un téléchargement d'environ 400 Mo, au prix d'une vraie perte de précision.
Peut-on utiliser Whisper Large V3 Turbo sur iPhone ?
Pas dans Whisper Notes, et c'est voulu. Turbo représente un téléchargement d'environ 2 Go et occupe à peu près 2,4 Go de mémoire pendant la transcription : raisonnable sur un Mac Apple Silicon, du gaspillage sur un téléphone. L'app iPhone intègre Parakeet et propose Whisper Small et SenseVoice Small en téléchargement facultatif, ce qui couvre 100 langues, dont le chinois, le japonais et le coréen, pour une fraction de l'encombrement. Whisper Large V3 Turbo est disponible dans les deux versions Mac : celle du Mac App Store et celle de notre site.
Quelle est la différence entre Whisper Large-v3 et Large-v3 Turbo ?
Large-v3 Turbo conserve l'encodeur de Large-v3 mais réduit le décodeur de 32 couches à 4. C'est pourquoi il est beaucoup plus rapide tout en restant proche de la précision de Large-v3 pour la transcription. La contrepartie est que Turbo ne supporte pas la tâche de traduction intégrée de Whisper.
faster-whisper supporte-t-il Large-v3 Turbo ?
Oui. faster-whisper supporte Large-v3 Turbo via des conversions CTranslate2, et les benchmarks communautaires montrent que Turbo est un excellent choix quand la VRAM est limitée. Dans le benchmark ci-dessus, Turbo int8 a utilisé environ 1,5 Go de VRAM.
whisper.cpp supporte-t-il Large-v3 Turbo ?
Oui. whisper.cpp peut exécuter des versions GGML/GGUF converties de Whisper Large-v3 Turbo. Si vous construisez votre propre pipeline de transcription locale, Turbo est souvent plus facile à faire tenir sur du matériel grand public que le Large-v3 complet.
Où télécharger openai/whisper-large-v3-turbo ?
Les poids officiels du modèle sont disponibles auprès d'OpenAI sur Hugging Face. Les utilisateurs de Whisper Notes n'ont pas besoin de les télécharger manuellement : l'app Mac gère la configuration du modèle local via son interface.
Vous comparez toutes les options locales ? Chaque modèle de reconnaissance vocale de Whisper Notes, de Parakeet et Whisper à Qwen3-ASR et SenseVoice, est comparé langue par langue sur notre page de comparaison des modèles Whisper. Vous découvrez Whisper ? Commencez par le guide de transcription Whisper — ce qu'est le modèle, toutes les façons de l'exécuter et ce que cela coûte.
